黄仁勋GTC现场力推Lex:从液冷到Token经济学
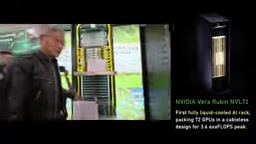
黄仁勋在GTC现场借Lex Fridman互动,抛出液冷、Token经济学等AI基础设施关键判断。
黄仁勋在GTC大会现场与播客主持人Lex Fridman同台互动,表面是社交场面,实则延续其人格化技术传播策略。在展台前,他披露了Grace Blackwell的关键工程数据:实现100%液冷(上一代为80%),组装时间从两小时压缩至五分钟,已全面量产。话题转向Vera CPU时,黄仁勋提出AI时代CPU经济学正从"租核心"转向"生成Token",Vera在x86对比中达1.8倍性能。他重申"The more you buy, the more you make"的销售哲学,并用"AI is a five-layer cake"比喻技术栈分层。这些片段共同指向一个判断:AI基础设施的竞争维度正从硬件规格转向系统效率与Token产出率。
在GTC大会现场,黄仁勋又一次成为全场焦点。这一次,他身边多了一位特别来宾——知名播客主持人Lex Fridman。据YouTube现场视频记录,黄仁勋在展台前向围观人群高声介绍Lex,场面一度热闹非凡。两人不仅同台互动,Lex还在现场留下了签名。这场看似轻松的社交时刻,背后却藏着黄仁勋对AI基础设施走向的几个关键判断。
黄仁勋现场"带货"Lex:社交背后的技术叙事
视频开场,黄仁勋指着身旁的Lex对人群说:"Does everybody know the famous Lex Fridman?"随后又调侃Lex的播客"非常非常长",但"你能学到很多"。Lex此行专程飞抵现场,黄仁勋表示两人将"hang out for a couple of days"。
这段互动之所以值得关注,不只因为两位科技圈人物的同框。黄仁勋选择在展台前、在媒体镜头下完成这次"推介",本质上延续了他一贯的传播策略:把技术发布嵌入人格化叙事。Lex的播客以深度长访谈著称,受众恰好是AI技术圈的核心人群。黄仁勋用一句"你学到了很多"完成了对目标受众的精准触达。
从80%到100%液冷:Grace Blackwell的工程跃迁
热闹之外,黄仁勋在展台前给出的技术细节更值得记录。他指着眼前的设备说:"No cables, no hoses, 100% liquid cooled."并对比上一代Grace Blackwell——当时只有80%采用液冷。
更具冲击力的数据是组装时间:从上一代的两小时缩短到现在的五分钟。黄仁勋对此的解释是:"Things that are easy to build are also reliable."这句话看似朴素,实则点出了大规模AI部署的核心痛点。当集群规模从千卡走向十万卡级别,装配效率和可靠性不再是工程细节,而是决定交付周期的关键变量。液冷覆盖率的提升和组装时间的压缩,直接指向更低的运维复杂度和更高的系统稳定性。黄仁勋同时确认,该产品已"officially in full production"。
液冷与风冷的区别及为何AI集群偏爱液冷:传统数据中心长期依赖风冷——用风扇把冷空气吹过服务器散热片带走热量。但AI训练集群的功率密度远超传统服务器:单颗Blackwell GPU功耗可达上千瓦,一个机柜的整体功耗轻松突破100千瓦,而风冷机柜通常只能应对20-30千瓦。液冷通过冷板(cold plate)直接贴合芯片,用循环冷却液带走热量,散热效率是空气的数倍,还能大幅降低风扇能耗和噪音。黄仁勋所说的"no cables, no hoses"指的是新一代设计将线缆和管路集成到机柜背板或主板级连接中,减少了人工接线的环节,这也是组装时间能从两小时压缩到五分钟的关键原因之一。
Grace Blackwell是什么:Grace Blackwell是英伟达推出的超级芯片平台,由Grace CPU和Blackwell GPU通过高速片间互连(NVLink-C2C)整合而成。Grace负责通用计算和内存管理,Blackwell负责AI训练与推理,两者共享统一内存空间,避免了传统CPU-GPU之间通过PCIe搬运数据的瓶颈。这种架构专为超大规模AI模型设计,是英伟达从"卖GPU"转向"卖整机系统"的代表产品。
Vera CPU与Token经济学:黄仁勋的商业逻辑
话题转向Vera CPU时,黄仁勋抛出了一个更根本的判断。他提到Vera在x86对比中达到1.8倍性能,但重点不在于数字本身,而在于商业逻辑的切换。
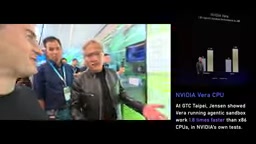
他的原话是:"x86 CPUs, the hyperscale CPUs were designed to be rented."在传统云计算时代,CPU的经济学是"每核心多少钱",所以核心越多越好。但在AI时代,"AI doesn't rent cores. AI generates tokens and they sell tokens."这意味着衡量标准从核心数转向了Token生成速度。CPU的设计目标随之改变:不再是堆核心,而是以最快速度完成"输入-生成-输出"的循环。
这一判断如果成立,对超大规模数据中心的意义是结构性的。过去围绕核心数优化的芯片架构、调度系统和计费模型,都需要围绕Token吞吐重新校准。
什么是Token:Token是AI模型处理文本的基本单位,可以粗略理解为一个词或词的一部分。当用户向AI提问时,模型先把输入拆成Token,再逐个生成输出Token。AI服务的计费通常按Token数量计算——输入Token和输出Token分别定价。因此"Token生成速度"直接决定了单张GPU或单颗CPU能产生多少收入。黄仁勋所说的"AI generates tokens and they sell tokens",指的就是这个从算力到收入的转化链条。
Vera CPU的背景:Vera是英伟达在Grace之后推出的新一代自研CPU,专为AI数据中心设计。传统x86 CPU(如英特尔至强、AMD EPYC)的核心设计目标是通用计算和多任务处理,核心数越多越能同时服务更多租户。而Vera的设计目标不同:它需要以最快速度协调GPU完成"接收输入Token—模型推理—输出Token"的循环,因此更看重单线程性能、内存带宽和与GPU的互连效率,而非单纯堆核心数。1.8倍性能对比指的应是在特定AI工作负载下相对x86方案的吞吐优势。
"The more you buy, the more you make":一句话概括黄氏销售哲学
黄仁勋在现场重复了那句已经被广泛引用的话:"The more you buy, the more you make."他甚至自嘲"你可能是世界上最好的销售员",而黄仁勋回应:"That's a good line. It's easy."
这句话的背后是黄仁勋对AI算力投入产出比的笃定。技术是复杂的,但商业模型被他刻意简化为一句话:买得越多,产出越多。这种表述在股东和客户两端都极具穿透力,也解释了为什么他在GTC现场乐此不疲地重复。从传播角度看,这是一次教科书级别的技术营销——把复杂的技术叙事压缩成一句可被引用、可被传播的口号。
值得一提的是,黄仁勋在对话中还用"AI is a five-layer cake"来比喻AI的技术栈分层,尽管视频中他很快被现场递来的蛋糕转移了注意力。这个比喻本身值得玩味:AI产业从芯片到应用确实存在多层结构,而英伟达目前牢牢占据着最底层、也最难以替代的那一层。
编辑观点
这段现场视频的信息密度并不均匀。Lex Fridman的出场提供了社交传播素材,但真正有分析价值的是黄仁勋在几分钟内密集抛出的几个判断:液冷从80%到100%的工程进步、组装时间从两小时到五分钟的效率跃迁、CPU从"租核心"到"产Token"的经济学切换,以及那句被反复引用的销售金句。这些片段拼在一起,呈现的是一套完整的叙事——AI基础设施的竞争维度正在从硬件规格转向系统效率和Token产出率。黄仁勋在现场的每一句话,都不是随口说说。
背景补充
超大规模数据中心(Hyperscale)的商业模式:黄仁勋提到的"hyperscale CPUs were designed to be rented"指向的是亚马逊AWS、微软Azure、谷歌云等超大规模云厂商的运营模式。这些厂商采购大量服务器,按虚拟CPU核心数或实例时长出租给客户,收入公式是"核心数×出租率×单价"。在这种模式下,芯片厂商卖的是硬件,云厂商卖的是算力租用权。而AI时代出现了新变化:云厂商开始按Token计费提供AI推理服务(如OpenAI API、AWS Bedrock),收入直接与Token吞吐量挂钩。这意味着数据中心的投资回报率不再取决于能同时跑多少个虚拟机,而取决于每秒能生成多少Token。这一转变正在倒逼从芯片架构到机房供电散热的全链条重新设计。
相关推荐

2026年AI编程工具横评:Claude、ChatGPT、Gemini谁最强?
2026年五款主流AI编程工具横评:Claude Code、ChatGPT Codex、Gemini、DeepSeek和GitHub Copilot在真实项目、定价与代码质量上的全面对比,帮你决定每月20美元该花给谁。

ChatGPT Codex克隆任意软件?实测风险与真相
YouTube短视频宣称用ChatGPT Codex或Claude Code即可克隆Adobe、Excel、Figma等软件并终身免费使用。本文拆解其技术可行性、法律风险与私信引流套路,说明AI编程工具真正适合的用法。

Kilo Code免费安装但API收费:成本估算与配置指南
Kilo Code 开源 AI 编程代理安装免费,但接入的 AI 模型按 token 收费。本文详解 VS Code 扩展与 CLI 配置步骤,并用假设用量演示 API 成本估算方法,对比按量付费与订阅制的选择逻辑。