黄仁勋台湾被工程师围堵:Lex Fridman镜头下的AI狂热

黄仁勋台湾之行折射AI硬件竞赛:液冷、Token经济与HBM瓶颈
Lex Fridman镜头下的黄仁勋台湾之行,表面是工程师追星现场,实则记录了AI基础设施竞赛的关键信号。新一代系统实现100%液冷,装配时间从两小时压缩至五分钟并全面投产;黄仁勋提出CPU设计逻辑的根本转变——AI时代不租核心而生成Token,计价单位从核心数转向吞吐量;HBM内存供应持续紧张,SK海力士成为算力链条的关键瓶颈。他还预测未来以语音控制为主,而Lex Fridman则认为打字更利于深度思考。这场非正式交流揭示了AI时代注意力正流向掌握算力基础设施的人。
当黄仁勋走进台湾:一场工程师的追星现场
Lex Fridman的镜头记录了一个有趣的场景:黄仁勋在台湾被一群工程师团团围住,人群高喊"我爱你",场面堪比摇滚明星巡演。有人调侃说,黄仁勋在台湾就像60年代的披头士——只不过披头士真的会唱歌。
这段视频的价值不在于明星效应,而在于它捕捉到了AI硬件竞赛最前线的真实氛围。当全球最关键的AI芯片供应链核心人物走在台湾的街头和会场,工程师们的反应折射出一个事实:AI基础设施的竞争已经渗透到产业毛细血管。
100%液冷:从工程细节看AI硬件的演进节奏
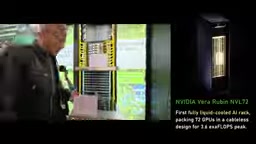
黄仁勋在视频中展示了一个关键迭代:新一代系统实现了100%液冷,而上一代Grace Blackwell只有80%液冷。这个数字变化背后是一个被反复验证的工程哲学——"容易构建的东西也可靠"。
装配时间从两小时压缩到五分钟。这个变化的意义远超效率提升本身。在AI算力需求爆发式增长的背景下,交付速度直接决定了数据中心的上线节奏。当芯片供应本身已经成为瓶颈时,系统集成的速度就成了另一个关键变量。
黄仁勋确认该系统已"正式全面投产"。这意味着从设计到量产的闭环已经完成,接下来考验的是供应链的吞吐能力。
液冷在AI服务器领域的普及,源于风冷散热能力与GPU功耗增长之间的剪刀差。传统数据中心主要依赖冷风穿过服务器带走热量,但当单颗AI加速卡的功耗突破700瓦、单机柜功耗逼近100千瓦时,空气的比热容和风道效率已不足以在合理能耗下完成散热。液冷通过在发热元件表面直接贴装冷板、让冷却液循环带走热量,其导热效率通常是空气的数十倍,可以在更小的体积内处理更高的热密度。
从80%到100%液冷,看似只是一个百分比的变化,实际上涉及整机架构的重新设计:剩余依靠风冷的部分往往是内存、电源、网络芯片等周边组件,要实现全覆盖,需要重新考虑每一颗发热器件的冷板布局、管路走线、漏液检测与快接头可靠性。这也是装配时间能从两小时压缩到五分钟的原因之一——模块化液冷管路让整机装配更接近即插即用,而不是逐根接管。
AI不需要租核心,AI生成Token
视频中最值得玩味的一段对话,是黄仁勋对CPU经济学重构的阐述。
他指出了一个根本性的范式转移:x86时代的超大规模CPU设计逻辑是"被租赁"的,核心越多越好,因为计价单位是"每核心多少钱"。但在AI时代,这个逻辑失效了——"AI不租核心,AI生成Token,然后卖Token"。
这意味着CPU的设计目标从"堆核心数"转向"以最快速度完成生成Token的循环"。黄仁勋用一句极其直白的话总结了这个商业模型:"你买得越多,你赚得越多。"
Lex Fridman称他是"世界上最好的销售员",黄仁勋没有否认,只是说"技术很复杂,但商业模型不复杂"。这或许是理解NVIDIA战略的一把钥匙。
要理解黄仁勋所说的范式转移,需要先厘清云计算时代的CPU计价逻辑。在传统的虚拟化数据中心中,一颗物理CPU被切分成多个虚拟核心出租给不同租户,云厂商按vCPU数量和使用时长收费,因此CPU设计的目标是塞进更多核心、支持更多并发线程,以提升单颗芯片的"可分租"价值。
AI推理则完全是另一种负载形态:用户请求的是一条prompt,系统输出的是按Token计费的结果。在这个过程中,CPU主要承担数据预处理、调度、采样等辅助任务,真正的矩阵运算由GPU或专用加速器完成。因此CPU的价值不再是"能同时容纳多少租户",而是"能多快把数据喂给加速器、多快完成一轮生成循环"。当推理定价以每百万Token为单位时,吞吐量而非核心数才直接对应收入——这正是黄仁勋"你买得越多,你赚得越多"商业逻辑的技术基础。
五层蛋糕与HBM:AI产业链的具象化
黄仁勋在交流中提到了"AI是一个五层蛋糕"的比喻。这个框架虽然原始素材中没有展开每一层的细节,但其意图清晰:AI不是一个单一技术,而是一个从底层硬件到上层应用的堆叠结构。
视频中SK海力士的片段进一步印证了这一点。黄仁勋在SK海力士的展台前停留,称其为"传奇的高带宽内存公司",并提到了LPDDR内存进入数据中心的技术路径——"两倍带宽,一半功耗"。他反复说"请多生产一些",语气半开玩笑,但背后的供需紧张是真实的。
"供给太紧了,内存太大了"——这句话在视频中出现了多次,既是玩笑也是事实陈述。
高带宽内存(HBM)是AI加速卡上最昂贵的单一组件之一,其原理是把多层DRAM芯片通过硅通孔垂直堆叠,再经由硅中介层与GPU封装在一起,从而在极短的距离内实现TB/s级别的带宽。相比传统通过内存总线外挂的DDR内存,HBM的功耗更低、带宽高出数倍,代价是制造工艺复杂、良率低、产能扩张缓慢。
这解释了为什么HBM会成为AI算力链条中最紧的瓶颈。一颗高端AI加速卡需要搭载多颗HBM堆栈,而全球能稳定量产HBM的厂商屈指可数,SK海力士凭借先发优势占据了最大份额。黄仁勋在SK海力士展台前反复说"请多生产一些",并非客套——即便GPU产能充足,HBM供给不足同样会卡住整机出货。由此也能理解他提到的LPDDR进入数据中心这条路径:用手机领域成熟的低功耗内存方案,以"两倍带宽、一半功耗"的折中方式,为推理场景提供HBM之外的第二条内存供给曲线。
Lex Fridman的播客与黄仁勋的"人设"
黄仁勋在视频中主动提到Lex Fridman的播客——"很棒的播客,非常非常长"。这个细节看似闲聊,实则反映了AI领域信息传播的一个特征:超长对话正在成为技术思想传播的主要载体。
Lex Fridman此次是专程飞到台湾与黄仁勋见面,不是"恰好路过"。两人计划共度数天,黄仁勋说要带他看看台湾。这种非正式交流场景,往往比正式发布会更能暴露行业领袖的真实思考。
语音控制的未来与思考速度的悖论
视频结尾有一段颇具哲学意味的对话。黄仁勋预测"未来主要是语音控制",但Lex Fridman提出了一个反直觉的观点:打字有时比说话更能帮助思考。
"速度不是一切,有时你需要暂停和思考。"
这个对话看似与AI无关,却触及了一个核心问题:当AI系统的交互速度越来越快,人类的思考节奏是否能跟上?在Token生成速度以毫秒计的年代,人类的认知带宽反而成了瓶颈。
这场"围堵"透露了什么信号
剥开娱乐化的表层,这段视频记录了几个值得关注的产业信号:
100%液冷系统的全面投产,标志着高密度AI计算的热管理方案进入成熟阶段。装配时间的大幅压缩,意味着部署效率正在成为竞争力的一部分。CPU设计逻辑从"核心数"向"Token生成速度"的转变,正在重塑芯片架构的优先级。而HBM供应的持续紧张,说明内存带宽仍然是整个AI算力链条中最紧的环节之一。
黄仁勋在台湾被围堵的画面,本质上是AI时代注意力流向的一个缩影——最稀缺的注意力,正在向那些掌握算力基础设施的人集中。
相关推荐

主流世界之外:被忽视地区的安全与隐私困境
人本安全研究长期集中于西方,导致安全方案在主流世界失效。研究者Collins Minando基于肯尼亚移动贷款应用、网吧认证困境及九国本地专家研究,揭示社会经济约束如何重塑隐私实践,并提出移动货币隐私重设计与PETs部署路径。

Claude被曝可在正常图片中隐藏秘密信息
Reddit帖子称Claude Fable 5.1能在正常图片中隐藏秘密信息,本文梳理事件背景、图片隐写技术原理及潜在安全风险,并给出从传闻走向验证的测试路径建议。

AI助手何时该主动建议?时机决定一切
AI助手何时该主动建议?Reddit讨论揭示:同样的建议在不同时机感受迥异。本文分析主动建议的双面性、用户期待的分界线及设计原则,探讨如何平衡自动化与用户控制。