Hugging Face Journal Club:Score Centering如何稳定离线强化学习
Score Centering 通过中心化 score 函数消除推理与训练不匹配带来的漂移项,稳定 LLM 强化学习训练。
文章讨论了 LLM 强化学习训练中推理引擎与训练引擎不一致导致的训练不稳定问题。论文将采样器 Q 与训练器 P 的差异归结为量化、异步更新等因素,并证明这种不匹配会在策略梯度中引入与回报无关的漂移项,即使没有学习信号也会错误更新权重。作者提出 Score Centering 方法,用原始 score 减去其在 Q 下的期望值,从数学上完全抵消漂移项,只保留协方差学习信号。为解决全词表计算成本高的问题,论文采用 top-k 近似,实验显示 k=8 即可覆盖大部分概率质量。该方法在 8-bit 权重、4-bit KV 缓存等极端量化下仍保持稳定,并与截断重要性采样兼容。
在LLM的强化学习训练中,推理引擎与训练引擎之间的不匹配常常导致训练不稳定。Hugging Face Journal Club最近讨论的一篇论文,从数学上分析了这种不匹配的根源,并提出了一种名为“Score Centering”的修正方法,能够显著提升训练稳定性。
问题根源:推理与训练的不匹配
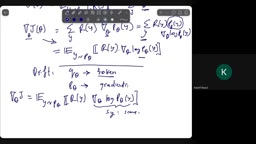
论文首先定义了采样器(Q)和训练器(P)。理想情况下,两者应完全一致,但现实中由于量化、异步更新等因素,P与Q并不相等。这种不匹配会引入“漂移”(drift)项,导致即使没有学习信号,模型权重也会被错误更新。
讲者通过推导策略梯度损失,展示了漂移项如何产生。当P≠Q时,期望梯度中会包含一个与协方差相关的项,而修正方法的目标就是消除这一漂移。
协方差项与漂移项的直观区别
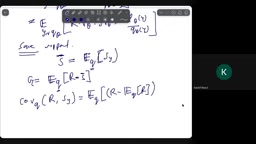
在策略梯度中,我们真正希望利用的信号是“动作的对数概率变化”与“回报”之间的协方差:策略提高高回报动作的概率时,梯度方向才是有意义的。漂移项则不同——它与回报无关,只由 P 和 Q 两个分布之间的系统性差异产生。可以把它理解为一种“虚假梯度”:即便所有采样回报都相同(没有学习信号),这一项依然非零,并持续推动权重朝某个方向移动。在极端量化下,P 与 Q 的尾部差异被放大,漂移项可能主导总梯度,表现为损失突然发散或策略崩溃。Score Centering 的关键观察是:漂移项源自 score 函数在 Q 下的非零期望,因此减去该期望即可精确抵消它,而不影响协方差信号。
P 与 Q 为何会不一致
理想情况下推理引擎和训练引擎使用同一套权重与相同的数值精度,此时 P=Q。但实际系统中存在多种不一致来源:推理侧常采用量化(如 8-bit 权重、4-bit KV 缓存)以降低显存和延迟,量化误差使输出分布偏移;异步训练中推理引擎使用的权重落后于训练引擎若干步,形成“陈旧策略”;此外不同框架的 kernel 实现、批处理方式也会带来细微数值差异。这些因素叠加,使采样分布 Q 系统性地偏离训练分布 P。Score Centering 并不试图消除这些工程差异,而是在数学上补偿它们对梯度的影响,因此对上述各类不匹配都适用。
数学修正:Score Centering
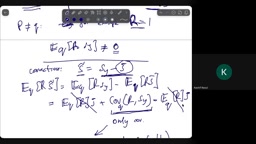
核心思路是对score函数进行中心化,即用原始score减去其期望值。论文证明,使用修正后的score,期望梯度中的漂移项将完全抵消,只剩下协方差项(学习信号)。
修正项的计算需要遍历整个词汇表,计算成本高昂。为此,作者提出了top-k近似方法:只考虑概率最高的k个token,并通过调整尾部概率的质量来保证近似的准确性。
score 函数是什么
在强化学习与变分推断中,score 函数指对数概率对参数的梯度,即 ∇θ log πθ(a|s)。它衡量的是“参数微小变化会如何改变某动作被选中的概率”。策略梯度定理表明,期望回报的梯度可以写成回报与 score 函数乘积的期望,因此 score 是连接采样与参数更新的桥梁。当采样分布 Q 与训练分布 P 不一致时,我们实际计算的是 Q 下的 score 期望,而它与 P 下的真实 score 之间存在偏差,这正是漂移项的来源。Score Centering 的做法是估计 Q 下 score 的期望并从每个样本的 score 中减去它,使修正后的 score 在 Q 下均值为零。这样,任何与回报无关的常数偏移都无法再贡献梯度,剩下的只有随回报变化的协方差部分。
top-k 近似的原理
精确计算 score 的期望需要对整个词汇表(通常数万到数十万 token)求和,每次更新都做一遍代价过高。top-k 近似利用了一个经验事实:语言模型的输出分布通常高度集中,概率质量的大部分落在少数高概率 token 上。只对这 k 个 token 计算 score 及其加权期望,并把剩余尾部的概率质量按比例重新分配或直接忽略,就能以很小误差逼近完整期望。实验中 k=8 已覆盖大部分概率质量,k=16 时覆盖率更高,而计算量相比全词表下降一到两个数量级。这使得 Score Centering 可以嵌入常规训练循环,而不显著拖慢吞吐。
实际效果:稳定训练与高效推理
实验表明,Score Centering在极端量化场景下(如8-bit权重、4-bit KV缓存)仍能保持稳定,而其他方法则出现崩溃。此外,该方法与截断重要性采样等技术兼容,可组合使用。
社区成员还发现,使用top-k近似时,k=8即可覆盖大部分概率质量,k=16时覆盖率更高,且通过优化可以降低性能开销。
结论
Score Centering为离线强化学习提供了一种简单而有效的稳定化方案,尤其适用于量化推理和异步训练场景。论文的数学推导严谨,实验验证充分,有望成为RLHF训练中的默认做法。
相关推荐
Dioxus 全栈生产环境一年实践:收获与痛点
一位开发者分享 Dioxus 全栈框架在生产环境运行一年的真实体验,涵盖全栈 Rust 的类型安全收益、编译时间与生态成熟度等痛点,为技术选型提供参考。
AGI领袖的隐秘信仰:人类没有特殊之处?
Vergecast播客揭示AGI领袖圈内的隐秘信念:人类没有特殊之处,意识只是计算。探讨计算功能主义如何影响技术精英的世界观与AI未来。
通用汽车转向混动:从纯电押注到务实并行的战略调整
通用汽车此前跳过混动直接押注纯电,如今计划为SUV产品线推出混合动力版本,本文解析这一战略调整的原因、对SUV品类的意义以及对消费者的实际影响。