Hugging Face推理路由全面接入OpenRouter
Hugging Face将推理路由迁移至OpenRouter,开源模型调用占比达81%。
Hugging Face本周宣布与OpenRouter合作,将自研推理路由系统替换为OpenRouter,用户通过Hugging Face调用模型时,请求会自动路由到当前最优推理提供商。OpenRouter数据显示,开源权重模型已承接81%的请求,而一年前闭源模型占78%,生态格局发生根本翻转。接入流程沿用Hub既有交互:模型页直接对话、查看实时推理指标、获取Python/JS示例并连接编程智能体。Pro账户每月2美元额度约覆盖1.5亿DeepSeek 4.1 Flash token(启用缓存),且Hugging Face不加价。用户可过滤特定提供商并设置支出上限。此次整合简化了底层架构,但也带来对OpenRouter路由策略的新依赖。
Hugging Face本周宣布与OpenRouter达成合作,将其自研的推理路由系统迁移至OpenRouter。这意味着用户通过Hugging Face调用模型时,请求将由OpenRouter自动选择当前可用的最优推理提供商。这一变动不仅简化了底层架构,也反映出开源模型在真实调用量上已占据主导地位。作为长期跟踪AI基础设施的观察者,我认为这次整合值得从技术、生态和用户体验三个层面拆解。
开源模型调用量反超闭源,生态格局已变
据Hugging Face官方视频披露,OpenRouter平台上的模型调用结构在过去一年发生了根本性翻转。去年同期,闭源权重模型占据了全部请求的78%;而目前,开源权重模型已承接81%的请求。在OpenRouter最受欢迎的十个模型中,有八个是开放权重模型。这一数据与Hugging Face自身观察到的开源模型热度飙升相吻合。
这种转变并非偶然。开源模型在性能上快速逼近闭源前沿,同时推理成本持续下降,使得开发者和企业更倾向于将工作负载迁移到可自主控制的模型上。OpenRouter作为聚合路由层,恰好为这种迁移提供了统一接口和比价能力。
开放权重模型(Open-weight Model) 指模型参数权重可公开下载和使用的模型,如Llama、Qwen、DeepSeek广告等系列。与完全闭源的模型(如GPT-4、Claude)不同,开放权重模型允许开发者本地部署、微调,或通过第三方推理提供商调用。OpenRouter统计的“开源权重模型请求占比”正是基于这类模型的API调用量,而非下载量。这一指标能更直接反映生产环境中的实际使用偏好,因为调用请求通常对应真实业务负载。
在Hugging Face上直接调用OpenRouter:三步上手
整个接入流程沿用了Hugging Face Hub的既有交互逻辑,几乎没有新增学习成本。
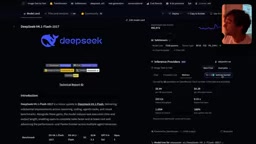
第一步:在模型页直接对话。 已登录用户打开任意支持推理的模型页面(例如视频中演示的DeepSeek 4.1 Flash最新检查点),就能看到内嵌的聊天窗口。输入提示词后,请求会直接经OpenRouter路由到可用的推理提供商。点击提供商列表,可以查看当前请求被分发到了哪个后端。
第二步:查看实时推理指标。 点击指标入口,可以查看每百万输入/输出token的价格、每秒生成token数、首token延迟、上下文窗口大小以及该模型在OpenRouter上的在线率。这些数据对选型和成本估算非常关键。
第三步:集成到应用或编程助手。 在“Getting Started”区域,用户可以直接获取Python或JavaScript的调用示例。同时,Hugging Face账号可以连接到Pi、OpenCode、Claude Code、Codex等编程智能体,让这些工具通过Hugging Face额度调用OpenRouter背后的模型池。
推理路由(Inference Routing) 是聚合层根据当前延迟、价格、可用性等指标,将用户请求动态分发到不同推理后端的技术。OpenRouter维护着数十家推理提供商(如Together、Fireworks、DeepInfra等)的实时状态,当某个提供商出现故障或性能下降时,路由系统会自动将流量切换到备用节点。这种机制避免了单点故障,也让用户无需手动比价和切换API端点,本质上是一种面向大模型推理的负载均衡与故障转移方案。
Pro账户每月2美元额度,能跑多少token?
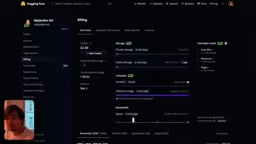
Hugging Face Pro账户每月赠送2美元信用额度,可用于Hub上的多项服务,包括私有存储、公共存储、ZeroGPU以及推理调用。官方视频给出了一个参考值:这2美元大约足以覆盖1.5亿个DeepSeek 4.1 Flash token的消耗,前提是进行常规对话并启用提示缓存——OpenRouter会自动处理缓存。
更关键的一点是,Hugging Face明确表示不对展示价格加价。页面上显示的价格与OpenRouter官方公布的价格完全一致,用户无需担心平台中间抽成。对于成本敏感的团队来说,这种透明定价降低了跨平台比价的复杂度。
提供商筛选与支出管控
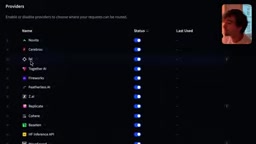
在设置页的“推理提供商”区域,用户可以查看模型使用分析,并手动关闭不希望被路由到的提供商。例如,视频演示中提到了Novita、Cerebras、FOUL等提供商,用户可以一键关闭Novita,此后所有请求将不再经过该后端。这一功能对合规要求高或对特定提供商有偏好的团队尤为重要。
同时,用户可以在账户中设置支出上限。企业账户管理员则可以为组织内所有成员统一管理该限额。这意味着团队可以在享受OpenRouter路由便利的同时,保留预算控制权。
提示缓存(Prompt Caching) 是一种优化推理成本的技术:当多次请求包含相同的前缀(如系统提示词、长文档上下文)时,推理提供商可以缓存这部分计算结果,后续请求直接复用,从而减少重复计算。OpenRouter会自动处理缓存命中,用户无需修改代码。对于长上下文对话或固定指令的智能体工作流,缓存可显著降低token消耗——这也是官方给出“2美元覆盖1.5亿token”估算的重要前提。
这次合作意味着什么
从架构角度看,Hugging Face将自研路由器替换为OpenRouter,相当于把“选哪个推理后端”这一复杂决策外包给了专业聚合层。OpenRouter本身已经接入了大量推理提供商,具备动态比价和故障转移能力。Hugging Face则聚焦于模型托管、社区和账户体系,双方形成互补。
对开发者而言,最直接的变化是调用路径的统一:无论通过Hugging Face网页、API还是编程智能体,底层都走同一套OpenRouter路由。价格透明、提供商可过滤、额度可管理,这三项能力组合起来,降低了多模型工作流的运维负担。
需要留意的是,这种聚合模式也带来了新的依赖关系。如果OpenRouter的路由策略或可用提供商发生变化,Hugging Face用户会直接感知到。官方提供的提供商过滤和支出限制是有效的缓解手段,但对于有严格SLA要求的企业,仍需评估多提供商冗余策略。
总体来看,这次合作是开源模型生态走向成熟的一个信号:模型数量爆发之后,调用层的整合与标准化正在成为下一阶段的竞争焦点。
相关推荐
Hark Pro实测:三关零操作,AI真能接管日常事务?
YouTube创作者实测Hark Pro三项日常任务:清空收件箱并生成账单表、通过DoorDash完成订餐全流程、自动构建操作汇总面板。全程不碰键盘,三战三胜,本文分析这款操作式AI的能力边界与隐忧。
Katseye困境:偶像工业的高速运转还能持续多久?
从Katseye近期的团队困境出发,结合One Direction成员对高强度巡演与宣传节奏的公开反思,分析偶像产业"巡演—专辑—宣传"循环的结构性问题,以及组合若想翻盘需要在运营策略上做出的改变。

苹果招募AI代理工程师,Siri之后的新王牌?
苹果正招募工程师领导开发代理型AI助手,可浏览网页、跨应用操作、编写代码和调用服务。本文分析苹果做AI代理的动机、技术挑战及对行业的影响。