HuggingFace开始内容审查?下架模型引发社区争议
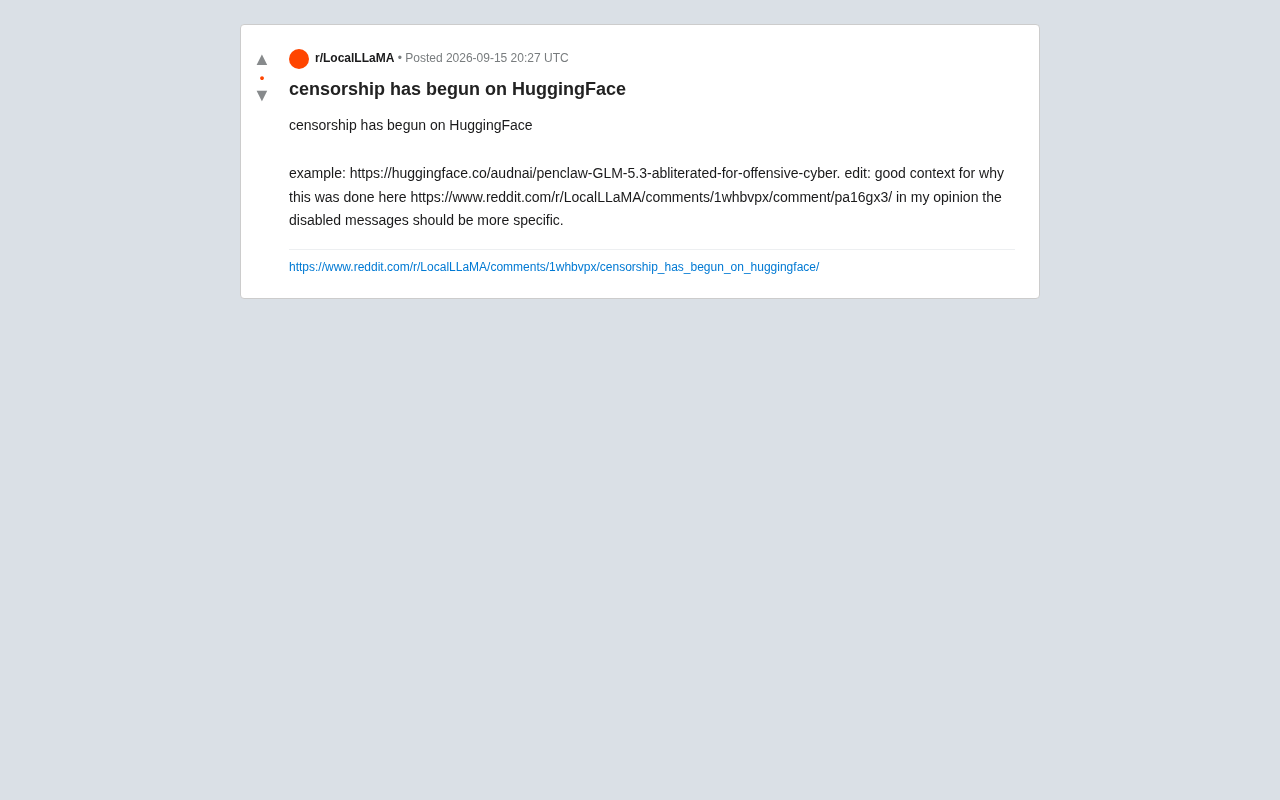
HuggingFace限制一个明标攻击用途的去审查模型,社区争议焦点落在禁用透明度而非下架本身。
近日,HuggingFace限制了一个名称中含「for offensive cyber」字样的abliterated GLM衍生模型,引发Reddit社区关于「开源平台开始内容审查」的讨论。abliterated模型指通过修改模型内部激活方向、移除安全拒答机制的模型,此类模型在开源社区本属常见,但明确标注恶意网络攻击用途者性质有别。有趣的是,发帖者本人也认可平台行动有一定合理性,真正的不满在于禁用提示过于笼统,未说明具体触发原因。事件折射出开源AI平台长期面临的张力——开放生态与法律合规之间的平衡,以及规则透明度对社区信任的决定性影响。目前此事仍属个案,尚不能证明HuggingFace正系统性收紧政策,但随着模型能力增强,平台治理的边界划定与沟通方式将日益成为开源生态的核心议题。
近日,一则关于「HuggingFace开始内容审查」的帖子在Reddit的LocalLLaMA社区引发热议。有用户发现,平台上一个名为penclaw-GLM-5.3-abliterated-for-offensive-cyber的模型仓库被平台限制访问,相关消息被禁用。这一动作被部分社区成员解读为开源模型托管平台走向内容管控的信号。
事件始末
据Reddit帖子描述,被处理的模型是一个经过「abliterated」(去除安全对齐/拒答机制)处理的GLM衍生模型,其命名中包含「for offensive cyber」(用于攻击性网络行为)的字样。这类模型通常通过技术手段移除原始模型的安全护栏,使其能够响应本应被拒绝的请求。
发帖者本人也承认,从社区讨论提供的上下文来看,平台采取行动「有其理由」。真正引发争议的并非下架本身,而是执行方式——发帖者认为,平台展示的「已禁用」提示信息过于笼统,应当更加具体地说明被限制的原因,让开发者和用户清楚知道触发了哪条规则。
「abliterated」模型为何敏感
要理解这场争议,需要先弄清「abliterated」模型的性质。主流大模型在发布前都会经过安全对齐训练,使其拒绝生成恶意软件代码、协助网络攻击、输出违法内容等请求。而所谓「abliteration」是一种通过修改模型内部激活方向来削弱或移除这些拒答行为的技术,让模型变得「有求必应」。
单纯的去审查模型在开源社区其实相当普遍,很多研究者用它们来测试模型的能力边界或做安全研究。但当一个模型明确以「offensive cyber」(攻击性网络行动)为用途命名时,情况就不同了——这相当于在公开平台上标注了明确的恶意使用意图。这也是社区中不少人认为平台介入合理的核心原因。
从技术机制上看,「abliteration」通常基于「激活引导」(activation steering)或「表示工程」(representation engineering)等方法实现。研究者首先找到模型内部与「拒绝行为」强相关的激活方向向量,然后在推理或微调阶段对该方向施加反向干预,从而系统性地压制拒答倾向。这一方法由 Andy Zou 等人在2023年的论文《Representation Engineering》中系统化,此后被社区广泛应用于模型解锁实验。与传统微调相比,abliteration 的成本极低,只需少量计算资源即可在现有模型权重上操作,这也是此类衍生模型能大量涌现的原因。正因为技术门槛低、效果明显,托管平台对于「明示恶意用途」的此类模型的态度,实际上也在向社区传递信号:平台监管的边界并非技术方法本身,而是公开声明的使用意图。
内容审查还是合规必需
这起事件触及了开源AI社区长期存在的张力:平台自由度与法律合规、平台责任之间的平衡。
支持平台行动的一方认为,托管一个自我标榜用于网络攻击的模型,会给平台带来实实在在的法律与声誉风险。作为全球最大的开源模型托管平台,HuggingFace有理由对明显指向恶意用途的内容划出红线,这与压制正常的研究性、去审查模型有本质区别。
持保留态度的一方则担忧,「censorship has begun」这一标题所暗示的滑坡效应——今天下架的是明确标注恶意用途的模型,明天的标准会不会扩大到普通的去审查模型甚至研究模型?开源生态的活力恰恰来自较低的准入门槛,任何审查机制的引入都可能产生寒蝉效应。
HuggingFace 作为模型托管平台,其法律处境与代码托管平台(如 GitHub)有相似之处,但也面临额外挑战。美国《计算机欺诈与滥用法案》(CFAA)及欧盟《网络韧性法案》等法规,对「明知故意提供可用于网络攻击的工具」的平台均有潜在追责空间。与此同时,HuggingFace 已于2023年推出自己的内容政策(Acceptable Use Policy),明确禁止托管「旨在造成伤害」的模型。因此,此次限制行动更可能是既有政策的常规执行,而非临时起意的审查升级。理解这一法律与政策背景,有助于区分「平台主动收紧」与「平台履行已有合规义务」这两种性质截然不同的情形。
透明度才是真正的痛点
值得关注的是,发帖者本人的诉求其实相当克制。他并未一味反对下架,而是把矛头指向了执行的透明度:平台给出的禁用提示太模糊。
这其实指向了平台治理中一个普遍问题。当平台开始对内容做管控时,模糊的、一刀切的提示信息容易激化矛盾,让开发者产生「被无理由封禁」的挫败感。相比之下,明确告知「因命名/描述明示恶意网络用途而受限」这样具体的理由,既能让真正违规者无话可说,也能让普通研究者放心——平台针对的是恶意意图,而非技术本身。
对于任何一个内容平台而言,规则的清晰度和执行的一致性,往往比规则本身是宽是严更能决定社区的信任度。这场围绕单个模型的讨论,实际上是对开源AI平台治理机制的一次早期压力测试。
小结
这次事件目前仍是个案,尚不足以证明HuggingFace正在系统性地收紧内容政策。被处理的模型带有明确的攻击性网络用途标注,使其成为一个较为特殊的边界案例。但社区反应提醒我们,随着开源模型能力不断增强,平台如何在开放与责任之间划线、以及如何透明地沟通这些边界,将成为整个生态无法回避的议题。
相关推荐
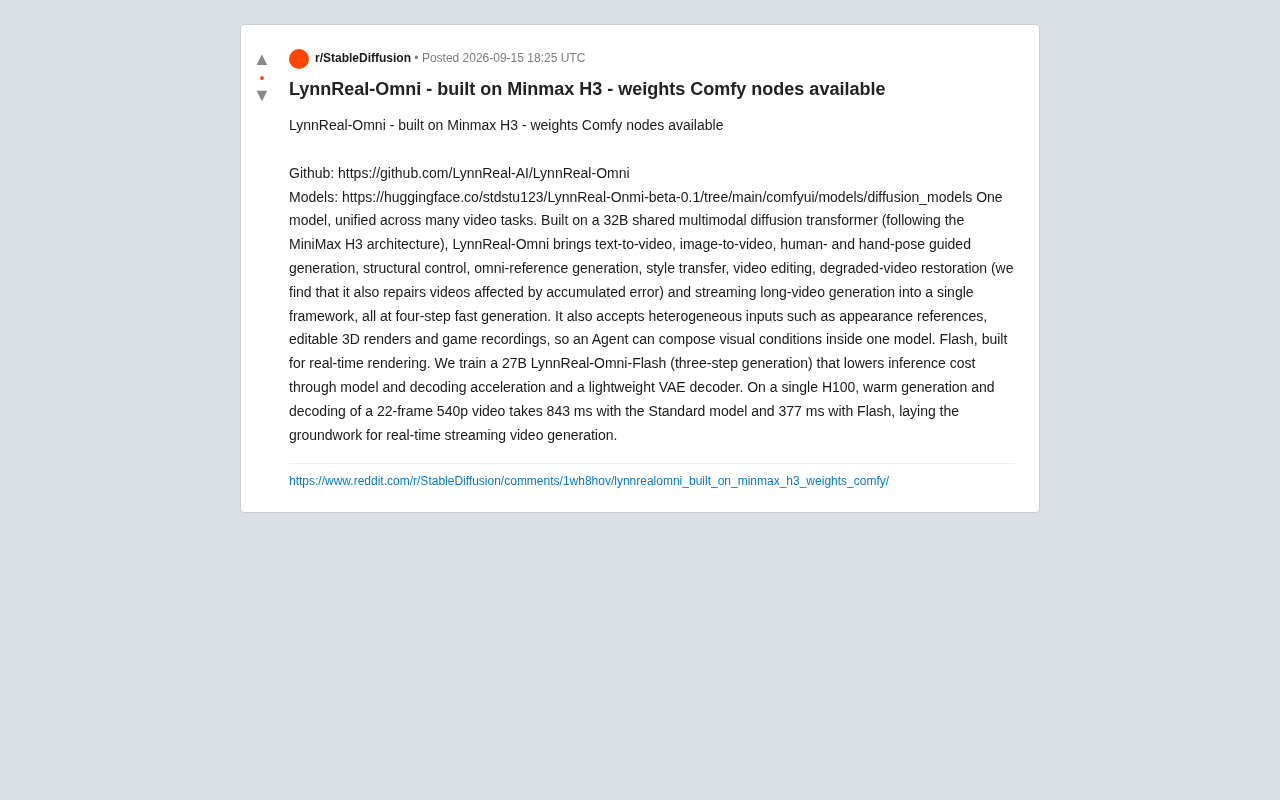
LynnReal-Omni:32B统一视频扩散模型开源,四步生成多任务全覆盖
LynnReal-Omni 是基于 MiniMax H3 架构的 32B 统一视频扩散模型,支持文生视频、图生视频、姿态引导、视频修复等多任务,四步快速生成,Flash 版单张 H100 上 377ms 完成 540p 视频,权重与 ComfyUI 节点已开源。

Anthropic联合创始人:AI"紧急停止开关"或应强制立法
Anthropic联合创始人向BBC表示,AI系统的"紧急停止开关"(kill switch)可能需要通过法律强制推行。本文分析这一呼吁背后的产业逻辑、技术挑战以及监管与创新之间的张力。

AI数据中心建设热潮,正冲击工业创伤深重的城市
AI数据中心建设热潮正与曾受重工业创伤的城市社区激烈碰撞。以费城为例,全国性反对声浪聚焦能耗、水资源与环境公平问题,揭示AI增长与地方利益的结构性冲突。