回归系数能直接当特征权重吗?机器学习新手常见误区解析

线性回归的系数即公式权重,但比较特征重要性须先标准化,模型选择取决于任务类型。
本文回答了一个机器学习入门者的典型困惑:线性回归训练后得到的系数,本身就是预测公式中的权重,无需额外转换,直接配合截距项即可写出完整公式。然而,系数的绝对大小不能直接比较特征重要性,因为不同特征的量纲差异会扭曲系数数值;若需比较重要性,应先对特征做标准化。文章还梳理了方法选择的判断框架:连续因变量用线性回归,分类问题用逻辑回归,非线性关系可考虑树模型。此外提醒注意多重共线性对系数解释的干扰,以及"构建预测公式"与"评估特征重要性"是两个需要分别对待的目标。
问题背景:从数据到公式的直觉
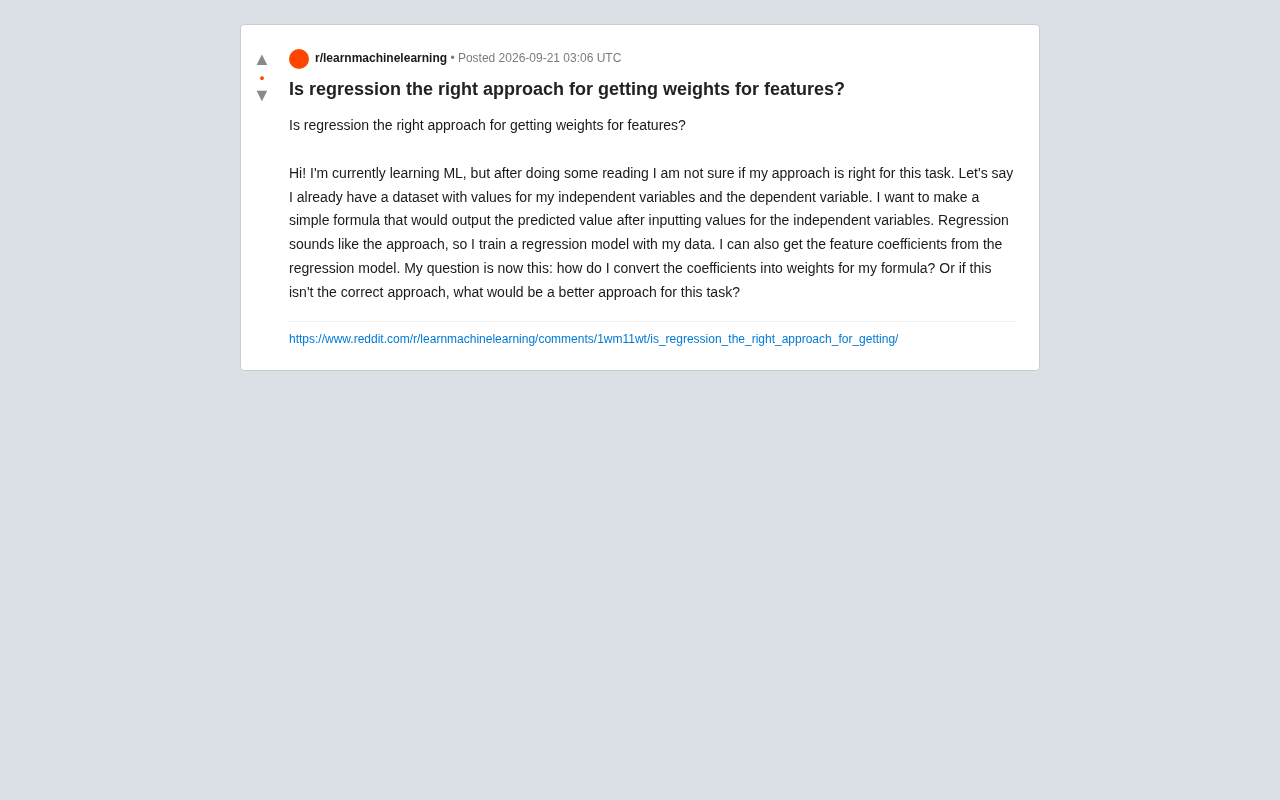
一位机器学习初学者在 Reddit 上提出了一个看似简单却极具代表性的问题:假设手头有一份包含自变量与因变量的数据集,想要构建一个简单公式,输入自变量后能预测因变量的取值。回归听起来是合适的方法,于是训练了一个回归模型,也拿到了各特征的系数(coefficients)。真正的困惑在于:如何把这些系数转换成公式里的"权重"?如果回归本身就不对,又该用什么方法?
这个问题触及了机器学习入门阶段最容易混淆的几个概念——系数、权重、特征重要性之间的关系。下面逐一拆解。
回归系数本身就是权重
先给出直接答案:线性回归的系数,本质上就是你要找的"权重",无需额外转换。
一个标准的线性回归模型形式如下:
y = w1*x1 + w2*x2 + ... + wn*xn + b
这里的 w1, w2, ..., wn 就是模型训练后得到的系数,b 是截距(intercept)。当你想把模型变成一个"简单公式"时,直接把这些系数和截距代入上面的表达式,就是你要的预测公式。输入具体的 x1, x2... 值,计算即可得到预测的 y。
所以提问者其实已经完成了 90% 的工作,只是被"系数"和"权重"两个词的差异绊住了——在线性模型语境下,它们指的是同一个东西。
一个关键陷阱:系数大小 ≠ 特征重要性
很多初学者会进一步误解:既然系数是权重,那系数越大的特征是不是越重要?这是一个需要警惕的坑。
原始特征的量纲(scale)不同,会直接影响系数的绝对大小。举例来说,如果一个特征是"房屋面积(单位:平方米)",另一个是"房间数量",前者数值范围可能是几十到几百,后者只有个位数。即便两者对预测同样重要,面积的系数也可能因为数值范围大而显得很小,房间数的系数则相对偏大。
如果你的目的是比较特征之间的相对重要性,正确做法是在训练前对特征做标准化(standardization,即减均值除以标准差)。标准化后的系数才具备可比性,此时系数绝对值的大小才更能反映特征的影响力。
标准化的具体操作是将每个特征减去其均值、再除以标准差,使所有特征的均值为 0、标准差为 1,处于同一量纲下。在 scikit-learn 中,StandardScaler 可以一步完成这个转换。需要注意的是,标准化应该只在训练集上拟合(fit),再将同样的均值和标准差应用到验证集和测试集,避免数据泄露。此外,如果最终目的是部署一个预测公式,还需要把标准化步骤也纳入公式:输入原始值时,先手动减去训练集均值、除以训练集标准差,再代入回归系数计算。忽略这一步会导致线上预测结果与训练时完全不一致。
是否应该用回归?取决于你的目标
回到提问的另一半:"如果这不是正确的方法,什么才更好?"答案取决于任务性质。
因变量是连续值
如果你要预测的是一个连续的数值(如价格、温度、销量),线性回归是完全合理的起点。它可解释性强,输出的公式清晰直观,非常适合"想要一个简单公式"的需求。
变量间关系非线性
如果自变量和因变量之间不是线性关系,纯线性回归可能欠拟合。可以考虑加入多项式特征、交互项,或换用树模型(如随机森林、梯度提升树)。但要注意:树模型不会给你一个简洁的线性公式,可解释性会下降。
因变量是类别
如果因变量是分类结果(是/否、A/B/C),那应该用逻辑回归或分类模型,而不是普通线性回归。
给初学者的实操建议
综合来看,提问者的思路方向是对的,只需要在几个细节上补齐认知:
- 先做基线:用线性回归建立一个可解释的基线模型,直接取系数作为公式权重。
- 区分两个目标:"构建预测公式"和"评估特征重要性"是两件事。前者直接用系数即可;后者需要先标准化特征。
- 检验模型假设:线性回归对残差的正态性、同方差性、特征间的多重共线性都有假设。若特征之间高度相关,单个系数的解释会失真,此时可考虑岭回归(Ridge)或 Lasso。
- 验证效果:不要只看模型拟合了训练数据,一定要用测试集或交叉验证评估泛化能力,看公式在新数据上是否可靠。
多重共线性(Multicollinearity)是指两个或多个自变量之间存在高度线性相关,导致模型无法稳定地区分各变量的独立贡献。典型症状是系数估计值方差极大、甚至符号与直觉相反。诊断多重共线性常用方差膨胀因子(VIF,Variance Inflation Factor):VIF 大于 5 或 10 通常视为警示信号。岭回归(Ridge)通过在损失函数中加入系数的 L2 惩罚项来压缩系数、降低方差;Lasso 则使用 L1 惩罚,可以将部分系数压缩至零,实现自动特征选择。两者都能缓解共线性带来的系数不稳定问题,但代价是系数不再是无偏估计,对"公式"的直接解释需要更加谨慎。
小结
这个来自 Reddit 的问题,本质上是机器学习入门时对"系数=权重"这一关系的自然疑惑。对于线性回归而言,训练得到的系数就是可以直接放进公式的权重,配上截距项即可完成预测公式的搭建。真正值得投入精力的,是理解系数背后的量纲问题、区分预测与重要性评估这两个不同目标,以及根据数据的实际关系选择合适的模型族。掌握了这些,一个简单可解释的预测公式就能既好用又可信。
相关推荐

顶尖企业用好AI的秘诀:从实验走向成熟管理层
基于KPMG第三季度AI Pulse调查,解析用好AI的顶尖企业与实验阶段企业的关键差距:模型路由、数据主权、AI管理层、成本与价值管理,以及从效率到机会的用途转变。

付费用户因"网络滥用"遭ChatGPT封号:1分钟秒拒的申诉机制引众怒
一名付费ChatGPT用户因"网络滥用"被无预警封号,三次申诉均在一分钟内被机器人驳回,全程无人工审核。本文梳理事件经过、可能的误判原因,并剖析AI平台自动化治理的申诉困境与开发者应对建议。

OpenSOP:用Git管理多语音Agent提示词的开源方案
OpenSOP 是一个开源工具,用 Git、YAML 和 Markdown 管理多个AI语音Agent的提示词,解决提示词重复、漂移和手动同步难题,支持改动影响预览和一键回滚。