Human-in-the-Loop:如何给AI自动化加上安全刹车

Human-in-the-Loop通过在不可逆操作前强制插入人工检查点,守住AI自动化的最后防线。
本文探讨了在AI自动化工作流中引入Human-in-the-Loop(HITL)机制的必要性。AI模型存在自信编造内容的固有缺陷,一旦直接接入转账、退款、数据删除等不可逆业务操作,错误的代价将无法挽回。HITL的核心做法是在高风险步骤执行前物理性冻结整个流程,强迫AI暴露其推理依据,由人工审核后再决定批准或拒绝。这种机制并非追求全面覆盖,而是精准设卡——判断标准在于操作是否不可逆、出错代价及AI误判概率。作者将其归纳为一条设计原则:自动化程度应与错误的可逆性成反比,HITL正逐渐成为企业级AI部署不可或缺的基础安全设施。
为什么不能让AI独自上路
AI模型最危险的特性之一,是它们会自信地编造内容。当你把这样一个会"一本正经胡说八道"的模型,直接接入企业的真实业务工具时,风险会被无限放大。一旦AI做出决策,背后的API就会立刻触发——钱款转出、订单取消、数据删除,这些动作往往是不可逆的。
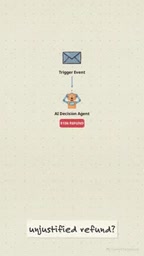
设想一个典型场景:一个AI客服代理被赋予了读取完整邮件、并自动处理退款的权限。它的任务听起来很合理,也确实能节省大量人力。但问题在于,如果AI误读了一封措辞混乱的邮件,错误地判断需要退一笔巨额款项,会发生什么?
在标准的全自动工作流里,答案很残酷:钱已经没了。AI做出决定的那一秒,支付API就已经执行完毕,没有任何缓冲余地。
Human-in-the-Loop 到底拦住了什么
Human-in-the-loop(人在回路,简称HITL)的核心,是在流程中最关键、最不可逆的那一步之前,插入一道强制性的检查关卡。
还是用退款的例子。HITL会在"最终执行付款"这一步前面,设置一个硬性的路障。当数据流到这里时,它会物理性地停下——不是提醒、不是日志记录,而是整个流程真正地冻结在这里。
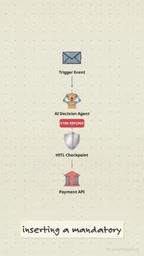
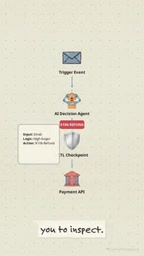
这个"挂起"状态有一个额外的价值:它强迫AI把自己的推理过程完整暴露出来,供人工检查。你能看到AI为什么做出这个判断、依据了邮件里的哪些内容。整个工作流会一直冻结,直到有人点击"批准"或"拒绝",才会重新解锁后续路径。
Human-in-the-Loop(HITL)这一概念最早来源于机器学习领域,指在模型训练或推理过程中引入人工干预的设计范式。在传统机器学习中,HITL常用于主动学习(Active Learning)——让模型在不确定的样本上请求人工标注,以提升训练效率。进入AI Agent时代后,这一概念被延伸到工作流执行层面:AI不再只是给出预测结果,而是会触发真实的外部动作(如调用API、修改数据库),此时HITL的重点从"辅助训练"转向"控制执行风险"。在技术实现上,现代工作流编排工具(如n8n、LangChain的Human-in-the-loop节点、Temporal等)通常通过"暂停并等待外部信号"的机制来实现这一功能:流程实例被持久化存储,等待人工通过界面或API发送审批信号后再恢复执行,整个等待期间不占用计算资源。
一次价值一万美元的拦截
回到那笔AI试图发出的、金额高达一万美元的错误退款。有了HITL检查点,处理方式变得异常简单:你只需要点击"拒绝"。
工作流在那一刻保持冻结,没有一分钱真正发生转移。你在资金流动之前就抓住了错误。这正是HITL与普通自动化的本质区别——它不是在事后补救,而是在动作发生前就设立了一道不可绕过的闸门。
这种设计思路揭示了一个重要原则:自动化的程度,应当与错误的可逆性成反比。对于可逆的、低风险的操作,AI完全可以独立运行;但对于转账、删除、对外发送这类不可逆的高风险动作,人工审核环节的价值远高于它带来的那点效率损失。
HITL 的适用边界
HITL并非万能,它的代价是牺牲了部分自动化带来的速度。如果对每一个微小决策都要求人工确认,自动化本身就失去了意义。因此,实践中真正的功夫在于精准识别哪些节点需要设卡。
一个实用的判断标准是追问三个问题:这个动作是否不可逆?出错的代价有多大?AI在这个环节的误判概率有多高?只要有一项答案偏向高风险,就值得在此设置人工检查点。
随着AI代理(AI Agent)被越来越多地接入真实业务系统,HITL正在从一个可选项变成企业级AI部署的基础安全设施。它承认了一个朴素的事实:当前的AI足够强大,但还不足以在没有监督的情况下独自掌管那些一旦出错就无法挽回的操作。
AI Agent(AI代理)是指被赋予感知环境、规划步骤、调用工具并自主完成目标能力的AI系统,区别于只做单次问答的普通大语言模型。一个典型的AI Agent可以在一次任务中依次读取邮件、查询数据库、调用支付API、发送通知,整条链路无需人工介入。这种"自主行动"能力正是其价值所在,也是其风险来源——每一步工具调用都可能产生真实的、不可逆的副作用。目前业界对AI Agent的安全管控形成了几个共识原则:最小权限原则(只授予完成任务所需的最低权限)、沙箱隔离(在测试环境验证后再上生产)、以及本文重点讨论的HITL检查点。随着OpenAI、Anthropic等主要厂商在其API中加入对工具调用的原生支持,AI Agent的部署门槛持续降低,相应的安全框架建设也变得愈发迫切。
写在最后
Human-in-the-loop的理念并不复杂,但它触及了AI落地的一个核心命题——信任与控制的平衡。把AI接入生产系统,不等于把方向盘完全交出去。保留一个随时能喊停的人工检查点,既让你享受自动化的效率,又守住了最后一道防线。
在拥抱AI自动化的热潮中,这或许是最值得企业牢记的一条设计原则:永远不要让AI独自上路。
相关推荐
AI+网络安全入门指南:从零基础到SRC挖洞实战
面向零基础学习者的AI+网络安全入门指南,拆解SRC漏洞挖掘课程的核心模块:高频漏洞原理、资产信息收集、CVE漏洞复现与AI工具实操,分析学习路径与职业方向。
谁更不受欢迎:民主党还是共和党?
民主党与共和党谁更不受欢迎?本文深入分析两党支持率困境、民主党在立法博弈中的两难选择,以及政府停摆策略的政治风险,揭示美国政治极化的深层逻辑。
Coze 3.0从入门到多Agent协作实战指南
Coze 3.0新版教程:从AI Agent产品分类讲起,解析Coze Studio、Dify等搭建平台与Claude Code等Agent软件的区别,梳理Coze多Agent协作、技能商店与项目管理的核心玩法,适合0基础入门。