human-tps:用真实分词器测你打字有多少token/s

一个用真实分词器测量人类打字token速度的趣味工具,用自嘲解构本地LLM社区的性能焦虑。
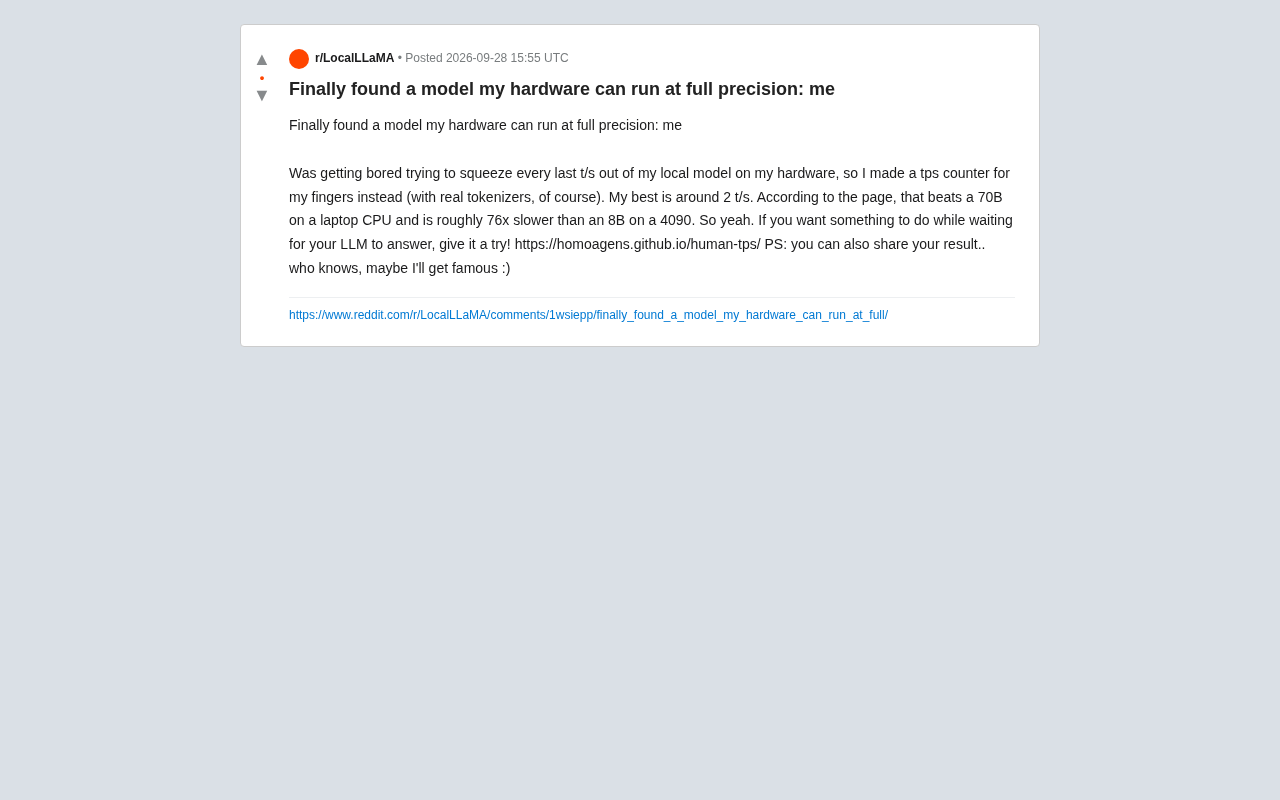
human-tps是一位Reddit用户做的网页小工具,灵感来自本地大模型社区对t/s(每秒token数)这一性能指标的普遍执念。它让用户像测评大模型一样测量自己的"输出速度",并特别采用真实分词器计量,使结果与LLM的t/s口径一致、可横向比较。作者自测约2 t/s,声称超过笔记本CPU运行70B模型的速度,但比RTX 4090跑8B模型慢76倍。整个项目是一个面向本地LLM爱好者的"内部笑话可视化":它不解决任何实际问题,却用社区熟悉的语言和指标,把等待模型吐字时人人都懂的煎熬,变成了一个能互动、能分享成绩的轻量体验,折射出这个社区既在硬件极限上斤斤计较、又能对自身执着一笑置之的文化气质。
一个把玩笑玩到底的开源小工具
在本地跑大模型的圈子里,t/s(tokens per second,每秒生成的token数)几乎是所有人挂在嘴边的指标。为了在有限的硬件上多榨出几个token,玩家们折腾量化、调batch、换推理框架,乐此不疲。
最近一位 Reddit 用户干脆反其道而行——既然优化模型这么累,那就测测人类自己的token生成速度吧。他做了一个网页版工具 human-tps,让你像大模型一样,测量自己每秒能"输出"多少个token。
作者的原话很有代表性:"终于找到一个我的硬件能全精度运行的模型了:我自己。"这句自嘲精准戳中了每个在消费级显卡上苦苦调参的本地LLM玩家。
它到底做了什么
工具的核心其实并不复杂,但有个关键的认真之处:它用了真实的分词器(real tokenizers),而不是简单地按字符或单词计数。这意味着它测量的是你输入文本被切成token的速度,和LLM的计量口径保持一致,这样横向对比才有意义。
作者晒出自己的成绩大约是 2 t/s。听起来慢,但他顺手做了几个对比:
- 按页面数据,这个速度超过了笔记本CPU上运行70B模型的表现;
- 但相比在 RTX 4090 上跑一个8B模型,人类大约要慢76倍。
换句话说,人脑加双手的"推理速度"在纸面上还能吊打某些极端受限的硬件配置,但面对一张现代高端显卡跑小模型,就完全没有胜算了。这种荒诞又直观的对比,正是这个项目的乐趣所在。
为什么这个梗能戳中人
本地LLM社区长期弥漫着一种"性能焦虑":显存不够就上量化,量化掉精度就想办法补偿,t/s上不去就换推理引擎。等待模型吐字的过程,本身就是一种煎熬。
human-tps 把这套严肃的性能话语,套在了人类身上,制造出一种恰到好处的反差幽默。作者也直白地建议:"如果你在等LLM回答时想找点事做,可以来试试。"——一个填补等待空隙的小玩具,顺便自嘲一下自己的"硬件规格"。
工具还支持分享成绩,带有一点社交传播的设计。作者半开玩笑地说:"谁知道呢,说不定我能因此出名。"这种轻量、可分享、带梗的设计,正是这类小项目在技术社区容易走红的原因。
小工具背后的认真态度
虽然整体是个玩笑,但"使用真实分词器"这个细节透露出作者并非随手糊弄。token的切分逻辑因模型而异,一段英文可能被切成远多于单词数的token,中文、代码、标点的处理更是各不相同。用真实分词器计量,才能让"人类 t/s"和"模型 t/s"处在可比较的语境里。
从这个角度看,human-tps 更像是一次面向本地LLM爱好者的"内部笑话可视化":它不解决任何实际问题,却用社区熟悉的语言和指标,把一个人人都懂的痛点变成了能互动、能分享的小体验。
结语
这类项目不会改变任何技术格局,但它恰恰反映了本地大模型社区的文化气质——既在硬件极限上斤斤计较,又能对自己的执着一笑置之。如果你也天天盯着 t/s 数字发愁,不妨去 human-tps 测测自己这个"全精度模型"到底跑多快。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。