混合专家系统能否超越单一大模型?Hermes 2.0架构深度解析

从「追模型」到「造系统」:一种新的AI构建思路
近期一段来自Bilibili的技术演示视频引发了关于AI智能体架构的讨论。视频作者展示了一套名为「Hermes多智能体混合系统2.0」的方案,其核心主张颇具颠覆性:与其苦苦等待GPT-5.6或其他封闭前沿模型发布,不如把多个现有模型「堆叠」起来协同工作,用更聪明的系统架构而非更大的单一模型来取胜。
作者用一句话概括了整套系统的设计哲学:「不要追着模型跑,去构建系统。」这句话点出了当前AI应用开发中一个值得深思的趋势——当模型迭代速度越来越快、可用性又充满不确定性时,把业务逻辑绑定在单一模型上反而是一种风险。
需要说明的是,本文基于单一来源的演示视频,其中大量测试数据和模型名称(如「GoldieBench」「Cloud Opus 4.8」「Nexus Research」等)在公开渠道缺乏交叉验证,读者应保持审慎判断。
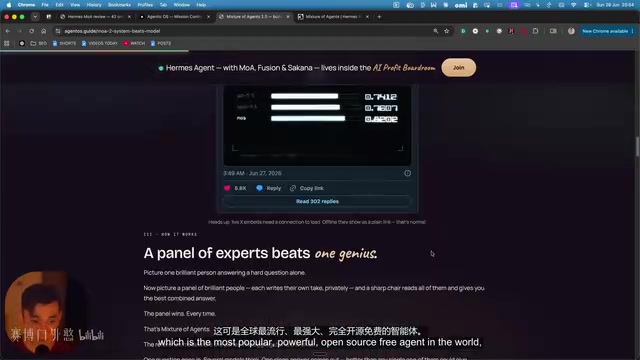
混合专家架构:多个大脑胜过一个天才?
核心运作原理
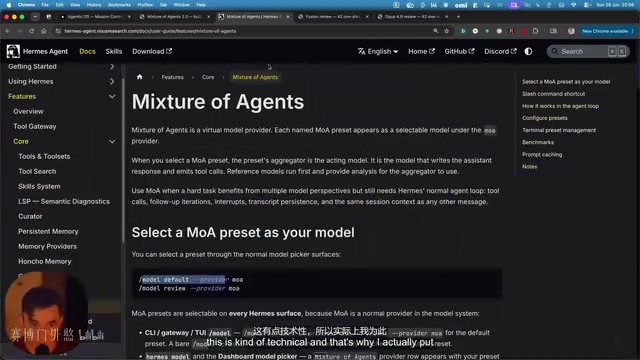
按照演示者的解释,这套系统的技术基础是「混合专家(Mixture of Experts,MoE)」架构。但与传统MoE在单一模型内部进行路由不同,这里指的是在系统层面把多个独立模型「像专家组一样」组织起来协同工作。
MoE架构的技术溯源:混合专家架构最早可追溯至1991年Jacobs等人提出的神经网络集成理论,其核心思想是将复杂问题分解给多个「专家」子网络,由一个门控网络(Gating Network)动态决定哪些专家参与特定输入的处理。在大型语言模型领域,MoE已成为主流扩展范式之一:Google的Switch Transformer通过将前馈层替换为稀疏专家层,在相同计算预算下实现了参数规模的数量级提升;Mistral的Mixtral 8x7B则将这一架构推向了开源社区,每次推理仅激活8个专家中的2个,在大幅降低推理成本的同时保持了接近70B密集模型的能力水平;据多方报道,GPT-4同样采用了类似的稀疏MoE设计。这些「模型内部MoE」的核心优势在于:总参数量决定知识容量上限,而激活参数量决定单次推理成本,两者得以解耦。与此不同,视频所展示的是「系统级MoE」,即将多个完整独立的模型作为专家节点,通过外部编排层进行任务路由与结果聚合。这种方式更接近集成学习(Ensemble Learning)中的Mixture of Models范式,工程实现门槛较低,无需触及模型内部结构,但如何设计高效的路由策略(让正确的模型处理正确的任务类型)和结果融合机制(如何加权、裁决不同模型的输出),仍是决定系统实际效果的核心挑战。
具体流程是:用户输入一个提示词,该提示词会经过多个不同模型的处理,最终由系统汇总成一个「更优」的答案。作者反复使用的比喻是——「如果一个天才和五个天才比赛,通常五人团队会给出更好的答案。」
多模型协作的现有实践:这一思路在工程实践中并不陌生,已有多项有据可查的研究为其提供了理论背书。在推理质量提升方面,「自洽性(Self-Consistency)」方法由Wang等人于2022年在Google Brain发表,通过对同一问题进行多次独立采样并取多数投票,在GSM8K等数学推理基准上将准确率提升了17个百分点以上;其背后的统计学直觉是:单次生成可能因随机性偏向错误路径,而多次采样的聚合结果更能逼近真实答案。更进一步的「LLM辩论(LLM Debate)」范式(Du等人,2023)让多个模型实例相互审查彼此答案并提出质疑,被证明能在事实核查和数学推理任务上提升最终输出的准确性。在工业实践中,微软开源的AutoGen框架通过定义「AssistantAgent」与「UserProxyAgent」等角色,支持多Agent对话式协作完成代码编写、调试和研究任务;斯坦福大学的「Generative Agents」实验则让25个GPT-4实例在模拟小镇中自主交互,涌现出计划协调、信息传播等社会行为。这些案例共同支撑了「多个推理视角优于单一视角」的论断,但关键前提是:多模型系统的协调开销——包括额外的API调用延迟、成本叠加、错误在链式调用中的累积放大——必须低于其带来的质量增益。这一平衡点在实际部署中并不总能自然满足,不同模型在不同任务上各有所长的互补性假设,也需要针对具体任务类型进行严格的实证评估,而非想当然地认为「越多越好」。
与Agent能力的深度结合
视频的另一个重点是将混合专家系统与Hermes Agent的自主执行能力相结合。作者宣称Hermes Agent是「全球最流行、最强大的开源免费智能体」,当把它的Agent能力(如电脑操作、浏览器控制、语音交互)与多模型混合推理叠加时,能构建出相当强大的自动化工作流。
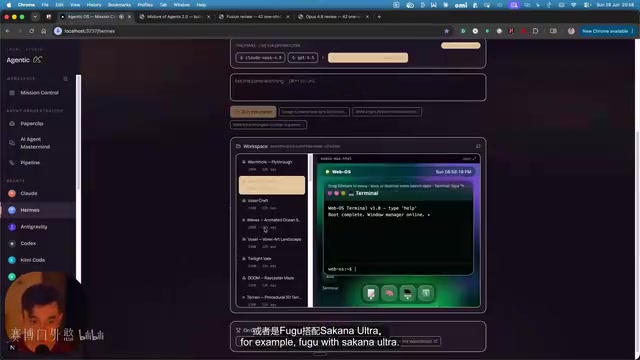
AgentOS:把复杂命令封装成可视化工作区
为了降低使用门槛,作者开发了一个名为「Hermes AgentOS」的操作系统层。原本需要在终端里运行的混合代理命令,现已被封装进图形化界面,极大降低了普通用户的上手成本。
AI操作系统层的行业背景:「AgentOS」这一概念折射出当前AI应用的一个重要演化方向:从单一对话界面向完整「AI操作系统」层迁移。理解这一趋势需要追溯LLM能力边界的扩展历程——早期的ChatGPT以纯文本对话为主,能力边界止步于语言生成;随着Function Calling(2023年6月OpenAI引入)、Code Interpreter和Computer Use等能力的相继落地,模型开始具备调用外部工具、执行代码、操控GUI的能力,交互范式随之从「聊天框」向「操作系统外壳」演进。代表性案例包括:Cognition AI的Devin试图构建完整的软件工程Agent环境,能自主完成从需求分析到代码部署的完整链路;Adept AI的ACT-1专注于GUI操作自动化,通过直接解析屏幕像素来操控任意桌面应用;OpenAI的Operator和Anthropic的Computer Use则将模型能力直接延伸至浏览器和桌面操控。这些系统的共同目标是将「提示词+工具调用」的低层交互,封装为用户友好的可视化工作流,降低非技术用户的使用门槛。然而这种封装也引入了新的风险层:自动化操作的权限边界(Agent能访问哪些系统资源?)、错误恢复机制(当中间步骤失败时如何回滚?)和审计追踪(谁对自动化操作的后果负责?),均是此类系统在企业场景落地时必须正视的核心工程挑战,目前业界尚未形成统一的最佳实践。
主要功能模块
从演示来看,这套AgentOS整合了丰富的功能模块:
- 混合推理面板(Panel):输入提示词即可调用多模型协作,无需终端命令
- 自动工作区保存:所有生成内容自动保存,方便预览和回溯
- 对话与语音模式:内置「Hermes Jarvis」,支持语音控制、电脑操作和浏览器自动化
- 内容创作工具:包含Studio、语言机(获取最新资讯并起草内容)等模块
- 完整OS体验:系统能自行构建Windows风格的应用界面,包含文件、编辑、终端等菜单
作者举了一个实际应用场景:做销售外联时,可以用这套系统一键搭建SaaS工具、获取潜在客户、构建邮件营销活动并自动发送——整个链条集成在一个平台完成。
这种「端到端集成」的思路契合了当前Agent产品的发展方向,即从单点工具走向完整的自动化工作流平台。
模型无关性:系统架构的核心价值
不被单一模型绑架
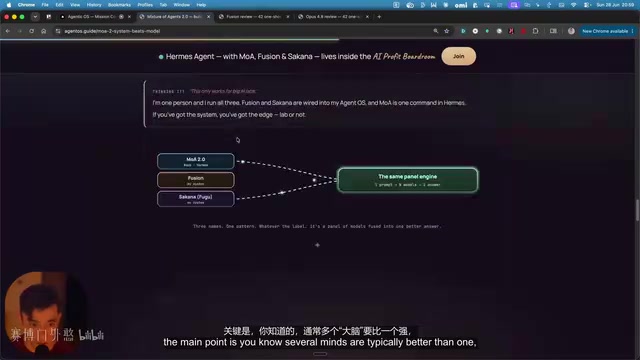
这套系统最值得关注的设计理念,是其「模型无关性(Model-Agnostic)」。作者反复强调:无论调用的是哪个模型——Fable 5、GPT-5,还是即将发布的新版本——工作原理始终一致,都是智能体集合在协同运作。
模型无关性的工程价值:「模型无关性」是软件工程中「关注点分离(Separation of Concerns)」原则在AI系统层面的具体体现,其重要性在过去两年被LLM市场的急剧变动反复印证。2023年以来,主流模型的迭代周期已从年级压缩至数月甚至数周:OpenAI在一年内发布了GPT-3.5、GPT-4、GPT-4 Turbo、GPT-4o等多个主要版本,Anthropic的Claude系列在同期经历了从Claude 1到Claude 3.5的三次大版本跨越,API接口参数、定价策略、上下文窗口长度和可用性均处于持续变动中。将业务逻辑与具体模型深度耦合——比如在代码中硬编码模型名称、依赖特定模型的输出格式习惯——意味着每次供应商的重大更新都可能引发系统级重构,增加维护成本和停机风险。以此为背景,LangChain和LlamaIndex等主流Agent框架均将模型无关性作为核心设计目标:LangChain通过统一的BaseChatModel抽象层屏蔽各家API差异,使得在OpenAI、Anthropic、Cohere或本地Ollama模型之间切换只需修改一行配置。从运维可靠性角度看,模型无关架构还天然支持「模型降级(Model Fallback)」策略——当首选模型因过载、故障或成本超限而不可用时,可自动切换至备用模型,这在企业级AI部署中已成为高可用性设计的标配要求,与传统软件工程中的「熔断器(Circuit Breaker)」模式如出一辙。
这意味着当新模型发布时,只需直接接入系统即可,核心业务逻辑保持不变。系统同时配有记忆功能,确保上下文在不同模型之间顺畅延续。
从工程视角看,这种解耦设计具有合理性:它把「模型选择」变成可插拔的配置项,让开发者专注于业务系统本身,而非疲于应对模型的频繁变更与可用性风险。
成本灵活性
作者还提出了一个实用观点:不必非用昂贵的顶级模型。可以使用免费API、本地开源模型,甚至让多个低成本模型协同工作。核心逻辑仍是「多个大脑胜过一个」——通过混合多种轻量模型,理论上可以在整体输出质量上超越单一旗舰模型,同时大幅降低推理成本。
这一主张在经济账上颇具吸引力:以2024年底的定价为参照,GPT-4o的输入token成本约为$2.5/百万token,而Llama 3.1 70B的本地部署或通过Groq等平台调用的成本可低至$0.59/百万token甚至更低。若多个低成本模型的协同输出确实能逼近旗舰模型水平,其性价比优势将十分显著。但这一「理论上」的前提需要强调:协作本身会引入额外的API调用次数和编排延迟,多模型调用的总成本叠加效应必须在实际任务上进行精细核算,而非简单假设「便宜模型多调几次一定更划算」。
理性评估:架构启示与营销边界
需要审慎对待的部分
尽管核心理念有可取之处,这段演示中仍存在明显的营销色彩,读者需保持清醒判断:
数据可信度存疑:视频中提到的测试数据——「测试了42个不同模型」「在GoldieBench上碾压一切」「191页推荐信」——均缺乏可验证的第三方来源,作者自己也承认是「今天才搞出来的」,测试完全依赖个人演示。
模型名称失实:文中出现的「Cloud Opus 4.8」「GPT-5.6」「Nexus Research多智能体混合模型」等,多为不存在或未经证实的产品,这直接削弱了对比数据的可信度。
商业转化意图明显:视频末尾大力推广「课堂页面」「每周教练电话会议」「付费社群」等内容,提示该演示可能更多服务于商业转化,而非纯粹的技术分享。
识别AI演示中的营销模式:视频演示与课程销售相结合的商业模式,在AI内容创作领域已形成一套高度模板化的范式,理解其运作机制有助于读者建立有效的信息过滤框架。这一模式的兴起有其时代背景:2023年ChatGPT引发的AI热潮催生了巨大的「AI焦虑」市场需求——大量非技术背景的从业者迫切希望快速掌握AI应用能力,愿意为清晰易懂的教程和社群支持付费。在此背景下,典型的「AI大师」内容套路呈现出几个可识别的特征:以独家命名的「系统」或「方法论」(如「Hermes 2.0」「X框架」)制造差异化感知,暗示掌握此方法即可超越普通从业者;引用无法独立核实的性能数据(自建基准、内部测试)来支撑优越性宣称;展示令人印象深刻但难以在受控条件下复现的一次性演示;以及通过「社群+定期教练」体系完成持续的商业转化。评估AI技术演示内容可信度的实用标准包括:性能测试是否使用公认的第三方基准(如推理能力的MMLU、HumanEval,对话质量的LMSYS Chatbot Arena,或特定领域的行业标准数据集);演示流程是否足够透明以供独立复现;作者是否坦诚披露系统的失败案例、局限性和适用边界。在AI内容泛滥的当下,具备这种对技术宣称的元认知审视能力,本身已成为开发者和从业者的核心竞争力之一。
值得借鉴的架构思路
抛开营销包装,「构建模型无关的Agent系统」这一核心主张本身是成立的。在多模型时代,将业务能力与具体模型解耦、通过多模型协作提升系统鲁棒性和输出质量,是许多严肃AI工程团队正在积极探索的方向。LangGraph、CrewAI、AutoGen等开源框架的快速发展,以及企业级AI平台普遍内置的「模型路由」和「模型降级」功能,均印证了这一方向的工程合理性。开发者可从中提取有价值的架构启示,但对具体性能宣称应保持独立验证意识,以自身在真实任务场景上的实测结果为最终判断依据。
总结
Hermes 2.0混合系统展示了一种「以系统架构取胜」的AI应用构建思路:通过多模型协同推理、模型无关性设计和可视化操作层,试图在不依赖单一前沿模型的前提下获得更优的整体输出。这一理念契合了当前多智能体开发的主流趋势,具有一定参考价值。
但其大量性能宣称缺乏独立验证,且伴随明显的课程营销意图。建议开发者取其架构思路之长,对具体数据保持审慎,最终以自身实测结果为准。
核心要点
核心要点
相关推荐
B站最细Codex保姆级攻略:从安装到实战全解析
B站最细Codex保姆级攻略:从应用商店安装到日常工作模式配置,用真实咖啡馆项目演示文件整理、数据提取、仪表盘制作等实战任务,教你用计划模式和桌面宠物高效使用Codex。

体渲染中的外观补偿:为何RGB准确无法保证密度正确
体渲染研究揭示:完美复现外部RGB视图的体数据仍可能存在密度错误。外观补偿机制使中心密度翻倍、L2误差超14.52%时外部射线仍不变,密度恢复依赖外观容量、空间分辨率与测量设计。

TMLE与AIPW的样本分割选择:交叉拟合与重复分割的影响
一项TMLE与AIPW模拟研究发现,样本分割方式显著影响区间覆盖率:样本内拟合倾向得分可使覆盖率跌至0.12-0.48,双nuisance交叉拟合则恢复至0.91-1.00;近正性下AIPW优于未加权TMLE,重复划分降低划分依赖但使区间更保守。