混元Hy3开源+GPT-5.6曝光+日本机器人战略:AI多线突破

AI领域近日再度迎来密集更新,从国产大模型的开源突破到OpenAI下一代产品的提前泄密,从实时语音识别的技术升级到国家级机器人战略的落地,多条重磅消息接踵而至。本文逐一梳理这些进展,并分析其背后的技术趋势与产业意义。
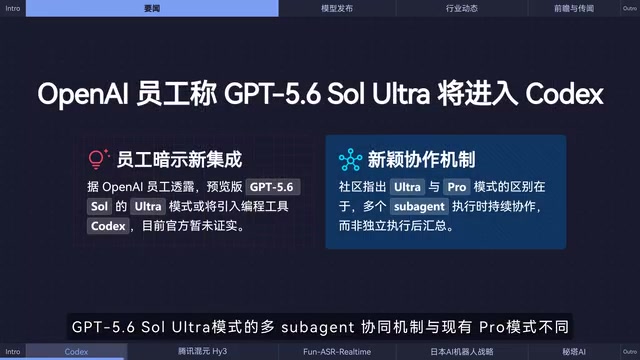
GPT-5.6 Sol Ultra 或将登陆 Codex
据 Codex 负责人 Tibo 透露,GPT-5.6 Sol Ultra 将会在 Codex 中提供。这一消息在 OpenAI 内部人士的深夜爆料中得到进一步印证,迅速引发开发者社区的高度关注。
根据已披露的信息,GPT-5.6 Sol Ultra 最大的技术亮点在于多 Subagents(子智能体)协同机制,与现有 Pro 模式存在本质区别。传统单一模型推理在处理复杂编程任务时,常面临上下文管理和任务拆解的瓶颈;而多子智能体协同通过将大任务分解为可并行处理的子任务,由不同智能体分工完成后汇总结果,有效突破这一局限。
多子智能体(Multi-Subagent)协同机制源于多智能体系统(Multi-Agent Systems, MAS)研究领域——其学术根源可追溯至1980年代的分布式人工智能研究,历经数十年演进后在大语言模型时代焕发出新的工程价值。在当前LLM语境下,每个子智能体本质上是同一基础模型的不同实例或经过专门提示词调教的变体,分别承担代码生成、测试编写、文档撰写、代码审查等子任务。与单一模型顺序推理相比,多智能体架构的优势在于:一是突破单次推理的上下文长度限制;二是允许并行计算,降低端到端延迟;三是通过交叉校验机制减少幻觉和错误。
值得注意的是,编排多个LLM实例还面临独特的工程挑战:智能体间通信协议的设计、上下文状态的一致性维护、错误传播的隔离机制,以及如何防止多个智能体在推理链路上产生相互强化的幻觉(即"幻觉放大效应")。OpenAI Codex作为面向代码生成的专用平台,其任务结构天然适合多智能体拆解——一个复杂软件需求可分解为架构设计、模块实现、单元测试、集成验证等彼此依赖又可部分并行的子任务,每个子智能体聚焦单一职责,最终由协调器(Orchestrator)整合输出。OpenAI、Anthropic、Google 等头部厂商均已在不同程度上探索 Agent 编排框架,如 OpenAI 的 Swarm 框架和 Anthropic 的 Claude 工具调用链。
这一架构思路与近年来 Agent(智能体)范式的兴起一脉相承。一旦多智能体协同真正落地 Codex 编程场景,AI 编程助手将从"辅助补全"迈向"自主完成复杂工程任务"的新阶段,对开发者而言或是继 GPT-4 系列之后又一次显著的生产力跃升。
腾讯混元 Hy3 正式版开源,性能对标更大模型
国产大模型阵营中,腾讯此次动作尤为引人注目。腾讯混元发布并开源了混元 3 大模型正式版,采用 MoE(混合专家)架构,总参数达 295B,激活参数为 21B,支持 256K 超长上下文窗口。
官方称其性能可比肩参数规模大 2 至 5 倍的旗舰模型。这一表现背后体现的是 MoE 架构的核心优势——稀疏激活机制使模型推理时仅调用 21B 参数,却能保持接近甚至超越稠密大模型的效果,在性能与推理成本之间取得更优平衡。
混合专家模型(Mixture of Experts, MoE)的核心创新在于"稀疏激活":模型拥有大量参数(专家网络),但每次推理时仅激活其中一小部分。以混元 3 为例,295B 总参数中每次推理仅激活 21B,激活比例约为 7%。这一机制由轻量级的"门控网络"(Gating Network)负责动态路由,根据输入 token 的特征决定分配给哪些专家处理。MoE 架构最早可追溯至 1991 年的学术研究,但真正在大模型中规模化应用始于 Google 的 Switch Transformer(2021 年),随后 Mistral 的 Mixtral 8x7B 将其带入开源社区。
然而 MoE 架构在大规模训练和推理中并非没有工程难题。其一是"专家坍塌"现象,即门控网络倾向于反复选择同一批专家,导致其他专家训练不足;其二是分布式推理时的通信开销,不同专家可能分布在不同计算节点,token 路由需要跨节点数据传输(All-to-All通信),对网络带宽要求极高。负载均衡(避免部分专家过载而其他专家闲置)因此成为衡量 MoE 模型成熟度的重要指标。从商业角度看,混元 3 较低的激活参数意味着单次推理的 GPU 显存占用和算力消耗更接近 21B 稠密模型,极大降低了企业私有化部署的硬件门槛——这正是其"性能比肩更大模型、推理成本控制在小模型水平"价值主张的底层逻辑。
另一个值得关注的改进是,正式版相较于预览版幻觉率大幅降低。幻觉问题长期是大语言模型落地企业级应用的核心障碍,混元 3 在这一维度的优化显著提升了其在生产环境中的实用性。

目前,混元 3 已在腾讯云 API、元宝以及 WorkBuddy广告 等多个平台上线。"开源+云服务+终端产品"的多路径布局,既通过开源扩大了技术影响力和开发者生态,又通过商业化产品实现了价值闭环,是国产大模型厂商走向成熟的商业策略体现。
阿里 FunASR Realtime 实时语音识别全面升级
在语音识别领域,阿里宣布正式升级实时语音识别模型 FunASR Realtime,核心指标令人印象深刻:首字延迟仅百毫秒,准确率接近离线水平。
实时语音识别的技术难点在于如何在极低延迟下保证识别精度。离线模型可在获取完整音频后进行双向上下文建模(如双向 Transformer/LSTM),充分利用前后文信息纠正识别错误;而实时模型只能基于已接收的音频片段进行单向推理,天然存在精度损失。
流式语音识别(Streaming ASR)的核心架构经历了从 RNN-T(Recurrent Neural Network Transducer)到 Conformer 再到流式 Transformer 的演进历程。RNN-T 因其天然的流式特性长期是工业界主流选择,但建模能力受限;Conformer(卷积增强Transformer)在准确率上大幅提升,但其双向注意力机制与实时推理存在根本矛盾。FunASR 采用的"流式-离线一体化"框架(UniASR 思路)通过动态 chunk-size 训练,让同一模型既能在流式模式下低延迟运行,又能在离线模式下充分利用全局上下文——这种训练范式使模型在推理阶段可灵活切换两种模式,而非维护两套独立参数,工程维护成本显著降低。在技术细节上,Chunk-based(分块)处理策略在维持因果推理的同时引入有限的右侧上下文 lookahead,兼顾延迟与精度。"首字延迟仅百毫秒"在技术层面意味着系统端到端处理时延(含音频缓冲、特征提取、模型推理、解码)需在单个音频帧(通常10-20ms)累积约5-10帧时即启动首次输出,对于直播字幕、实时翻译等场景至关重要。
此外,该模型支持 16 种方言和 30 种语言,展现了强大的多语种适应能力,对覆盖中国复杂语言环境及国际化场景均有重要意义。支持 16 种方言背后,需要海量方言标注数据和多任务学习训练策略的共同支撑,也体现了阿里在中文语音数据积累上的深厚底蕴。

目前该模型已应用于知名内容团队"影视飓风"的直播场景,并上线阿里云广告百炼平台。直播实时字幕是对延迟和准确率要求极为严苛的场景,在此成功落地,充分验证了其技术成熟度。
日本国家级机器人战略:2040 年部署千万台
将视野转向产业政策层面,日本经济产业省近日修订 AI 机器人战略计划,展现了应对社会挑战的宏大布局。
根据该计划,日本目标在 2040 年于制造、护理等 18 个行业部署约 1000 万个 AI 机器人,以应对日益严峻的劳动力短缺问题。为此,政府将投入 3800 亿日元,委托 Notra 等企业开发"物理 AI"(Physical AI),并建立全国机器人中心。
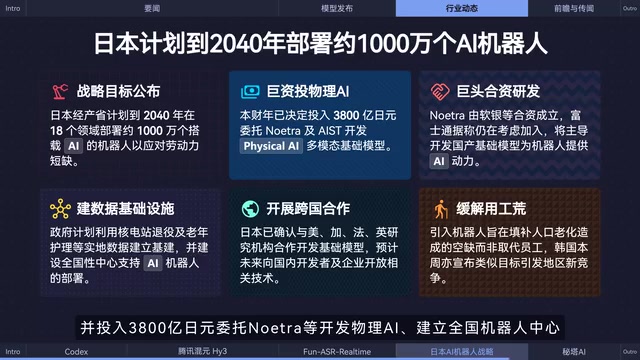
这一战略的深层背景是日本严重的人口老龄化与劳动力萎缩。日本 65 岁以上人口占比已超 29%,居全球最高,同时其制造业机器人保有量长期全球领先,发那科、安川电机、川崎重工等均为顶级机器人企业,具备坚实的产业基础。
"物理 AI"(Physical AI)这一术语由 NVIDIA CEO 黄仁勋在 2024 年 CES 主题演讲中系统阐述,指能够理解并作用于物理世界的 AI 系统,具身机器人是其最典型的载体。相较于纯软件 AI,物理 AI 面临三大核心技术壁垒:一是感知融合,需整合视觉、触觉、力觉等多模态传感器数据并在毫秒级完成场景理解;二是操作规划(Manipulation Planning),机器人需在高维连续动作空间中实时规划无碰撞轨迹;三是 sim-to-real 迁移(模拟到真实环境的泛化),在仿真环境中训练的策略往往因物理参数偏差(如摩擦系数、接触动力学)在真实场景中失效,领域随机化(Domain Randomization)和真实数据微调是主要解决路径。日本 3800 亿日元的投入预计将催生机器人本体制造、AI 软件栈、传感器、边缘计算芯片及系统集成服务的完整产业链大规模扩张,其中 AI 软件栈和边缘推理芯片是国际竞争最为激烈的环节。日本此次的国家级布局,折射出全球范围内具身智能(Embodied AI)正从实验室走向规模化产业应用的大趋势。
Meta 医学 AI 产品开放内测
Meta AI 近日宣布,其正在研发的医学 AI 产品开放内测,面向医生、医学生和医学研究员,通过微信群形式邀请专业人士体验并反馈。
医学领域对 AI 的准确性与可靠性要求极高,任何幻觉或错误都可能带来严重后果。医学 AI 的核心挑战不仅在于知识的准确性,还包括对临床推理逻辑的理解、对医学文献的实时追踪以及对罕见病例的泛化能力。
从监管层面看,医疗 AI 软件在全球主要市场均面临严格合规要求:美国 FDA 将其纳入 SaMD(Software as a Medical Device)框架,需经历 510(k) 预市场通告或更严格的 PMA 审批;欧盟 MDR 和中国国家药监局的相关指导原则亦对模型可解释性、数据集代表性及上市后持续监控提出明确要求。Meta 选择先向专业医疗人群定向开放内测,本质上是在监管正式介入前建立"专家验证闭环"——专业用户的反馈不仅用于提升模型性能,更是积累真实世界证据(Real-World Evidence)的必要步骤,这些证据将成为未来申请医疗器械认证时的重要支撑材料。通过微信群等私域渠道进行定向邀测,也有效控制了潜在误用风险,是一种务实且负责任的迭代路径,也是规避监管风险、建立医疗行业信任的必要步骤。
总结
从上述多条资讯可以看出,AI 产业正在多个维度同步推进:
- 基础模型层面:国产开源模型(混元 3)正以 MoE 架构的效率优势追赶乃至挑战国际旗舰模型,稀疏激活机制使"小激活参数、大能力边界"成为可能;
- 智能体范式:OpenAI 的多子智能体协同机制预示着 AI 从单点工具向"自主执行者"持续演进,任务并行分解将重塑软件工程生产流程;
- 垂直应用层面:语音识别突破流式处理的精度瓶颈、医学 AI 谨慎落地,专业场景对准确性的极致要求正倒逼技术进步;
- 产业政策层面:日本国家级机器人战略以具身智能应对老龄化社会挑战,揭示了 Physical AI 从实验室走向千万台规模部署的产业路径。
这些看似分散的进展,共同勾勒出 AI 技术从底层模型到上层应用、从虚拟世界到物理世界全面渗透的清晰图景。
相关推荐

用n8n打造AI每日新闻简报:20秒告别信息过载
一位 YouTube 创作者用 n8n 搭建 AI 每日新闻简报工作流:RSS 抓取路透社头条、AI 去标题党并摘要、写入 Supabase 数据库、推送 Telegram,20 秒读完全球资讯。本文拆解其实现逻辑与借鉴价值。

Zapier、Make、n8n实测对比:同一AI工作流三次翻车
Zapier、Make、n8n三款自动化工具实测对比:用同一个AI线索分类工作流各搭一遍,三者全部翻车。深度拆解搭建时间、运行速度、计费逻辑及各自的静默失败陷阱,帮你选对AI自动化平台。

用n8n搭建AI内容引擎:全自动运营Facebook主页实战
一位创作者用开源工具n8n搭建AI内容引擎,实现Facebook主页全自动运营:选题、写作、配图、审核、发布五步流水线,287篇写出238篇发布,拆解其人机分工逻辑与可复制性。