Hy ASR 3.0技术报告:LLM驱动的多方言语音识别新突破
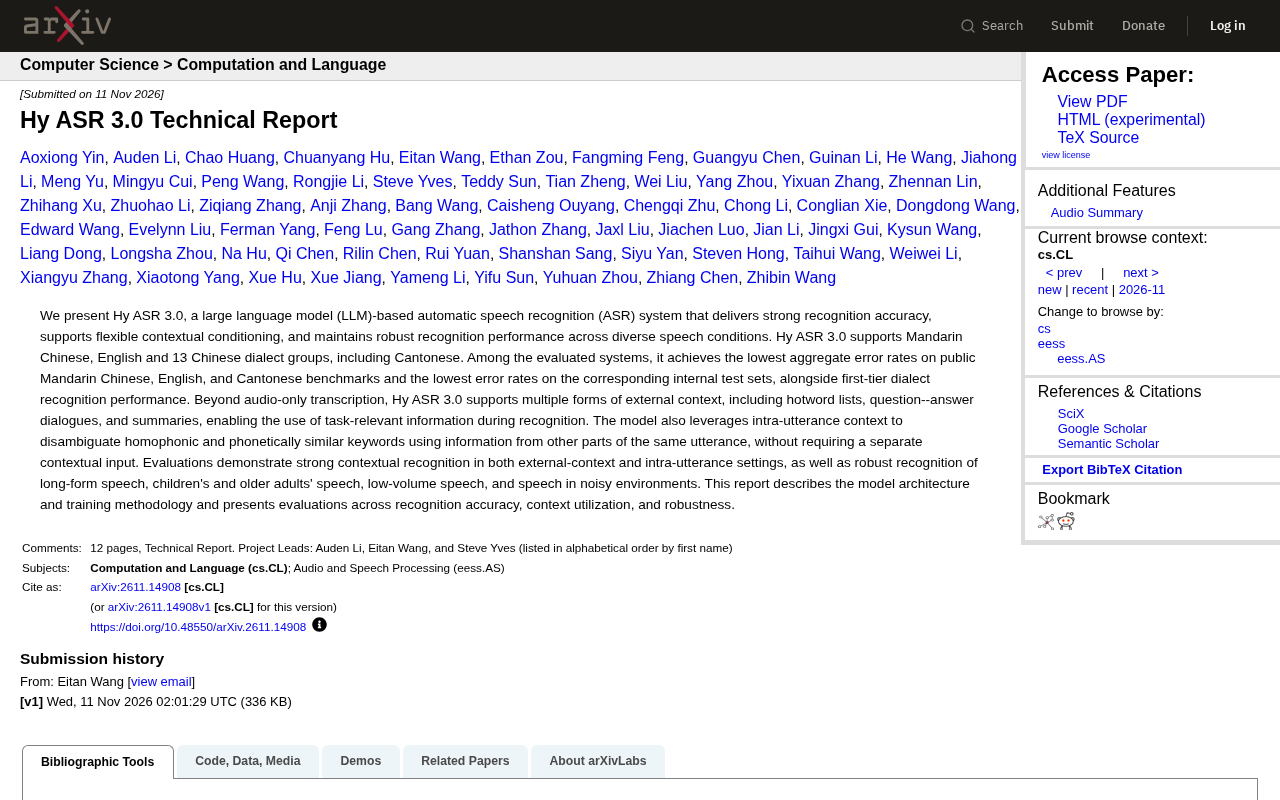
Hy ASR 3.0 以 LLM 为识别主干,通过多形态上下文注入提升多语言多方言识别能力。
Hy ASR 3.0 是一套以大型语言模型为识别主干的语音识别系统,覆盖普通话、英语及 13 个汉语方言组。其核心思路是打破传统 ASR 声学模型与语言模型割裂的流水线,让语言模型的世界知识与上下文建模能力直接参与识别决策。系统支持热词列表、问答对话、摘要三种外部上下文输入,并利用句内上下文消歧同音词,从而在不重新训练的情况下适配会议记录、客服质检、医疗口述等差异极大的任务。技术报告称其在公开的普通话、英语、粤语基准及内部测试集上取得最低综合错误率,并在长语音、儿童与老年人语音、低音量和噪声环境下保持稳健。但报告未披露模型规模、推理成本与延迟,结论亦缺乏第三方独立验证。
从语音识别到语境理解:Hy ASR 3.0 的核心思路
传统 ASR 系统长期受限于"听清"而非"听懂"——声学模型负责转写,语言模型负责纠错,两者割裂。Hy ASR 3.0 的出发点是用大语言模型统一这一流程,让识别过程本身具备语境推理能力。据其技术报告,该系统在公开的普通话、英语和粤语基准上取得了最低的综合错误率,在对应的内部测试集上同样领先,方言识别能力也处于第一梯队。

这套系统覆盖普通话、英语以及 13 个汉语方言组(含粤语),定位并非单一场景的转写工具,而是面向多语言、多口音环境的通用识别底座。
ASR(自动语音识别) 是把语音信号转写成文本的技术,其经典架构由声学模型、发音词典和语言模型三部分组成。声学模型负责把音频帧映射为音素或子词单元,语言模型则对候选词序列打分以挑选最可能的句子。这种流水线式设计的局限在于:声学模型只关心"听起来像什么",语言模型只关心"文本是否通顺",二者之间缺少对具体对话语境的联合推理。因此传统系统面对同音词、专有名词、口音变体时,往往需要额外的纠错模块或人工热词表来补救。Hy ASR 3.0 所主张的"LLM-based ASR",正是试图用一个大模型同时承担声学映射与语言推理,把割裂的两段流程合并为端到端的语境化识别。
架构与训练:LLM 作为识别主干
报告披露的模型设计围绕"LLM-based ASR"展开:以大型语言模型为骨干,将声学特征映射到语言模型的语义空间中完成解码。这一路线的好处在于,语言模型自带的世界知识与上下文建模能力可以直接参与识别决策,而不必依赖外挂的纠错模块。
训练方法论方面,报告强调了对多样语音条件的覆盖,包括长语音、儿童与老年人语音、低音量语音以及噪声环境。这些场景恰恰是传统 ASR 最容易失守的边界,把它们纳入训练目标,说明 Hy ASR 3.0 追求的是稳健性而非单一 benchmark 的分数。有意思的是,报告并未公布具体的模型参数量或训练数据规模,评估结论主要建立在错误率对比之上。
声学特征到语义空间的映射是 LLM-based ASR 的关键环节。常见做法是先用编码器(如 Conformer 或 Whisper 式编码器)把原始音频压缩为帧级表示,再通过一个投影层或适配器把这些声学向量对齐到语言模型的词嵌入空间,随后由 LLM 以自回归方式逐词解码。这样做的代价是模型规模通常远大于传统 ASR,推理延迟也更高;收益则是语言模型预训练中积累的词汇知识、语法约束和世界知识可以直接作用于识别决策。理解这一点,就能明白为何报告强调"无需外挂纠错模块"——纠错能力已经被内化进主干模型,而不是在识别完成后另起炉灶。
上下文 conditioning:三种外部信息注入方式
Hy ASR 3.0 支持多种外部上下文输入,这是它区别于常规 ASR 的显著特征:
- 热词列表:允许用户预先注入领域词汇,提升专有名词识别准确率;
- 问答对话:以对话形式提供任务相关信息,引导识别偏向特定语境;
- 摘要:用一段摘要概括待识别内容的主题,帮助模型在解码时做出更合理的词汇选择。
这意味着同一个模型可以通过不同的上下文输入适配会议记录、客服质检、医疗口述等差异极大的任务,而无需重新训练。报告称在外部上下文与句内上下文两种设定下均展现出较强的上下文识别能力。
句内上下文:不依赖外部输入的消歧
一个更巧妙的设计是利用话语内部上下文来消歧同音词和音近关键词。例如同一句话中后文出现的线索可以帮助判断前文某个发音对应的正确词汇,整个过程不需要额外的上下文输入。这相当于把"语境"从外部提示内化为模型自身的推理能力,在缺少热词表或摘要的裸场景下依然能提升准确率。
同音词消歧是中文 ASR 的经典难点。汉语音节数量有限而汉字众多,"公式/攻势/工事"、"期中/期终"等发音完全相同,仅凭声学信号无法区分。传统方案依赖 n-gram 语言模型给出的局部概率,容易在长句或专业语境中出错。句内上下文消歧的思路是让模型利用同一句话中后文出现的语义线索反向约束前文的选词,本质上是一种双向的语境推理。这与外部热词表形成互补:热词表解决"领域词汇不认识"的问题,句内消歧解决"认识但选错了"的问题。两者叠加,才构成报告所称的"上下文识别能力"的完整图景。
稳健性评估:真实世界的语音并不标准
报告的评估维度分为三块:识别准确率、上下文利用能力、稳健性。稳健性部分覆盖了长语音、儿童与老年人语音、低音量语音和噪声环境语音。这些条件的共同点是偏离了朗读式标准语音的分布——儿童与老年人的发音习惯、低音量导致的信噪比下降、噪声干扰,都会显著拉低常规系统的表现。
Hy ASR 3.0 声称在这些条件下均保持稳健识别。从工程视角看,这类稳健性往往比 benchmark 上的零点几个百分点的错误率差距更有实际价值,因为真实部署中的语音输入几乎不会像测试集那样干净。
多源视角下的定位与待解问题
目前关于 Hy ASR 3.0 的公开信息主要来自其技术报告本身,属于单一来源。报告给出的结论——公开基准最低综合错误率、内部测试集领先、方言识别第一梯队——尚缺乏第三方独立复现的交叉验证,读者在引用这些结论时应保留这一前提。
从技术路线看,LLM-based ASR 正成为语音识别领域的主流方向之一,Hy ASR 3.0 的差异化在于把上下文 conditioning 做成了多形态(热词、问答、摘要)加句内自消歧的组合拳。不过报告未披露模型规模、推理成本与延迟等部署关键指标,这些恰是评估一套 ASR 系统能否落地的核心变量。对于关注多方言识别与上下文增强识别的团队,这份报告提供了值得跟进的技术思路,但距离完整的工程评估仍有距离。
相关推荐
Jingle Jam 2026 报名开启:Lewis 用旧素材喊你组队募捐
Jingle Jam 2026 募捐报名已开放。Lewis 用旧素材剪辑成新视频,号召观众在 jingle jam.tiltify.com 建立募捐页面,支持八家慈善机构,活动于 12 月前两周举行。
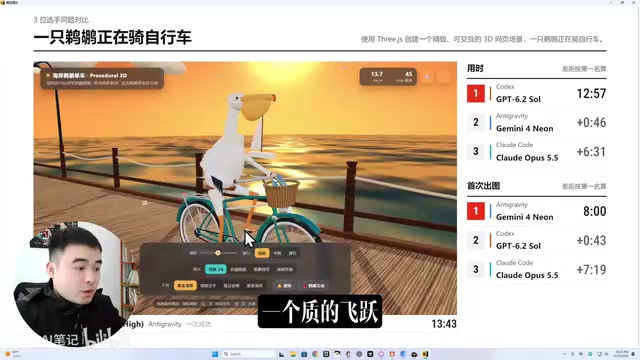
Gemini 4 Neon实测:能否平替Claude Opus 5.5?
B站UP主用三款AI Agent工具同题实测Gemini 4 Neon、Claude Opus 5.5和GPT 6.2,从鹈鹕动画、3D赛车到代码生成视频,看Gemini 4 Neon能否平替Opus 5.5。
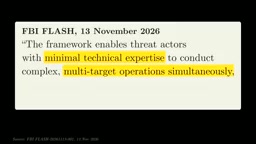
FBI警告的Artex:无自研模型的AI攻击框架如何撬开企业大门
FBI警告的开源AI攻击框架Artex没有自研模型,靠接入Claude、GPT等外部大模型驱动代理循环,把Nmap等普通工具变成自动化攻击流水线。本文梳理韩国金融业、ConnectWise、Barracuda三起真实案例,解析速度、成本与噪音三重原因,并给出暴露面清点、短时效凭据等防御要点。