IAU-FOA:突破闭源多模态大模型的可迁移对抗攻击新方法

IAU-FOA通过全局余弦对齐与局部最优传输双层策略,大幅提升对闭源多模态大模型的黑盒对抗攻击迁移能力。
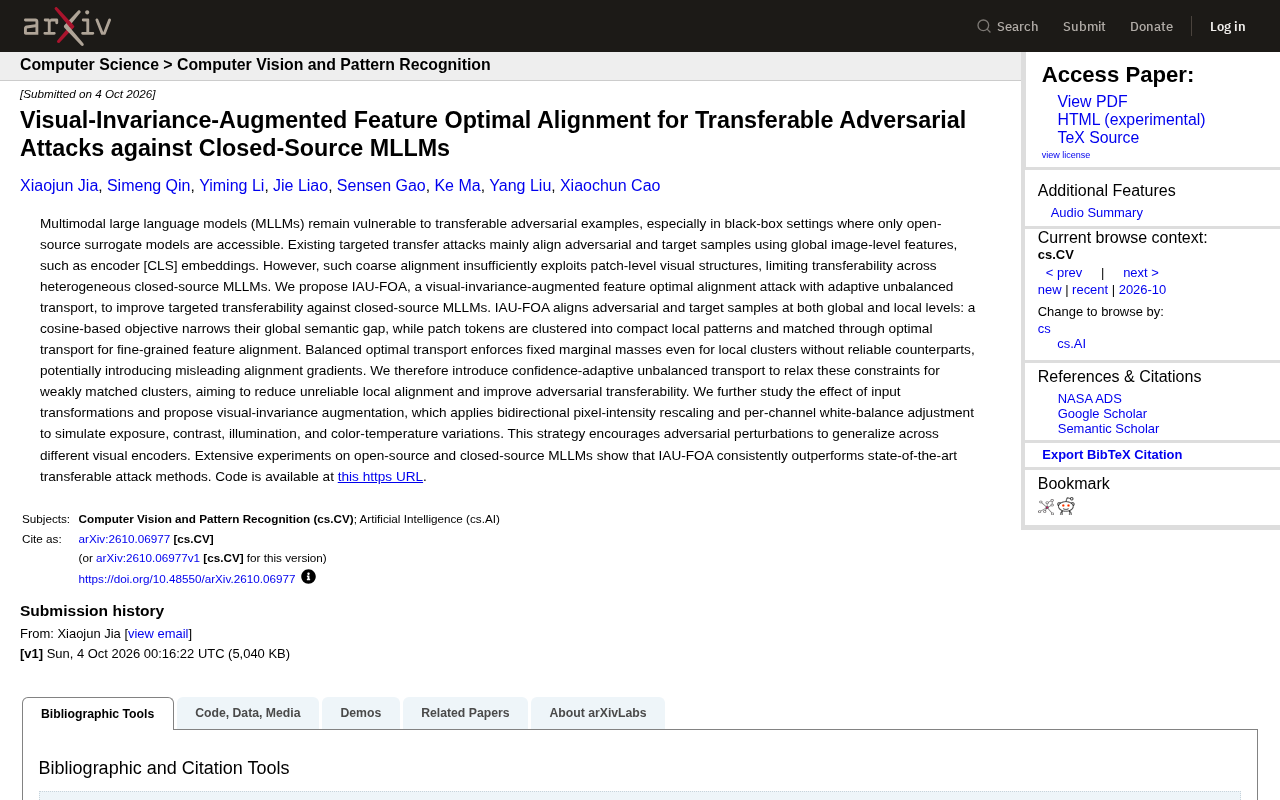
IAU-FOA是一种针对闭源多模态大语言模型(MLLMs)的可迁移黑盒对抗攻击方法。现有方法仅依赖全局图像特征(如[CLS]嵌入)进行对齐,在跨架构迁移时效果有限。IAU-FOA通过两项核心创新加以改进:一是结合全局余弦相似度目标与patch级最优传输的双层特征对齐,二是引入置信度自适应非平衡传输,放松弱匹配局部簇的约束以减少误导性梯度。此外,方法还提出视觉不变性增强策略,通过双向像素强度缩放和逐通道白平衡调整模拟真实视觉变化,促使对抗扰动跨编码器泛化。实验结果表明,IAU-FOA在多个开源与闭源MLLMs上均优于当前最先进方法,揭示了商业闭源模型面临的现实攻击风险,并为防御研究指明了方向。
闭源多模态大模型的安全盲区
多模态大语言模型(MLLMs)在图文理解、视觉问答等任务上展现出惊人的能力,但它们并非无懈可击。研究表明,这类模型在面对可迁移对抗样本时依然脆弱,尤其是在黑盒攻击场景下——攻击者无法接触目标模型的内部结构,只能依赖开源的替代模型(surrogate models)来构造攻击。
这意味着一个关键的安全问题:攻击者可以利用公开可得的开源模型,生成能够"迁移"到商业闭源模型上的对抗样本。随着越来越多的闭源MLLMs被部署到实际产品中,这种攻击的现实威胁值得整个行业警惕。
现有攻击方法的局限
目前主流的定向迁移攻击(targeted transfer attacks)主要依赖全局图像级特征进行对齐,例如编码器的 [CLS] 嵌入向量。这种做法是将对抗样本与目标样本在整体语义层面拉近。
但论文指出,这种粗粒度的对齐存在明显短板:它没有充分利用图像中的patch级视觉结构(局部块级别的信息)。当攻击需要跨越架构各异的异构闭源MLLMs时,仅靠全局特征对齐,迁移能力会大打折扣。
换句话说,不同的视觉编码器对图像局部细节的处理方式差异很大,只盯着全局语义做文章,攻击样本很难在多种模型间通用。
[CLS] 嵌入向量是 Transformer 架构中的一个特殊标记(Classification Token),最初由 BERT 引入。在视觉 Transformer(ViT)中,图像被切分为固定大小的 patch(如 16×16 像素),每个 patch 被映射为一个 token,而 [CLS] token 则被拼接在序列开头,经过多层自注意力后汇聚全图的语义信息,通常作为图像级别的全局表征用于下游任务。正因如此,以 [CLS] 嵌入为攻击目标是一种自然的选择——只需让对抗样本的全局表征接近目标样本即可。然而,[CLS] token 的聚合过程会丢失大量空间局部信息,不同架构的编码器对局部纹理、边缘等细节的编码方式差异显著,这使得仅对齐 [CLS] 嵌入的攻击在跨架构迁移时泛化能力有限。
IAU-FOA 的核心设计
针对上述问题,研究者提出了 IAU-FOA(Visual-Invariance-Augmented Feature Optimal Alignment with Adaptive Unbalanced Transport),一种结合视觉不变性增强与特征最优对齐的攻击方法。其核心思路是在全局与局部两个层面同时对齐对抗样本和目标样本。
全局与局部双层对齐
在全局层面,IAU-FOA 使用基于余弦相似度的目标函数,缩小对抗样本与目标样本之间的全局语义差距。
在局部层面,方法将 patch tokens 聚类成紧凑的局部模式,并通过**最优传输(Optimal Transport, OT)**进行细粒度的特征匹配。这一步让攻击能够捕捉到图像中的局部视觉结构,弥补了传统方法只看全局的缺陷。
**最优传输(Optimal Transport, OT)**是一种衡量两个概率分布之间"移动代价"的数学框架,源自 19 世纪 Monge 提出的土方搬运问题,现代形式由 Kantorovich 给出。直观上,OT 回答的是"如何以最低总代价,将一堆'沙子'(源分布)搬运成另一种形状(目标分布)"。在机器学习中,OT 常用于度量特征分布之间的距离(即 Wasserstein 距离),因其能感知几何结构而非仅比较直方图,被广泛用于生成模型、域适应等任务。IAU-FOA 将图像的 patch tokens 聚类后视为离散概率分布,通过求解 OT 问题来找到对抗样本局部簇与目标样本局部簇之间的最优匹配方案,从而在局部结构层面实现精细对齐,而不是简单地计算均值特征距离。
置信度自适应的非平衡传输
传统的平衡最优传输(Balanced OT)会强制所有局部簇都保持固定的边际质量,即便某些局部簇在目标样本中根本没有可靠的对应物。这种强行匹配会引入误导性的对齐梯度,反而损害攻击效果。
IAU-FOA 为此引入了置信度自适应非平衡传输(confidence-adaptive unbalanced transport),放松对弱匹配簇的约束。对于那些难以找到可靠对应关系的局部簇,不再强制匹配,从而减少不可靠的局部对齐,提升对抗样本的迁移性。
**平衡最优传输(Balanced OT)**要求源分布与目标分布的边际质量严格守恒——即每一个源簇的"质量"必须被完全分配出去,目标簇的"质量"也必须被完全接收。这在两个分布结构相似时没有问题,但当部分局部簇在目标中找不到合理对应(例如对抗样本中存在某种纹理,而目标图像中完全没有类似结构)时,Balanced OT 会强行为其找一个最近但实际上不匹配的目标簇,产生错误的梯度信号。**非平衡最优传输(Unbalanced OT)**通过在目标函数中引入 KL 散度等惩罚项,允许边际约束被"软性"满足,从而让置信度低的匹配对贡献更小的权重,避免强行对齐带来的噪声梯度干扰整体优化方向。
视觉不变性增强策略
论文的另一大贡献是研究了输入变换对攻击迁移性的影响,并提出了视觉不变性增强(visual-invariance augmentation)。
该策略通过两种手段模拟真实世界中的视觉变化:
- 双向像素强度缩放(bidirectional pixel-intensity rescaling):模拟曝光和对比度的变化;
- 逐通道白平衡调整(per-channel white-balance adjustment):模拟光照和色温的变化。
通过在训练对抗扰动时引入这些变换,IAU-FOA 鼓励生成的扰动能够跨不同视觉编码器泛化。无论目标模型采用何种图像预处理或编码方式,对抗样本都能保持有效性,这正是迁移攻击成功的关键。
实验效果与行业意义
研究者在多个开源和闭源MLLMs上进行了大量实验,结果显示 IAU-FOA 在定向迁移攻击上持续优于当前最先进的方法。相关代码已在 GitHub 开源(https://github.com/jiaxiaojunQAQ/IAU-FOA)。
从安全研究的角度看,这项工作有双重价值。一方面,它揭示了闭源商业MLLMs面临的现实攻击风险,提醒模型提供方不能因为"闭源"就高枕无忧;另一方面,细粒度局部对齐与视觉不变性增强的思路,也为后续的防御研究提供了明确的攻击面——理解攻击如何利用局部特征和视觉变化,才能有针对性地构建更鲁棒的多模态模型。
对于从事AI安全、对抗样本研究的从业者而言,IAU-FOA 的最优传输建模和非平衡约束放松机制,提供了一个值得借鉴的技术范式。
相关推荐

3分钟看懂DeepSeek:从量化私募到开源AI领跑者的崛起之路
3分钟看懂DeepSeek发展史:从幻方量化的算力积累,到V2的MLA推理降本、V3的557.6万美元训练账单、R1开源引爆全球,再到V4与70亿美元A轮融资,梳理深度求索的关键节点与技术路线。

本地文学创作模型PK:Qwen3.8 27B微调版胜出,DeepSeek v4.1表现平淡
B站UP主横向测评七款本地文学创作模型:海明威、HumanLike Chat基于Qwen3.8 27B微调表现最佳,DeepSeek v4.1叙事平淡,东方朔角色混乱垫底。附三道测试题评分与使用建议。

梁文锋的三次豪赌:DeepSeek为何将82%毛利开源?
DeepSeek为何把82%毛利的推理框架DeepInfer开源,又启动千亿融资?从技术路线、国产芯片到组织纯粹性,解析梁文锋的三次豪赌与开源战略背后的商业与理想逻辑。