ICU死亡预测模型:测量时机如何影响可迁移性

ICU死亡预测中生理轨迹特征跨院稳定,观察模式特征迁移易失效。
该研究基于MIMIC-III、MIMIC-IV和eICU多中心数据,在48小时节点预测ICU院内死亡,将特征分为最新值快照(R1)、纵向生理摘要(R2)和测量频率与时机(R3)三层,系统评估其可迁移性。结果显示,生理轨迹特征(R2相对R1)在eICU外部预测中带来稳定改善(log-loss差异-0.00922),而观察模式特征(R3相对R2)在本地有效(-0.00257),迁移后增量不明确(-0.00012),30次bootstrap仅10次支持R3。匹配观察数量的实验进一步表明,测量时机本身携带独立预测信息,分散测量优于随机保留;当测量可用性降低时,R3的增量效果甚至从有益转为有害。研究提示模型评估应将测量条件纳入考量。
引言:预测模型的可迁移性难题
在重症监护室(ICU)中,利用机器学习预测患者死亡风险已有大量研究。然而,一个常被忽视的问题是:模型在源医院表现良好,迁移到新医院后性能为何会下降?一项基于MIMIC-III、MIMIC-IV和eICU多中心数据的研究,系统区分了生理轨迹与观察模式两类特征的预测价值,并揭示测量时机对模型可迁移性的独立影响。
研究设计与特征分层
研究在48小时节点预测院内死亡,采用嵌套表示逐步整合三类信息:
- R1:仅使用最新值快照(latest-value snapshots)
- R2:加入纵向生理摘要(longitudinal physiological summaries)
- R3:进一步纳入测量频率与时机特征
模型在7,762名MetaVision患者上拟合,随后在21,682名MIMIC-IV患者和覆盖204家医院的43,878名eICU患者上做外部评估。关键在于,研究在保持保留观察数量不变的条件下,单独考察测量时机的影响。
嵌套表示(nested representations) 指模型输入特征按信息复杂度和抽象层次逐步叠加的建模策略。本研究中,R1仅含最新值快照,属于“静态横截面”表示;R2在R1基础上加入纵向生理摘要(如趋势斜率、波动范围、累积暴露等),刻画随时间演变的生理状态;R3再纳入测量频率与时机特征,反映数据采集过程本身。这种分层设计的目的是将“患者生理状态”与“观察过程”两类信息解耦,从而在外部验证中分别评估其可迁移性。嵌套表示常用于电子健康记录(EHR)建模,因为EHR数据同时包含临床信号与记录行为,二者混杂会影响模型泛化能力的归因分析。
核心发现:生理轨迹更稳定,观察模式更敏感
生理轨迹的可迁移性
生理轨迹特征(R2相对R1)在eICU外部预测中带来一致的改善,log-loss差异为-0.00922(95% CI -0.01148至-0.00704)。这一改善在跨机构迁移中保持稳定,说明纵向生理变化承载了较为通用的预后信号。
观察模式的脆弱性
观察模式特征(R3相对R2)在本地开发的eICU模型上同样有效(-0.00257,95% CI -0.00370至-0.00146),但从MetaVision迁移后效果不再明确(-0.00012,95% CI -0.00206至+0.00208)。在30次源数据bootstrap重拟合中,仅10次 favoring R3。这说明测量频率和时机特征高度依赖具体机构的监测习惯,跨院迁移时容易失效。
Log-loss(对数损失) 是二分类预测模型常用的评估指标,定义为真实标签下预测概率的负对数似然,取值越低越好。与AUC不同,log-loss同时惩罚错误分类和过度自信的概率估计,对模型校准质量敏感,因此常用于比较不同特征集对预测概率分布的改善程度。本研究中报告的是配对log-loss差异(如R2相对R1),负值表示新特征集降低了损失、提升了预测性能。95%置信区间不跨越零视为差异具有统计学意义。在跨机构外部验证中,log-loss差异的稳定性比单点AUC更能反映模型迁移后的实际校准表现,这也是研究选择该指标作为主要评价依据的原因。
测量时机的独立效应
研究通过匹配观察数量的实验,剥离了“测得多”与“测得巧”的混淆:
- 在观察数量匹配时,将测量分散在整个时间窗口内,相比随机保留,R3的log-loss改善为0.03280,而R2仅为0.00703。
- 移除最后12小时的测量,相比数量匹配的随机移除,R3的log-loss增加0.01947,R2增加0.00822。
这表明,测量时机本身携带独立预测信息,且R3模型对此更为依赖。一旦新环境的测量节奏不同,这种依赖就会转化为性能损失。
Bootstrap重拟合 是一种基于重采样的模型稳定性评估方法。本研究在源数据上进行30次bootstrap重抽样,每次重新拟合模型并在外部数据上评估R3相对R2的增量效果,统计其中支持R3(即增量有益)的次数。30次中仅10次 favoring R3,意味着观察模式特征的增量优势在源数据扰动下并不稳健,接近随机水平。Bootstrap重拟合的价值在于揭示“单次划分所得结论”是否依赖于特定样本构成,尤其适用于样本量有限或特征效应较弱的场景。相比单次外部验证的点估计,bootstrap分布能更直观地反映增量特征的可复现性,为特征取舍提供依据。
可用性下降时的反转
研究进一步发现,在测量可用性降低的条件下,本地R3的增量效果会从有益转为有害。这提示观察模式特征并非“越多越好”,其价值与数据采集条件紧密绑定。
对临床预测模型开发的启示
这项研究传递了一个明确的方法论信号:临床预测模型的评估不应只关注新患者人群的分布差异,还应系统检验供给模型输入的测量条件。具体而言:
- 优先发展对测量节奏不敏感的生理轨迹特征,以提升跨机构鲁棒性。
- 将测量频率和时机特征视为“本地增强项”,在外部验证中单独报告其增量。
- 在模型部署前,模拟目标机构的测量协议,评估特征可用性变化带来的性能波动。
结语
ICU死亡预测的可迁移性不仅取决于患者群体差异,更取决于测量条件的一致性。生理轨迹提供了更稳定的跨院信号,而观察模式特征则是一把双刃剑——在本院有效,迁移时却可能因测量时机变化而失效。模型评估框架需要把“测量条件”作为一等公民纳入考量。
相关推荐
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today
 科技前沿
Claude新模型Silicon曝光,Opus 5.5被超越?
Anthropic神秘模型Silicon与Obsidian 3在Cognition Devon CLI中曝光,据称超越Opus 5.5;OpenAI的Cactus和Kraken同现构建,Coder平台Koduck疑为Qwen家族。本文梳理周末AI圈关键动向,并解读一项关于视觉输入欺骗机器人的安全研究。
 科技前沿
Claude模型与Effort终极指南:如何省Token
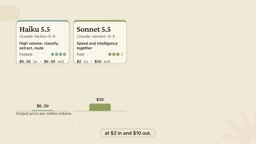
基于8种Claude模型与Effort组合、4个真实编码任务的实测,拆解Haiku、Sonnet、Opus、Fable的定位与价格,解析Effort档位对Token消耗的影响,并给出省Token的实战配置建议。