Inferno:Rust生态的自动微分引擎,瞄准概率编程与深度高斯过程
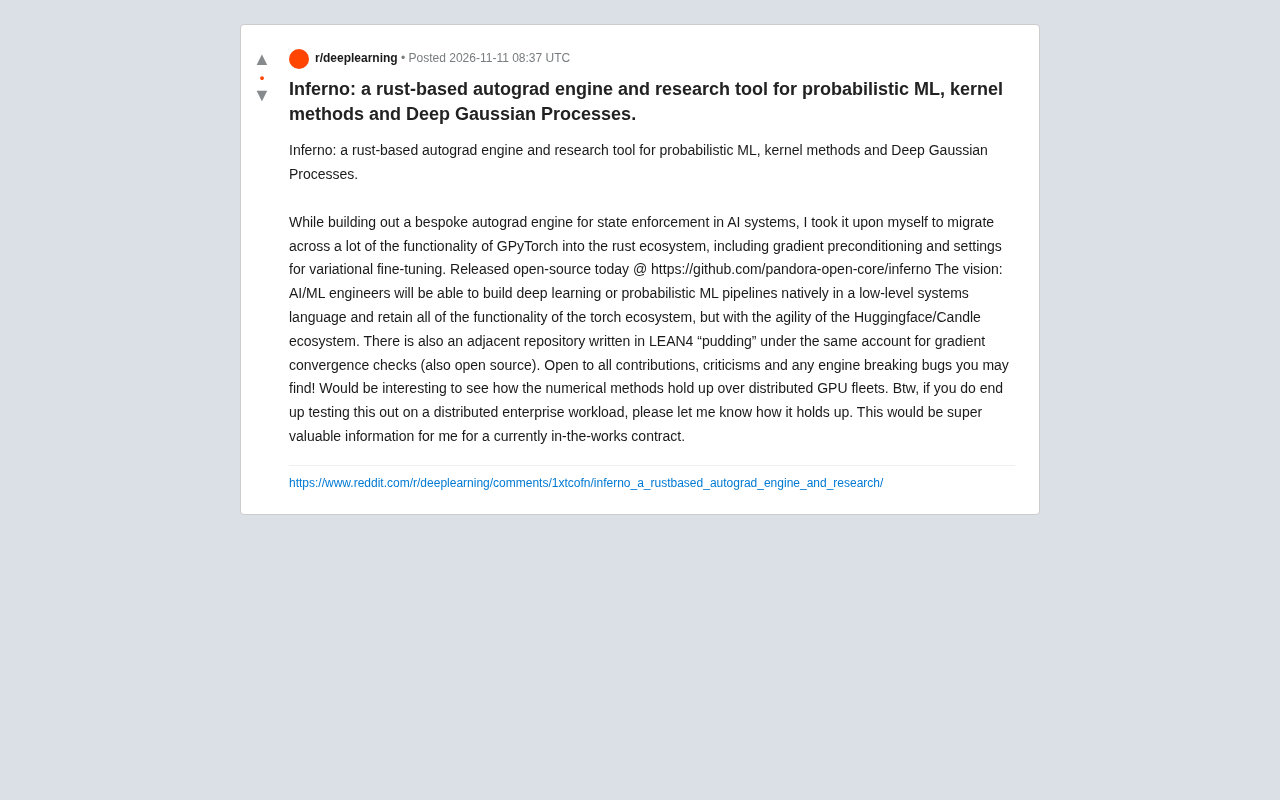
Rust自动微分引擎Inferno试图将GPyTorch的概率建模能力迁移到系统语言生态。
Reddit社区出现的开源项目Inferno是一个用Rust编写的自动微分引擎,定位为概率机器学习、核方法和深度高斯过程的研究工具。作者将GPyTorch的大量功能迁移到Rust生态,包括梯度预条件和变分微调的相关配置,目标是让工程师用系统语言原生构建ML流水线,同时保留torch生态的功能和Huggingface/Candle式的敏捷性。配套的LEAN4仓库pudding用于梯度收敛的形式化检查,体现对数值正确性的追求。但项目在分布式GPU集群上的数值表现尚未验证,作者公开征集企业级测试反馈,表明其仍处于研究原型阶段。Inferno反映了Rust在ML训练侧和概率建模领域逐步渗透的生态趋势,其成败取决于社区能否补上数值验证和分布式支持两块短板。
从GPyTorch到Rust:一个研究者的迁移实验
Reddit社区最近出现了一个开源项目 Inferno——一个用Rust编写的自动微分引擎,定位是面向概率机器学习、核方法和深度高斯过程的研究工具。作者表示,这是他在为AI系统构建定制化自动微分引擎时的副产物:把GPyTorch的大量功能迁移到Rust生态,包括梯度预条件(gradient preconditioning)和变分微调(variational fine-tuning)的相关配置。
项目已开源在GitHub的pandora-open-core组织下(https://github.com/pandora-open-core/inferno)。作者对它的愿景并不只是“又一个autograd库”:他希望AI/ML工程师能用底层系统语言原生构建深度学习或概率ML流水线,保留torch生态的全部功能,同时获得Huggingface/Candle生态那样的敏捷性。
为什么是Rust?系统语言的性能与安全诱惑
近几年,Rust在机器学习基础设施层的存在感明显上升。Candle等项目证明了用Rust写推理框架是可行的,而Inferno则把触角伸向了训练侧,而且是更偏研究的概率建模方向。
作者的核心判断是:深度学习框架的能力和系统语言的性能不该二选一。用Rust写ML流水线,意味着内存管理更可控、部署开销更小、与生产系统的集成更直接;而autograd引擎是这一切的地基。Inferno试图在底层语言上复现PyTorch生态的自动微分体验,同时保留概率编程所需的特有构件——这正是GPyTorch在Python侧解决的问题。
据作者在帖子中的说法,迁移范围覆盖了GPyTorch的“大量功能”,但具体支持哪些算子、哪些近似推断方法,原文没有逐一列出,需要用户自行查阅仓库。
自动微分(autograd) 是现代深度学习框架的核心机制,它通过记录前向计算过程中的运算图,在反向传播时自动计算梯度。主流的实现方式分为两类:静态图(如早期TensorFlow)和动态图(如PyTorch)。动态图方式在运行时构建计算图,调试友好、灵活度高,但会带来一定的调度开销。Rust生态中的自动微分引擎通常需要在所有权模型和借用检查的约束下设计计算图节点,这既带来了内存安全的强保证,也对API设计提出了更高要求。Inferno选择在这一层重做,意味着它必须自行处理张量存储、算子注册、反向模式求导等基础组件,而不是像Python生态那样可以直接复用NumPy或PyTorch的底层。
概率ML与深度高斯过程:Inferno的功能定位
Inferno明确聚焦三个方向:概率机器学习、核方法、深度高斯过程(Deep Gaussian Processes)。这三者在传统深度学习框架里往往需要大量自定义代码,GPyTorch之所以在学术圈流行,就是因为它把这些概率构件做得开箱即用。
Inferno把这类能力搬到Rust,理论上可以让研究者在不离开系统语言的前提下做贝叶斯建模和变分推断。梯度预条件和变分微调设置被提及为迁移的重点功能,这两项对于深度高斯过程的训练稳定性尤为关键。不过帖子没有给出数值基准或收敛性对比,实际效果还需要社区验证。
深度高斯过程(Deep Gaussian Processes, DGPs) 是将多个高斯过程层叠而成的概率模型,每一层的输出作为下一层的输入,从而获得比单层GP更强的表达能力和不确定性建模能力。然而DGPs的训练比标准GP困难得多:精确推断不可行,通常需要借助变分推断(variational inference)进行近似,而变分下界的优化对梯度的方差和尺度非常敏感。梯度预条件(gradient preconditioning) 指的是在优化过程中对梯度进行变换(如乘以一个预条件矩阵),以改善条件数、加速收敛,这在GP变分训练中常与自然梯度方法结合使用。变分微调(variational fine-tuning) 则涉及对变分分布参数(如均值、协方差)的精细调节。这两项技术正是训练深度高斯过程时保持数值稳定和收敛质量的关键,Inferno将它们作为迁移重点,说明其目标用户是需要精细控制训练过程的研究者。
配套的LEAN4仓库:梯度收敛的形式化检查
一个值得注意的细节是,作者在同一账号下还开源了另一个用LEAN4编写的仓库,名为“pudding”,用于梯度收敛检查。LEAN4是形式化数学证明的语言,把它和autograd引擎放在一起,透露出作者对数值正确性的执念。
这种做法在ML工具链里并不常见:大多数框架依赖经验性测试,而形式化方法能对梯度计算的收敛性质给出更强的保证。当然,两个仓库之间的集成程度、pudding目前覆盖了哪些检查,原文均未展开,属于单一来源的信息,读者应保持审慎。
LEAN4 是一个交互式定理证明器,同时也可作为编程语言使用。它基于依赖类型论(dependent type theory),允许用户将数学命题写成类型、将证明写成该类型的项,由内核逐项检查正确性。LEAN4在数学形式化领域已有显著成果(如Mathlib库),但用于机器学习数值算法的验证仍属罕见。用LEAN4检查梯度收敛,意味着把“梯度序列收敛到真实梯度”这类性质表述为形式化命题,并给出机器可验证的证明。其难点在于:形式化分析学中的极限、连续性等概念本身就需要大量基础定义,而数值计算中的浮点误差又难以在纯形式化框架中精确建模。因此,pudding仓库更可能覆盖的是算法层面的收敛性(如迭代格式的收敛条件),而非浮点实现层面的误差界。
分布式GPU集群上的未知数
作者在帖子末尾坦率承认了一个空白:Inferno的数值方法在分布式GPU集群上的表现还没有经过检验。他公开征集在企业级分布式工作负载上的测试反馈,并表示这些信息对他手头正在洽谈的一份合同“非常有价值”。
这条信息很重要——它说明项目目前更接近研究原型而非生产就绪的框架。对于想尝鲜的团队,建议先在单机或小规模环境验证数值稳定性,再考虑分布式场景。作者本人也欢迎所有贡献、批评以及引擎的破坏性bug报告。
生态意义与观察
Inferno的出现反映了一个更宏观的趋势:ML框架的底层正在被系统语言重新审视。从Candle到Burn,再到Inferno这类研究向项目,Rust生态正在从推理向训练、从通用深度学习向概率建模逐层渗透。
对研究者和工程师而言,Inferno的价值可能不在于立刻替代GPyTorch,而在于提供了一个用Rust做概率ML的参考实现,以及一套可组合的autograd底座。它的成败最终取决于社区能否补上数值验证和分布式支持这两块短板。如果你正好有分布式环境,不妨按作者所请跑一组测试,把结果反馈回去。
相关推荐

美国新车均价突破5.1万美元:AI与软件定义汽车如何推高成本
美国新车平均价格突破5.1万美元创历史新高。本文从软件定义汽车、中央计算架构、辅助驾驶传感器预埋与车端AI推理成本角度,分析AI与软件如何推高整车售价,以及这一趋势对消费者和厂商的影响。
Anthropic无预警移除Claude Code功能,开发者社区不满
Anthropic无预警移除Claude Code功能引发开发者不满。本文分析事件经过、开发者敏感原因及对AI编程工具生态的启示,探讨厂商如何平衡迭代与用户信任。
MAFM:流匹配生成中的物理约束新解法
MAFM提出用连续几何动力学替代离散校正,在流匹配生成中实现物理约束满足。本文解析其切向/法向运动解耦机制、理论保证与实验表现,并讨论局限与展望。