Inqueria:像训练有素研究员一样访谈用户的AI工具

Inqueria 用 AI 主持人自适应追问,将50场用户访谈压缩至一夜完成,并内置隐私脱敏与反确认偏误机制。
Inqueria 是一款以 AI 主持人为核心的用户研究工具,旨在解决传统深度访谈成本高、周期长的痛点。其核心差异化在于三点:一是自适应追问能力,能根据受访者回答动态调整问题,模拟资深研究员的临场判断;二是隐私前置架构,在转录文本进入大模型前先完成 PII 脱敏,降低合规风险;三是主题提炼时附上可追溯的原始引述,并强制展示持异议的受访者,对抗分析中的确认偏误。产品主打一夜完成 50 场访谈,将研究效率提升一个数量级。目前该产品仍处于 Product Hunt 早期阶段,核心问题在于 AI 追问质量与主题提炼可信度能否真正接近人工研究的标准,建议在关键决策场景中先小范围验证后再规模化使用。
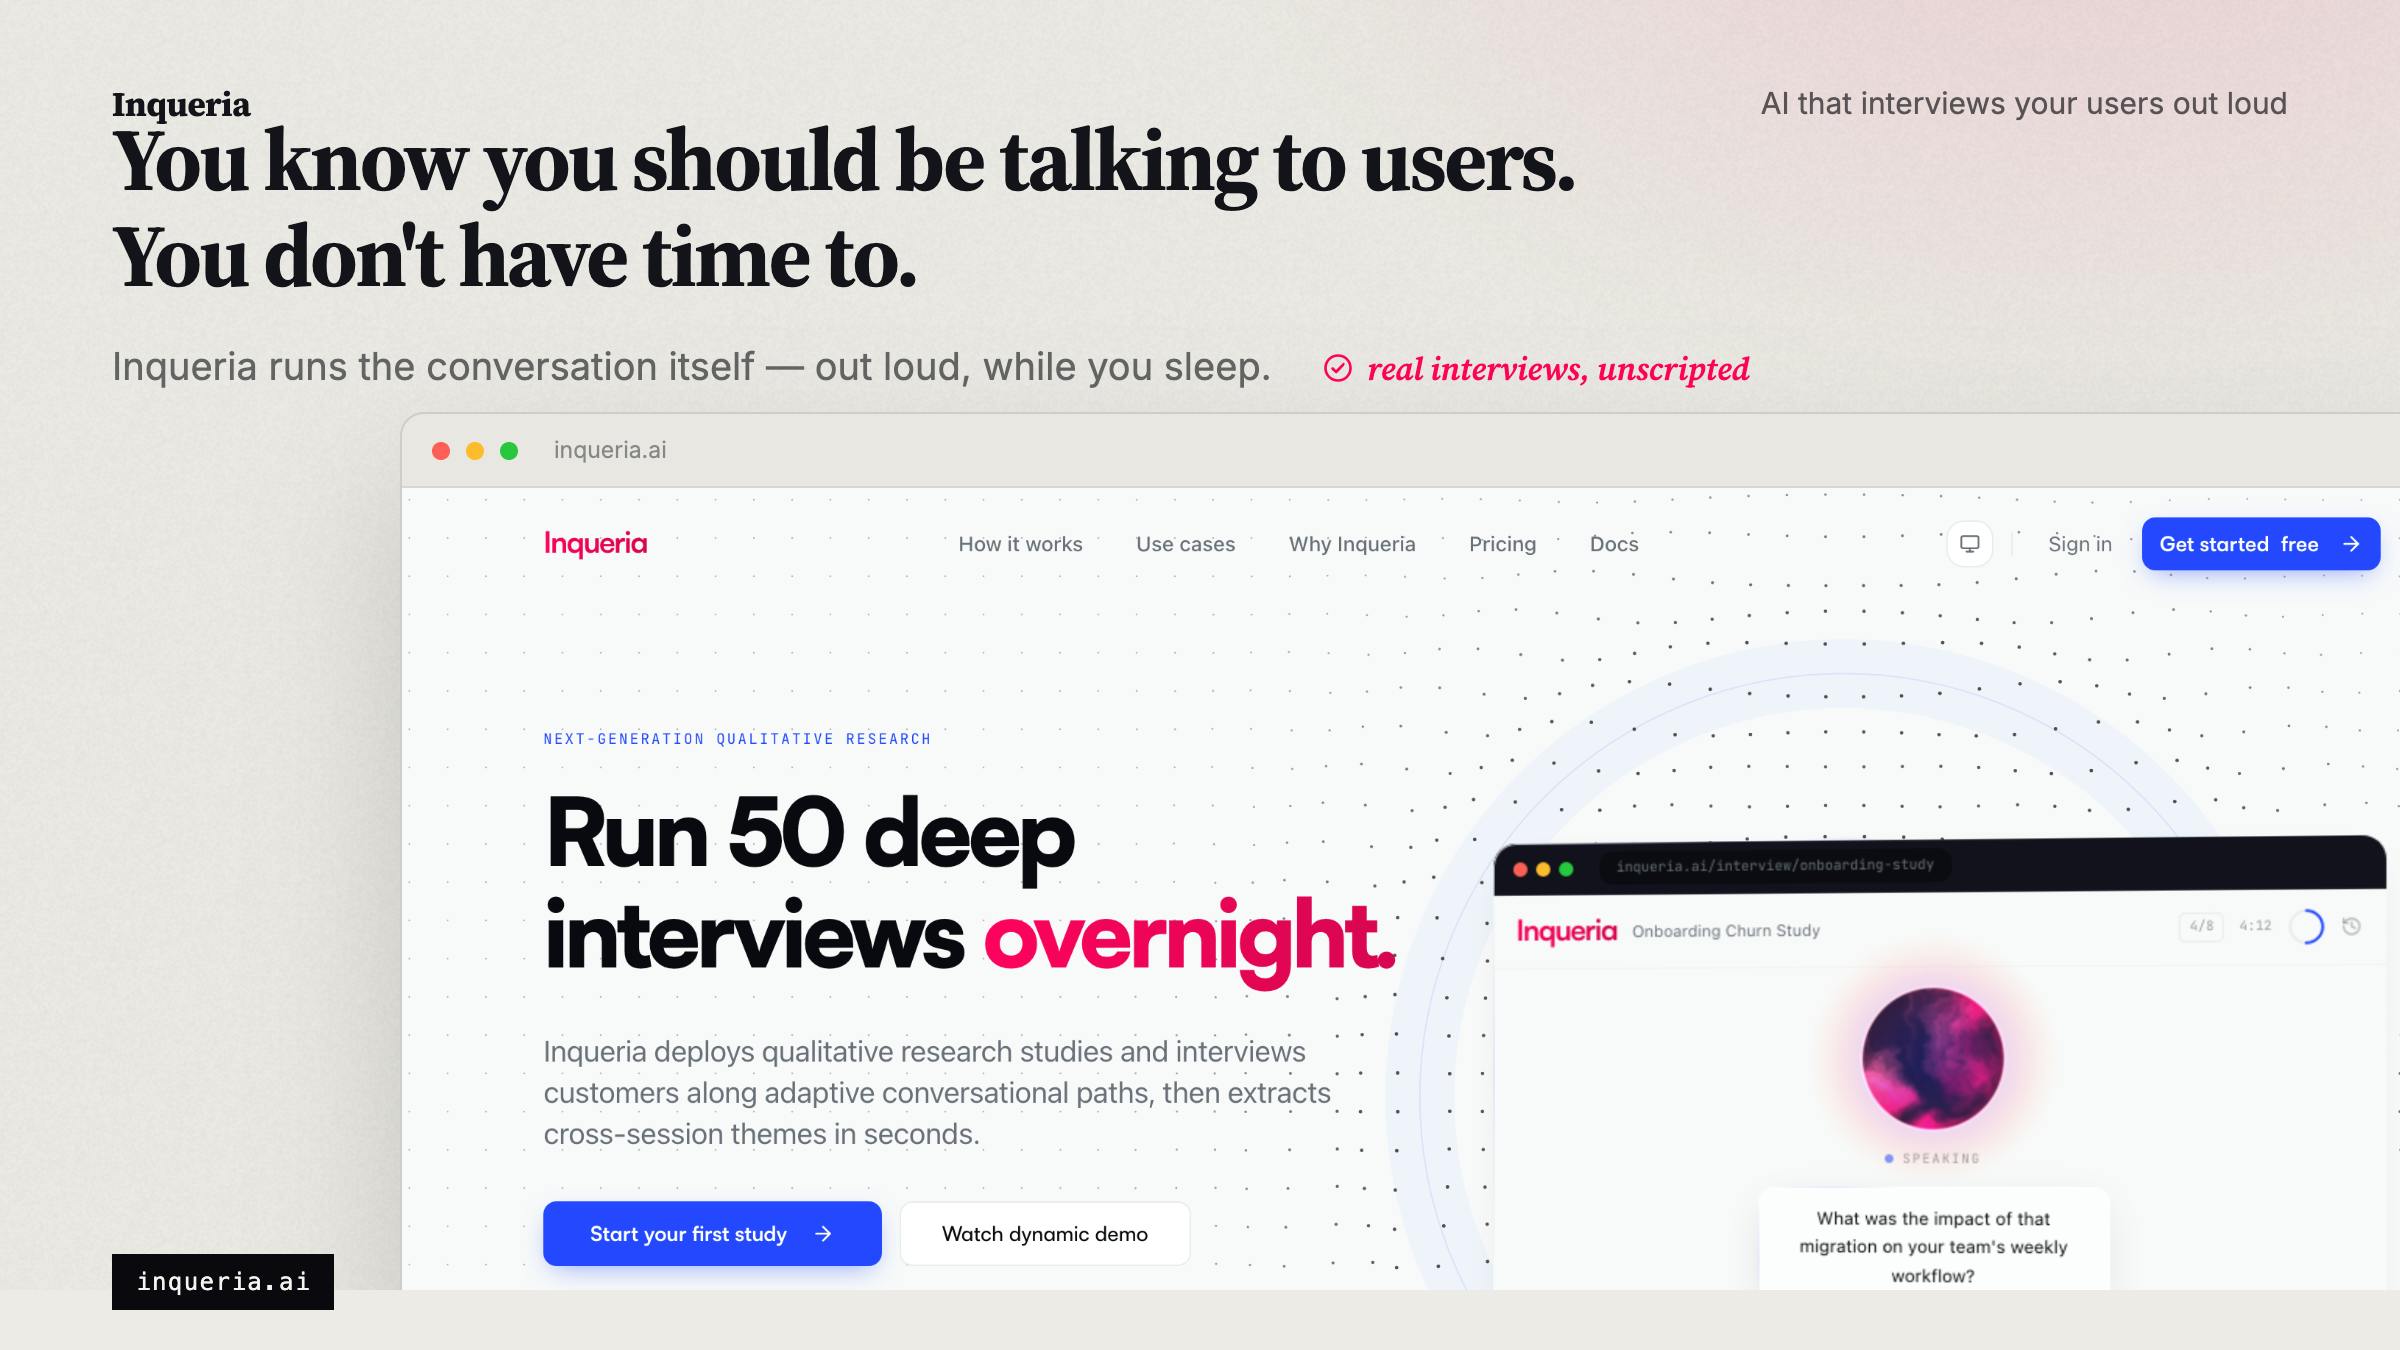
用户研究长期面临一个尴尬的现实:真正有价值的深度访谈成本高昂、周期漫长。约五个受访者的一轮定性访谈,从排期、招募到执行往往要耗掉整整一个月。Product Hunt 上新近亮相的 Inqueria 试图用 AI 主持人重构这一流程——它主打「像训练有素的研究员那样访谈用户」,并承诺一夜之间跑完 50 场访谈。
自适应访谈:不只是问卷的升级版
Inqueria 与传统问卷或简单的 AI 聊天机器人最大的区别在于「自适应」。产品描述强调,它会根据受访者的每一个回答动态调整后续问题,模拟一位真正研究员在现场追问、澄清、深挖的过程。
这一点触及了定性研究的核心:好的访谈不是照本宣科念稿子,而是在受访者透露出有趣线索时懂得往下挖。静态问卷无法做到这一点,而这正是 Inqueria 想用大语言模型的对话能力去填补的空白。对于希望规模化收集用户洞察、又不愿牺牲对话深度的团队来说,这个定位相当精准。
定性研究中的「深度访谈」(In-depth Interview)与量化问卷的核心方法论差异在于:前者追求意义建构(meaning-making),后者追求变量测量。资深访谈员在现场依赖的是「探针技术」(Probing Techniques),包括沉默探针(允许受访者填补停顿)、细化探针(「能说得更具体一点吗?」)和反射探针(重复受访者的关键词触发展开)。大语言模型在模拟这一过程时,技术上具备根据上文生成追问的能力,但其追问逻辑来自训练数据的统计模式,而非对当前受访者情绪状态和非语言信号的感知。因此,AI 主持人在处理高度情绪化、文化背景复杂或话题高度敏感的访谈时,仍存在人工研究员难以替代的空间。
隐私前置:模型看到转录前先脱敏
在 AI 处理用户对话的场景里,隐私是绕不开的敏感话题。Inqueria 的做法值得关注——它声称在任何模型接触转录文本之前,先在自有系统内完成 PII(个人身份信息)脱敏。
这意味着受访者的姓名、联系方式等敏感数据不会直接暴露给底层大模型。对于受合规约束的企业用户而言,这种「隐私前置」的架构设计是一个实际的采购决策因素,而非营销话术。它把数据治理的责任放在了进入模型管线的最前端,降低了敏感信息泄露的风险面。
PII(Personally Identifiable Information,个人身份信息)是隐私合规领域的核心概念,通常涵盖姓名、电话、邮箱、地址、身份证号等可直接或间接识别特定个人的数据。在企业采购 AI 工具时,GDPR(欧盟通用数据保护条例)、CCPA(加州消费者隐私法案)等法规要求数据处理者对用户数据的流转路径负有举证责任。Inqueria 声称的「模型接触前脱敏」架构,对应的是一种常见的数据最小化原则(Data Minimization)——只向下游系统传递完成任务所必需的最少信息。这种设计在技术上通常通过正则匹配、NER(命名实体识别)或专用脱敏库实现,在转录文本进入大模型推理管线前,将敏感字段替换为占位符。对于医疗、金融、HR 等受严格监管的行业,这一架构是能否合规落地的关键门槛,而非可选的附加功能。
主题提炼与可追溯的原始引述
访谈做完只是第一步,如何从大量对话中提炼结论才是研究价值的落点。Inqueria 会把每一次对话转化为「主题」(themes),并附上支撑该主题的确切原始引述。
更进一步,它会拿每一个主题去比对所有转录文本进行交叉验证,并主动展示那些持不同意见的受访者。这个功能设计颇具研究方法论意识——它对抗的正是定性分析中最常见的确认偏误:研究者往往只看到支持自己假设的证据。通过显式呈现反对声音,Inqueria 在一定程度上把「结论是否站得住脚」这件事交还给了使用者判断。产品标语「Interviews that Hold Up(经得起推敲的访谈)」正是对这一点的呼应。
确认偏误(Confirmation Bias)是认知心理学中记录最充分的偏见之一,指人倾向于寻找、解读和记忆与自身既有信念相符的信息,同时忽视或低估与之矛盾的证据。在定性研究中,这一偏误尤为突出——研究者在手动编码访谈内容时,往往会无意识地让支持产品假设的声音占据更大权重。传统的对抗方法包括多人独立编码(inter-rater reliability)、负面案例分析(Negative Case Analysis)以及成员检验(Member Checking)。Inqueria 通过算法强制呈现持异议受访者的设计,在一定程度上将负面案例分析自动化,但其背后的主题聚类算法本身也可能引入新的偏差,例如对少数派观点的欠采样或对语义相似度的过度依赖。使用时仍需保持对算法边界的清醒认知。
规模与效率的重新定价
Inqueria 抛出的对比很直白:一夜跑完 50 场访谈,而不是花一个月排期约五个人。这本质上是对用户研究成本结构的重新定价。
传统访谈的瓶颈从来不在于「问问题」本身,而在于招募、排期、执行、转录、编码这条冗长链路。当 AI 接管访谈主持与初步分析后,样本量可以从个位数扩展到数十甚至上百,这在统计意义上让定性洞察更接近可泛化的结论。当然,AI 主持人能否真正复现资深研究员的临场判断力,仍是这类产品需要用实际效果证明的核心问题。
早期产品的现实定位
从 Product Hunt 的数据看,Inqueria 目前处于早期阶段——12 票、3 条评论、当日排名第 14,由 Samrendra Singh 打造,归类于用户体验与人工智能。这些数字说明它还未形成规模化的市场声量,产品成熟度和真实使用反馈尚待验证。
对于用户研究、产品经理和 UX 团队而言,Inqueria 代表的方向——AI 主持访谈 + 隐私脱敏 + 可追溯的主题分析——确实切中了行业痛点。它是否能真正替代或有效补充人工访谈,取决于自适应追问的质量与主题提炼的可信度。这类工具值得关注,但在关键决策场景中,建议先小范围验证其输出与人工研究的一致性。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。