Intelligence per Watt:衡量本地AI的智能能效
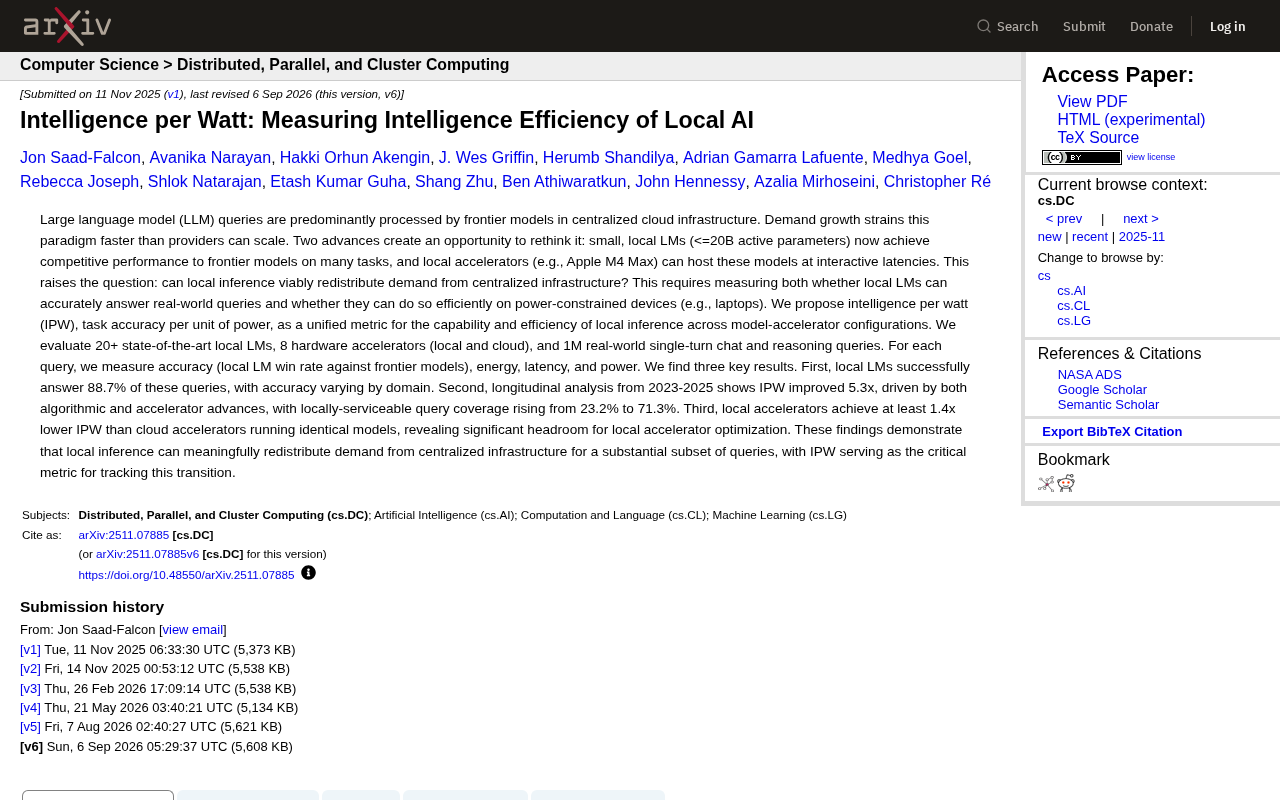
「每瓦智能」提出以单位功耗衡量本地AI能效,指向硬件与模型协同优化的新方向。
随着大模型向手机、笔记本等边缘设备下沉,传统的参数量和推理速度指标已无法反映设备在电池与散热约束下的真实表现。"Intelligence per Watt"(每瓦智能)这一概念应运而生,以单位功耗所产生的智能水平为尺度,为本地AI提供更贴近实用场景的评价维度。文章指出,该指标并非单由模型决定,而是NPU硬件、量化压缩、推理引擎与模型架构协同作用的结果;将"智能"量化本身也存在方法论争议,不同基准和测试场景会导致结果差异。尽管相关讨论仍处于早期阶段,每瓦智能已清晰指出本地AI的下一个优化方向:在能耗约束下追求更聪明,而非一味追求更强。
从算力到能效:本地AI的新评价维度
随着大模型逐渐从云端向本地设备下沉,一个长期被忽视的问题开始浮出水面:我们该如何衡量本地AI的效率?传统的评价标准往往聚焦于模型参数量、推理速度或基准测试得分,但这些指标并不能完整反映一台设备在能耗约束下的真实智能表现。"Intelligence per Watt"(每瓦智能)正是针对这一空白提出的概念——用单位功耗所能产生的智能水平,来衡量本地AI的能效比。
这个概念之所以值得关注,是因为本地推理与云端推理面临的约束截然不同。云端可以依赖庞大的电力和散热基础设施,而运行在手机、笔记本或边缘设备上的模型,则被电池容量、发热和续航牢牢限制。在这种场景下,"跑得多快"远不如"每一焦耳能换来多少智能"来得重要。
为什么每瓦智能对本地AI至关重要
本地AI的核心吸引力在于隐私、低延迟和离线可用性。用户希望在不联网的情况下也能享受智能助手、翻译、图像处理等能力。但要真正让这些能力普及到移动和边缘设备,能效就成了绕不开的门槛。
一个模型即便在基准测试中表现优异,如果它在实际设备上运行时迅速耗尽电池、导致设备发烫降频,那么它的实用价值就大打折扣。Intelligence per Watt 提供了一个更贴近现实的视角:它把"智能产出"与"能量投入"放在同一个天平上比较,从而帮助开发者和厂商判断哪些模型和硬件组合真正适合本地部署。
效率背后的硬件与软件协同
每瓦智能并非单纯由模型决定,而是硬件架构、量化策略、推理框架与模型本身共同作用的结果。专用的NPU、经过量化压缩的模型权重、以及针对特定芯片优化的推理引擎,都会显著影响最终的能效表现。这意味着提升本地AI能效是一个系统工程,需要模型设计者与硬件厂商紧密配合。
衡量标准的意义与挑战
将"智能"量化本身就是一个难题。智能水平通常通过一系列任务基准来评估,而功耗则可以直接测量。把两者结合成一个统一指标,能够为不同设备、不同模型之间的横向对比提供参考,但也存在争议——不同任务对智能的定义不同,能效结果可能因测试场景而异。
尽管如此,引入能效维度对整个行业是有益的。它促使人们跳出"参数越大越好"的思维定式,转而追求在有限资源下的最优表现。对于追求可持续计算和绿色AI的趋势而言,每瓦智能也提供了一个与能耗直接挂钩的衡量框架。
对未来本地AI发展的启示
随着小型化、高效化模型的不断涌现,能效将成为本地AI竞争的关键战场。厂商在宣传设备的AI能力时,未来或许会像标注电池续航和处理器性能那样,标注每瓦智能这一指标。对于开发者而言,理解并优化这一维度,将有助于打造在真实设备上既智能又省电的应用。
需要说明的是,该话题目前仍处于讨论和探索阶段,来自Hacker News的原始信息量有限,更多细节和实测数据仍有待进一步公开。但"Intelligence per Watt"作为一个思考框架,已经清晰地指出了本地AI下一阶段的优化方向:不再只是追求更强,而是追求在能耗约束下的更聪明。
相关推荐
抛弃向量数据库:用BM25为LangChain智能体构建记忆层
一位开源开发者构建了 CogniCore——用 BM25 检索替代嵌入向量、无需向量数据库的 LangChain 智能体记忆层,并在 LongMemEval 基准上小上下文场景反超嵌入方案,还实现了跨平台智能体记忆迁移。
一体化AI平台真的靠谱吗?告别多订阅困境的实用指南
内容创作者厌倦了同时订阅ChatGPT、Claude和Midjourney。一体化AI平台真能省钱又好用吗?本文分析聚合平台的真实权衡,并给出实用的工具组合建议。
iPhone 18 Pro发布前,谷歌Pixel 11降价抢市场
苹果iPhone 18 Pro将于9月18日发售,谷歌抢先为Pixel 11系列降价。Pixel 11 Pro亚马逊售价约1007美元,几乎抵消了今年100美元的涨幅。本文解析这场发布前价格战的市场逻辑与消费者影响。