Invofox Self Serve:99%准确率的文档提取API,用SLA兜底

Invofox 用单一 API 加 SLA 准确率兜底,重构文档数据提取服务的信任模型
Invofox Self Serve 是一款面向开发者和企业的文档数据提取服务,核心主张是通过单一 API 将发票、合同、报表等非结构化文档转换为干净的 JSON,同时将解析、提取、校验、边缘场景处理和监控全部封装在一个端点内,大幅降低集成成本。产品最大的差异化亮点在于其商业承诺:宣称 99% 以上提取准确率,并以 SLA 背书——提取出错则该文档不收费,将风险从客户转移至服务方。此外,系统支持从用户反馈中持续学习,针对企业实际使用的文档类型渐进优化。在 Product Hunt 上获 171 票、当日排名第三,但准确率定义基准、支持文档范围及 SLA 具体条款等关键细节尚需在实际评估中确认。
文档数据提取一直是企业自动化流程里最头疼的环节之一。发票、合同、报表、表单——这些非结构化或半结构化文档需要被转换成机器可读的结构化数据,而传统OCR方案往往在复杂版式、手写体、多语言混排等边缘场景下频频翻车。Invofox Self Serve 试图用一个 API 和一份服务等级协议(SLA)来解决这个老问题,并在 Product Hunt 上获得了 171 票、排名当日第三的成绩。
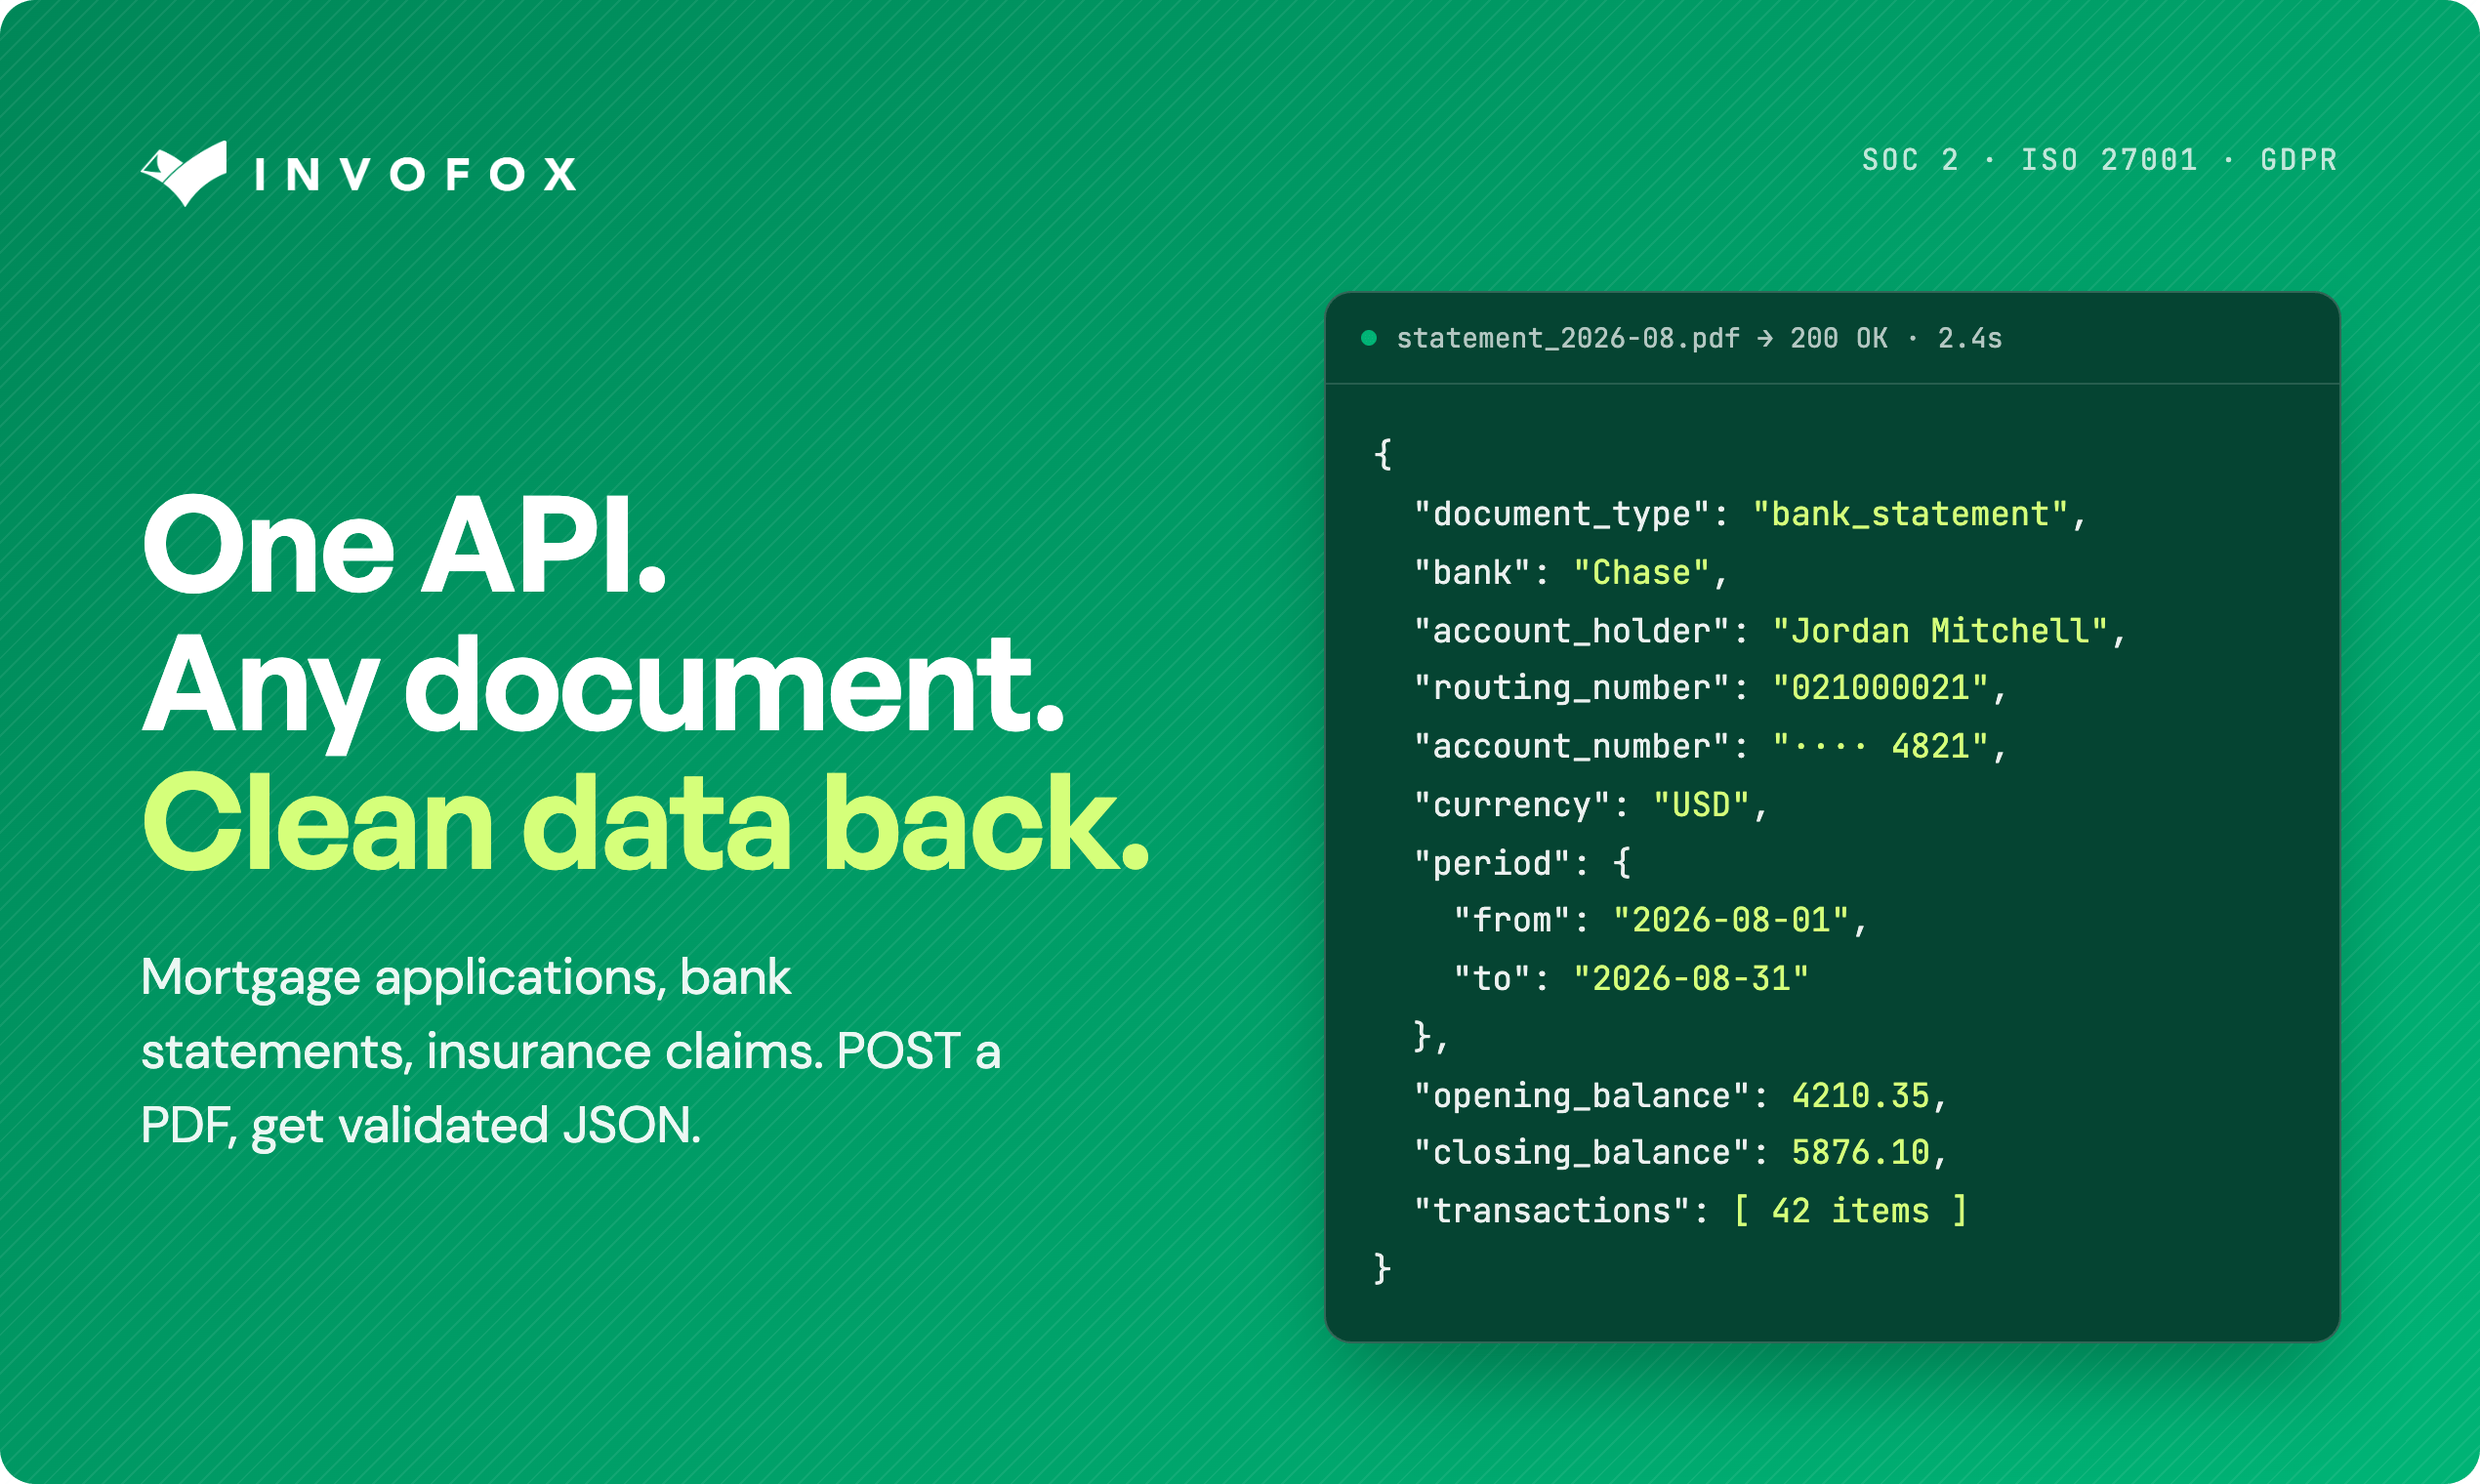
一个 API 把文档变成干净的 JSON
Invofox 的核心卖点很直接:把任意文档通过单一 API 转换成结构清晰的 JSON。开发者不需要拼接多个工具,也不需要自己处理解析、提取、校验等琐碎环节——这些都被封装在一个端点背后。
按照官方描述,Invofox 在一个接口内完成了解析(parsing)、提取(extraction)、校验(validation)、边缘场景处理(edge cases)以及监控(monitoring)五个环节。这种「黑盒式」的整合对于中小团队尤其有吸引力,因为自建一套文档处理管线涉及大量工程投入,而边缘场景的覆盖往往要靠长期积累的数据和规则打磨。
对开发者来说,这意味着集成成本的大幅下降。只要调用一次 API,输入文档、拿到结构化结果,剩下的脏活累活交给服务方处理。
传统文档处理管线通常由多个独立组件串联而成:首先是 OCR 引擎(如 Tesseract、AWS Textract)负责将图像或 PDF 转换为文本,然后是规则引擎或正则表达式做字段提取,再经过数据校验层检查格式合规性,最后才输出结构化结果。每个环节都有独立的失败点,组件之间的数据格式转换也会带来额外的工程成本。对于处理多种来源、多种版式文档的企业,这套管线的维护负担会随文档种类增加而指数级上升。Invofox 所做的「单一端点封装」,本质上是将这条管线整体外包给 SaaS 服务商,开发者只需关心输入文档和输出 JSON 之间的契约,而无需关心中间的工程细节。
用 SLA 为准确率背书:做错不收费
真正让 Invofox 区别于市面上众多文档提取服务的,是它把准确率写进了商业承诺。产品宣称提供 99% 以上的提取准确率,并用 SLA 来兜底——如果提取出错,那份文档就不收费。
这是一个颇具胆识的定价和信任机制。文档提取领域充斥着「我们的准确率很高」这类无法量化的营销话术,而 Invofox 直接把风险转移到了自己身上:错误即免单。对于把文档处理放在关键业务流程上的企业,这种承诺能显著降低试错顾虑。
当然,99% 的准确率如何定义、在何种文档类型和复杂度下成立、SLA 的具体赔付条款,这些细节在产品简介中并未充分展开,实际采用前仍需仔细评估服务条款与适用范围。
SLA(Service Level Agreement,服务等级协议)是 B2B 软件服务中用于约定服务质量底线的合同条款,通常涵盖可用性(如 99.9% 正常运行时间)、响应时间、故障赔偿等指标。将「准确率」纳入 SLA 的承诺在文档处理领域并不常见——大多数 OCR 或文档 AI 供应商只承诺基础设施层面的可用性,而非结果质量。Invofox 将「提取错误即免单」写入商业承诺,实际上是在用营收风险换取客户信任,这与传统按调用量计费、准确率自负盈亏的模式形成鲜明对比。评估此类 SLA 时,需重点关注「错误」的认定标准(是字段级还是文档级)、争议解决机制,以及该承诺在高复杂度文档上的适用边界。
从反馈中持续学习
Invofox 的另一个设计思路是「越用越准」。它会自动从用户反馈中学习,针对企业实际处理的文档类型不断优化提取效果。
这其实点出了文档提取的一个本质规律:通用模型在特定业务文档上的表现,往往不如针对该场景专门调优的模型。每家公司处理的发票格式、合同模板、报表结构都不尽相同,一个能根据实际使用数据自我迭代的系统,理论上会随时间推移在客户的专属文档上越来越可靠。
这种反馈闭环机制,本质上是把「长尾边缘场景」的解决成本摊薄到持续运营中,而不是指望一个开箱即用的模型一次性解决所有问题。
文档提取领域的「反馈学习」通常有两种技术路径:一是主动学习(Active Learning),系统标记低置信度的提取结果并优先推送给人工审核,经确认的样本随后用于模型微调;二是基于用户纠错的隐式反馈,当用户在界面上修改某个提取字段时,该行为被记录为训练信号。无论哪种路径,其效果上限都取决于反馈数据的质量和数量。对于文档种类单一、使用频率高的企业客户,这种机制的收益往往最为显著;而对于文档格式多变、批量较小的场景,冷启动阶段的准确率波动仍是需要预期的挑战。
定位与适用人群
从 Product Hunt 的分类标签看,Invofox 被归入 API、开发者工具和人工智能三个方向,产品定位清晰:它面向需要在应用中嵌入文档处理能力的开发者和企业。
典型场景包括财务自动化(发票与收据处理)、文档密集型的后台运营、需要从 PDF 或扫描件中批量抽取字段的 SaaS 产品等。对于这类团队,与其投入数月自研,不如直接接入一个带 SLA 保障的成熟接口。
「Self Serve」这个产品名也暗示了其自助式的使用门槛——开发者可以自行注册、试用、集成,无需冗长的销售对接流程,这进一步降低了尝试的门槛。
小结
Invofox Self Serve 的亮点不在于它做了什么全新的事,而在于它用商业承诺重新定义了文档提取服务的信任模型。单一 API 简化集成、SLA 兜底降低风险、反馈学习持续优化,这三点共同构成了一个对开发者友好的方案。
不过,产品介绍更多停留在营销层面,关于准确率的测试基准、支持的文档类型范围、价格体系和 SLA 细则等关键信息还需在实际评估中进一步确认。对于正在寻找文档数据提取方案的团队,它值得作为候选纳入对比。
相关推荐
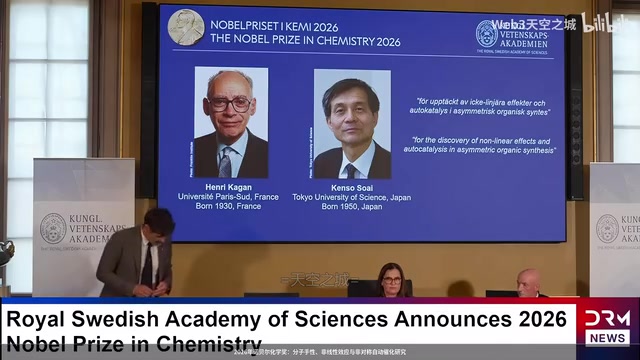
2026诺贝尔化学奖解读:手性放大背后的化学革命
2026年诺贝尔化学奖授予亨利·卡根与左右田健次,表彰其在不对称有机合成中发现非线性效应与自催化。本文解读手性分子、不对称催化及63万倍手性放大实验的科学意义。
诺贝尔化学奖得主硖合宪三:手性之谜与生命起源
诺贝尔化学奖得主硖合宪三接受电话采访,谈及其发现的硖合反应如何满足Frank判据、揭示分子手性起源,为地球生命起源这一世纪难题提供关键实验证据。
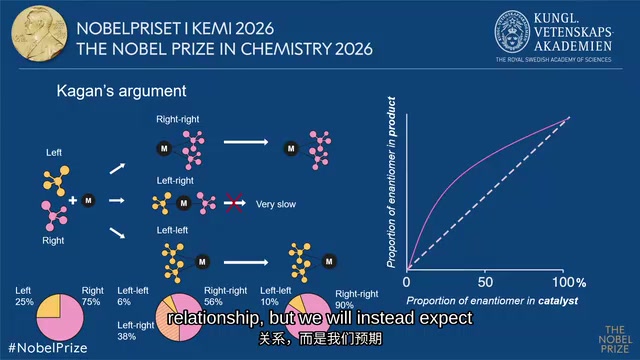
2026诺贝尔化学奖:破解分子手性之谜
2026年诺贝尔化学奖授予亨利·卡根与硕井健三,表彰其在不对称有机合成中发现非线性效应与自催化反应。本文解读手性、放大效应及其对制药与生命起源研究的意义。