ISAAC语料库:5.27亿Reddit帖分析社会群体话语的开源利器

ISAAC是覆盖17年、逾5亿条Reddit帖子的开源社会态度语料库,为跨群体话语研究提供统一可复现的公共基础设施。
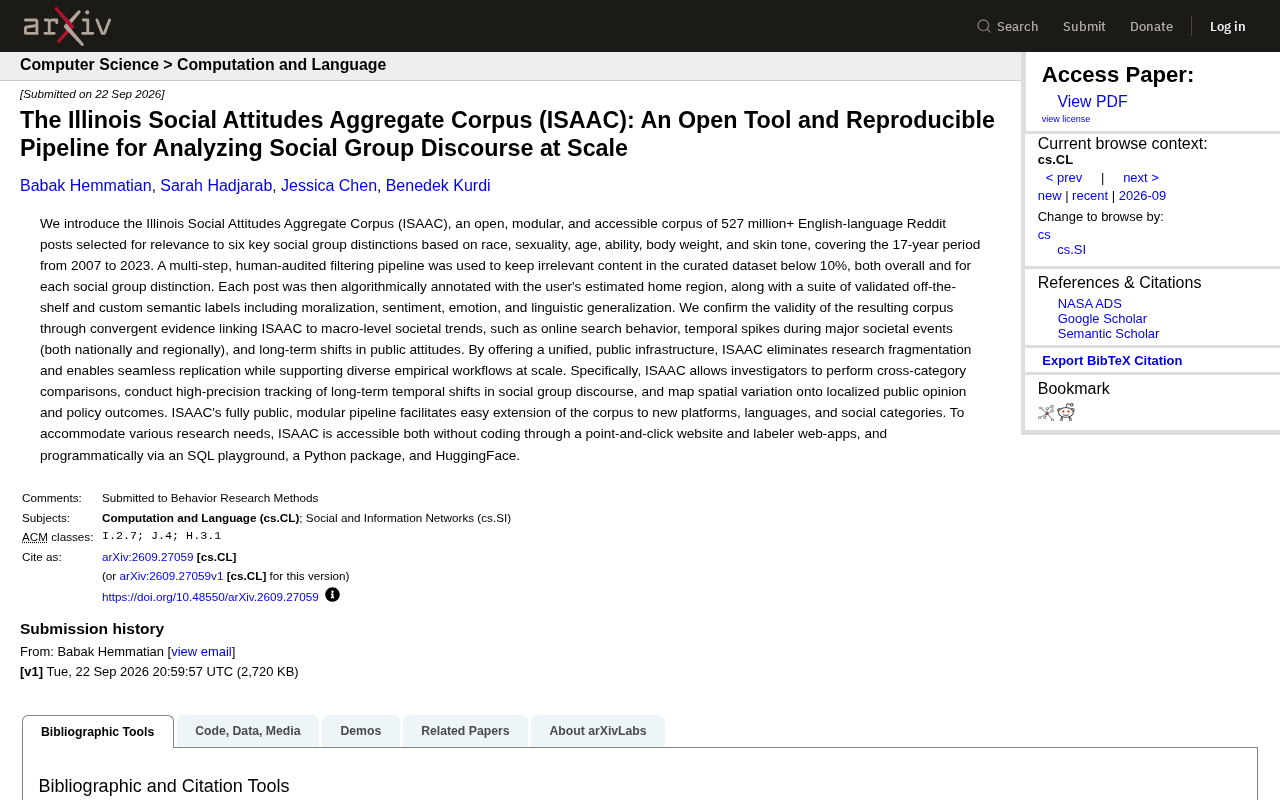
伊利诺伊大学推出的ISAAC语料库收录超5.27亿条Reddit帖子(2007-2023年),围绕种族、性取向、年龄、能力、体重、肤色六大社会群体维度构建,旨在解决社会话语研究长期面临的数据碎片化与复现性难题。语料经过多步人工审核过滤,将噪声控制在10%以下,并标注地区、道德化程度、情感、情绪和语言泛化等多维语义信息。研究团队通过与搜索行为、社会事件峰值及长期态度变迁的趋同证据验证语料有效性,支持跨类别比较、长期时间追踪和空间变异映射三类核心研究能力。ISAAC提供从无代码网站到Python/SQL/HuggingFace的多层访问方式,全流程公开可扩展,是NLP技术与社会科学方法深度结合的典型范例。
一个填补社会话语研究空白的开源基础设施
研究社会群体在网络上如何被讨论,长期以来受困于数据碎片化——各团队各自抓取、清洗、标注数据,导致研究结果难以复现、彼此难以对比。伊利诺伊大学团队推出的 ISAAC(Illinois Social Attitudes Aggregate Corpus,伊利诺伊社会态度聚合语料库) 正是为解决这一痛点而生。
据 arXiv 最新发布的论文介绍,ISAAC 是一个开放、模块化且易于访问的英语语料库,收录了 超过 5.27 亿条 Reddit 帖子,时间跨度覆盖 2007 至 2023 年整整 17 年。这套语料围绕六大社会群体维度精心筛选:种族、性取向、年龄、能力(残障)、体重和肤色,几乎触及当代社会态度研究中最受关注的议题。
严格的数据清洗与多维标注
海量数据的价值取决于质量。ISAAC 采用了多步骤、人工审核的过滤流程,将无关内容在整体及每一个社会群体子集中都控制在 10% 以下。这一指标在动辄夹杂大量噪声的社交媒体语料中相当难得,也是其可用性的关键保障。
更值得关注的是它的标注体系。每条帖子都被算法标注了用户的估计所在地区,并附带一整套经过验证的语义标签,包括:
- 道德化程度(moralization):衡量话语中的道德判断色彩
- 情感倾向(sentiment):正负面态度
- 情绪(emotion):更细粒度的情绪分类
- 语言泛化(linguistic generalization):识别对群体的概括性表述
这些标签既包含现成的开箱即用工具,也有团队自研的定制模型,为跨维度的深度分析打下基础。
语言泛化(linguistic generalization) 是这套标注体系中相对专业的概念,值得单独说明。它指的是话语中将某一群体整体化、类型化的表达方式,例如"所有X群体都……"或以偏概全的刻板描述。这类表述在偏见与歧视研究中具有特殊意义——相比孤立的贬义词,泛化性陈述往往更隐蔽,却对群体态度的形成影响更深远。在NLP领域,识别语言泛化通常需要超越词汇层面,依赖句法模式与语义推理,是较难自动化的标注任务之一。ISAAC团队为此开发了定制模型,使得大规模自动识别成为可能。
道德化程度(moralization) 同样值得关注。它衡量的是话语中将某议题或群体与道德判断(对与错、善与恶)挂钩的倾向。道德化话语往往比单纯的情感表达更具极化效果,在跨文化和跨议题的社会态度比较中是重要的分析维度。
用宏观趋势验证语料有效性
一套语料是否真正反映现实,需要外部证据佐证。研究团队通过**趋同证据(convergent evidence)**来确认 ISAAC 的效度——将语料中的信号与真实社会趋势对照:
- 与网络搜索行为的关联
- 在重大社会事件期间(无论全国性还是区域性)出现的时间峰值
- 公众态度的长期变迁
当语料内部的话语波动能够与这些独立的宏观指标对齐,就说明 ISAAC 捕捉到的并非随机噪声,而是真实的社会态度动态。这种验证思路让语料从"数据堆"升级为可信赖的研究工具。
趋同效度(convergent validity) 是社会科学测量中的经典验证方法:如果一个测量工具能与其他独立来源的测量结果高度吻合,则说明它确实在测量同一个真实构念,而非测量误差或工具本身的偏差。将Reddit话语数据与Google搜索趋势、事件时间线或民调数据对齐,正是这一逻辑的体现。这种验证对基于社交媒体的语料尤为重要——Reddit用户并不代表全体人口,存在年龄、教育程度、地域等方面的系统性偏差,因此语料能否反映更广泛的社会态度,必须通过外部证据而非仅凭规模来证明。ISAAC的这一步骤将其定位从"数据资源"提升为"有效度的社会测量工具"。
三类研究能力:时间、空间与跨类别
ISAAC 提供的统一公共基础设施,让研究者可以开展过去难以规模化实现的工作:
跨类别比较——将种族、年龄、体重等不同社会群体维度放在同一框架下对照,观察话语模式的异同。
长期时间追踪——凭借 17 年连续数据,高精度地刻画社会群体话语的时间演变,捕捉态度的缓慢漂移或突发转折。
空间变异映射——结合用户地区标注,将话语的地理差异与本地公众舆论、政策结果对应起来,探索线上讨论与现实政治的联系。
这三种能力对应了社会科学研究中的时间、空间和类别三个核心分析维度,覆盖面相当完整。
面向不同用户的多重访问方式
ISAAC 在可及性上的设计颇为周到,兼顾了不同技术背景的研究者:
- 无需编程:通过点选式网站和标注器 Web 应用直接使用
- 编程访问:提供 SQL playground、Python 工具包,以及 HuggingFace 上的数据集
这意味着无论是不熟悉代码的社会学、传播学学者,还是习惯脚本化工作流的计算社会科学研究者,都能找到合适的入口。同时,其完全公开、模块化的流程支持轻松扩展到新平台、新语言和新的社会类别,为后续研究者提供了可复用的管线。
意义与展望
ISAAC 的核心价值在于消除研究碎片化、实现无缝复现。在社会计算与自然语言处理交叉领域,可复现性一直是长期短板;ISAAC 通过开放全部数据与流程,让不同团队能在同一基础上对话、验证与延伸。
对于关注 AI 如何应用于社会科学的读者来说,ISAAC 是一个典型范例:它并非追求模型性能的突破,而是把 NLP 标注技术、大规模数据工程与严谨的社会科学验证方法结合起来,构建可持续复用的公共基础设施。这类工作虽不"炫技",却往往对整个研究社区产生更深远的推动作用。
在计算社会科学领域,可复现性危机(replication crisis) 并非只存在于心理学等传统实验学科,同样困扰着依赖自采数据的NLP与社会计算研究。各团队使用不同时间段、不同过滤标准、不同标注模型抓取的Reddit数据,得出的结论往往无法互相验证,形成"数据孤岛"。ISAAC通过固定数据来源与流程、公开全部管线,实际上为该领域提供了一个共享基准(shared benchmark)——类似ImageNet在计算机视觉领域曾扮演的角色。这种基础设施层面的贡献,使得不同研究团队的发现可以在同一坐标系下叠加、对比和累积,是推动领域从个案研究走向系统性知识积累的关键一步。
相关推荐
美国最东与最西点之谜:地理坐标与航行方向的两种答案
美国的最东点和最西点究竟在哪里?按经度算,阿拉斯加同时是最北、最西、最东;按航行方向算,答案却是关岛和圣克罗伊岛的乌德尔角。本文解析两种地理定义背后的逻辑与巧合。

12个让人直呼"离谱"的个人AI助手实用场景
科技博主Matthew Berman演示12个个人AI助手实用场景:用Grokbot自动谈判订阅省钱、控制特斯拉、管理家庭日程、会议纪要、邮件分流和账单优化,附提示词设计思路与风险边界分析。

从Demo到上线:AI Agent工程化落地的关键差距
搭建AI Agent很容易,真正部署上线才是难点。本文从一位开发者的八晚实战课程切入,剖析Demo与生产级系统之间的工程化鸿沟,包括稳定性、成本控制与部署落地的关键差距。