Jetson AGX Orin上用cuDLA跑Python原生DLA推理
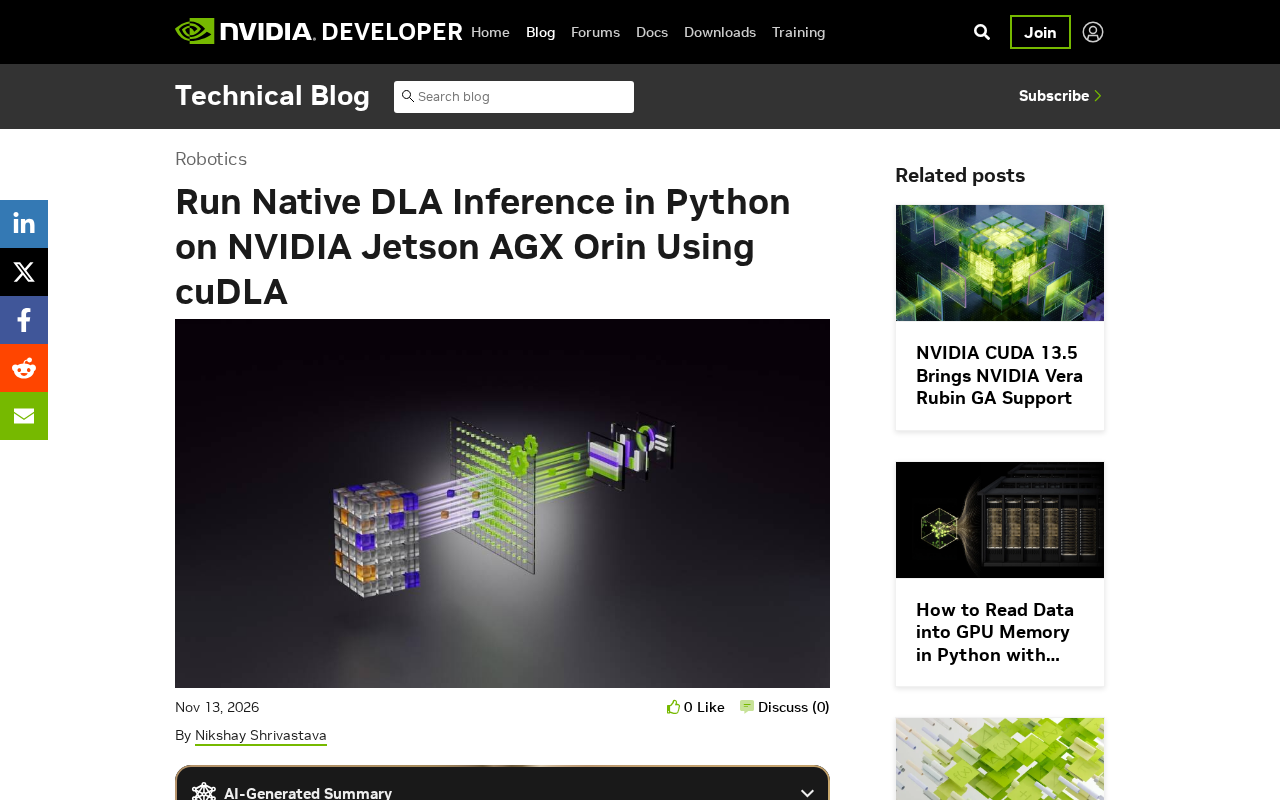
cuDLA让Python开发者在Jetson AGX Orin上原生调度DLA,实现多模型并行与低功耗边缘推理。
文章围绕NVIDIA开发者博客的技术内容,介绍在Jetson AGX Orin上通过cuDLA以Python直接调用DLA进行原生推理的路径。首先说明DLA作为独立于GPU的固定功能加速器,其价值在于释放GPU资源与控制整机功耗,适合多网络并行的边缘场景。接着对比cuDLA与TensorRT的DLA后端:后者由框架决定层分配,前者提供更底层的编程模型和更细的控制粒度。Python接口降低了DLA使用门槛,使推理可嵌入现有Python服务。文章也指出DLA算子与数据类型支持受限,部署时需切分DLA与GPU部分,并留意内存布局转换开销,DLA的定位是GPU协处理器而非吞吐主力。
边缘AI部署常遇到一个现实矛盾:设备上要同时跑多个神经网络,但算力和功耗预算都很有限。NVIDIA Deep Learning Accelerator(DLA)正是为此设计的专用推理加速器。NVIDIA官方开发者博客发布的技术文章《Run Native DLA Inference in Python on NVIDIA Jetson AGX Orin Using cuDLA》,给出了在Jetson AGX Orin上直接以Python调用cuDLA完成原生DLA推理的路径。
为什么要在Jetson上专门用DLA
Jetson AGX Orin的算力并不只来自GPU。片上集成的DLA单元是独立于GPU的固定功能加速器,专门处理卷积等深度学习算子。把部分网络卸载到DLA,能同时带来两个收益:GPU资源被释放出来跑其他模型或预处理流水线,整机功耗也更可控。
对于需要并行运行多个网络的边缘场景(多路摄像头检测、机器人感知栈、工业视觉),这种分工往往比把所有模型堆在GPU上更实际。原文的切入点也正在这里:边缘AI应用需要在有限的算力和功耗预算内运行多个神经网络。
DLA的硬件定位:DLA(Deep Learning Accelerator)是NVIDIA在Tegra/Orin系列SoC中集成的固定功能推理加速器,其微架构围绕卷积、反卷积、池化、激活等张量算子做了专用数据通路与片上缓存设计,不依赖GPU的SM阵列即可独立执行推理。以Jetson AGX Orin为例,其DLA提供多个可独立配置的加速器实例(原文所称的DLA单元),每个实例可承载一条推理流水线,因此多网络并行时可以把不同模型分配到不同DLA实例或与GPU形成异构分工。由于是固定功能硬件,DLA在单位功耗下的卷积吞吐通常优于通用GPU,但灵活性低,算子覆盖和数据类型(如INT8、FP16)受硬件版本约束,这也是后文强调需要做DLA/GPU切分的根本原因。
cuDLA是什么,和TensorRT的DLA后端有何不同
常见的DLA使用方式是让TensorRT在构建引擎时把部分层分配给DLA执行,开发者并不直接接触DLA的底层接口。cuDLA则提供了更底层的编程模型,允许开发者以接近原生的方式组织DLA任务,再通过Python绑定调用。
这条路径的价值在于控制粒度。走TensorRT时,层的分配、格式转换由框架决定;走cuDLA,开发者对提交给DLA的计算图有更直接的话语权,也更容易把DLA推理嵌入到已有的Python服务或脚本中,而不必为每个模型单独构建引擎。原文强调的"Native DLA Inference",指向的正是这种绕过高层封装的执行方式。
TensorRT的DLA后端机制:TensorRT在构建引擎时可指定DLA作为执行后端,由构建器根据层的算子类型、精度与张量形状判断能否在DLA上执行,不能执行或收益不高的层会回退到GPU,这一过程对开发者是半透明的。其代价是控制粒度粗:层分配策略由TensorRT内部启发式决定,格式转换与内存规划也由引擎封装,开发者难以针对特定拓扑做精细调优。相比之下,cuDLA直接暴露DLA的任务提交接口(如加载可执行图、设置输入输出张量、触发推理与同步),开发者自行决定计算图如何切分与提交,绕过了TensorRT引擎构建这一层抽象,因而更适合需要与已有流水线深度集成或做细粒度异构调度的场景。
Python调用的工程意义
在Jetson生态里,Python是原型验证和快速迭代的主力语言。此前直接操作DLA通常意味着C/C++层面的工作,这与多数算法团队的日常工具链存在落差。cuDLA的Python接口把这个门槛降了下来:推理脚本可以和数据处理、结果后处理写在同一个Python进程里,调试链路更短。
从工程实践看,这类原生接口更适合两类团队。一类是需要在DLA与GPU之间做细粒度负载划分的性能敏感型项目;另一类是已经在Python服务中部署模型、希望进一步压缩功耗的产线应用。
落地时的考量
DLA是固定功能加速器,支持的算子集合和数据类型相对受限,并非所有网络都能整体卸载。实际部署时通常需要把网络切分成DLA可执行部分与GPU兜底部分,这个切分策略直接影响端到端延迟。此外,DLA推理的输入输出往往涉及内存布局与格式转换,这部分开销在Python层要额外留意。
原文并未给出具体的性能对比数据,但从架构定位看,DLA的收益主要体现在能效和GPU资源释放上,而非绝对吞吐的超越。把它当作GPU的协处理器来规划任务分配,比期待它单独承担主推理更符合设计意图。
内存布局与格式转换开销:DLA对输入输出张量的内存排布有特定要求,常见的是NHWC或特定的分块/对齐格式,而Python侧的NumPy数组、PyTorch张量通常采用NCHW或连续行主序布局。两者不一致时需要在提交前做重排(如transpose、padding对齐),这部分在CPU或GPU上完成,若放在推理热路径中会显著侵蚀DLA带来的能效收益。实践中应尽量让前后处理直接产出DLA期望的布局,或将格式转换与其它算子融合,并对输入输出缓冲区做复用以避免频繁分配。此外,DLA推理通常是异步提交,需要正确同步才能读取结果,Python层的封装应明确这一时序语义,否则容易出现读到未完成结果的问题。
小结
cuDLA在Jetson AGX Orin上打开了一条更底层的DLA使用通道,让Python开发者能够原生地调度这块专用加速器。对于多模型并行、功耗受限的边缘部署,这是一种值得纳入架构选项的思路——前提是对网络结构和算子支持边界有清晰的预判。
相关推荐
Anthropic IPO前夜:万亿估值背后的五重风险与治理真相
拆解Anthropic IPO招股书:万亿估值下每日1.84亿美元营收、1040亿账面亏损真相、五类股份的治理结构、94页风险因素中的非常规披露,以及解禁时间表对散户的潜在影响。
FBI警告:黑客用AI代理ARTEX攻击200+组织
FBI发布预警,点名AI渗透框架ARTEX被用于攻击200多家组织,CrowdStrike追踪到VaporPanda团体。本文拆解ARTEX的代理编排架构、真实攻击链与损失数据,并整理FBI给出的五条防御建议。
FBI警告:免费AI黑客工具Artex失控,三小时攻破云系统
FBI警告免费开源AI渗透工具Artex被犯罪与国家背景黑客滥用,最快三小时攻破云系统。本文解析真实攻击案例、被忽视的侧门风险,以及企业与个人可立即采取的防御措施。