Jev实战:用单次Prefill替代逐token解码的决策模型

Jev跳过逐token解码,单次prefill直接输出choice/score/null三类有界决策,延迟可控且输出可预测。
Jev 提出一种反常规的 LLM 推理范式:跳过整个 decode 阶段,只跑一次 prefill 前向传播,直接输出 choice、score、null 三类有界决策,用于风控分级、工单路由等结构化判断场景。文章对比了编码器与解码器两条实现路径:编码器用 mask token 对选项打分,双向注意力下上下文无法缓存;解码器则 prefill 一次缓存上下文,支持单 state 挂载大量问题,但需处理重复首 token 与多问题掩码隔离。训练上采用 RLCD,借 GRPO 思路制造轨迹,以 log score、spherical score 和序数场景的 RPS 组合评分。选型取决于上下文复用、问题数量与输出类型。
Jev实战:用单次Prefill替代逐token解码的决策模型
大语言模型做结构化决策时,通常要逐token解码出JSON,延迟不可控、输出格式还得靠提示词硬掰。一个叫Jev的思路反其道而行:跳过整个decode阶段,只跑一次prefill前向传播,直接输出有界的类型化决策——选择、序数评分、布尔判断。本文基于YouTube技术频道的完整教程,拆解Jev的推理范式、编码器与解码器两条实现路径,以及RLCD训练工作流。
Jev解决的是什么问题
标准LLM推理分两段:prefill吃掉全部prompt、计算密集,准备生成第一个token;decode则逐个吐出后续token,每一步都要把已生成的序列重新喂回模型。教程用一个信用卡反欺诈案例说明痛点:判断交易是否欺诈、优先级高低、是否需要上报,这本是三个有限选项的判断,却要模型逐token生成一整段JSON。
Jev的核心主张只有两点:一次前向传播,没有decode;输出可预测。你事先声明想要什么——选项、序数分数或布尔值——模型就精确返回对应结果,而不是让你在语法和措辞里反复调试不确定性。
教程把Jev的接口分成三类,对应三种概率分布形态:
- choice(名义型):互斥选项,如东/西/南/北,彼此无顺序关系
- score(序数型):选项有顺序,如平静/沮丧/非常愤怒,可以按不满程度排列
- null(二元型):是/否问题,返回对应概率
三者的API不同,但教程选择先构建统一的softmax骨架,再在其上区分各自的细微差异。
prefill 与 decode 的算力特征截然不同:prefill 是一次性并行处理整个 prompt,矩阵乘法密集,GPU 利用率高;decode 是逐 token 串行,每步只处理一个 token,受内存带宽限制,GPU 往往跑不满。Jev 只做 prefill,等于把推理从“内存带宽受限的串行循环”拉回到“计算密集的并行前向”,这正是其延迟可控的底层原因。不过这也意味着输出长度被严格限制在预设的选项集合内,无法生成长文本。
前置知识门槛:这不是入门课
作者明确划了硬门槛:需要理解attention机制、KV cache原理、logits与softmax,并且能熟练使用PyTorch。缺任何一项,跟课都会吃力。Hugging Face基础、VS Code调试器、现代transformer的encoder/decoder结构属于加分项。
反直觉的是,不需要GPU——课程刻意做成推理密集型,实现部分只跑推理。也不需要训练经验,数学只需理解softmax。这种取舍让Jev的工程思想可以被更多开发者低成本验证。
KV cache 是自回归生成中的关键优化:解码时每生成一个新 token,都需要把之前所有 token 的 Key/Value 向量重新计算一遍,代价随序列长度平方增长。KV cache 把这些中间结果缓存起来,后续步骤直接复用,避免重复计算。Jev 的解码器路线正是利用这一点——上下文只 prefill 一次,之后每个问题只计算新增 token 的 KV,从而在单次缓存上挂载大量问题。理解 KV cache 的容量与生命周期,是判断 Jev 是否适合自身场景的前提。
基线:vanilla解码到底慢在哪
教程第一阶段先跑一遍传统解码,建立对照组。用的是Qwen 3 6B量级的小模型,足以装进大多数笔记本。prompt要求模型对一张可疑信用卡交易输出JSON,schema里恰好设计了三个字段来对应Jev的三种接口:priority(high/low,序数)、decision(fraud/fraud review/clear,选择)、escalate(布尔)。
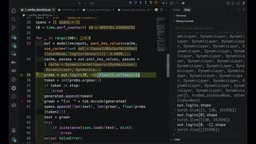
实现上,输入约130个token,模型返回130个位置的预测,每个位置都是完整词表大小的概率分布。常规做法是丢弃除最后一个位置外的所有预测,取argmax得到下一个token,更新KV cache,循环往复。教程还演示了一个最佳实践:如果同一段上下文要回答多个下游问题,可以先缓存上下文状态,之后每个问题只需把问题拼接到缓存上。
这段基线跑完,作者的评价很直白:从第一个引号到priority、再到逐token生成完整JSON,耗时本可以完全避免——只要把问题表述得足够收敛,让模型不需要进入这个恶性解码循环。
路线一:Encoder实现,用mask token对选项打分
第一个替代方案用BERT类编码器backbone,不做任何训练,先看能否直接改造。
token排列顺序有个细节:问题在前,上下文在后。作者解释,attention通常对序列开头赋予更高权重,实验下来这个顺序表现更好。每个选项前面插入一个特殊的mask token,靠它的隐状态来度量该选项的倾向。
编码器是双向注意力,这带来一个结构性限制:每换一个问题,所有位置的注意力权重都会整体变化,即使把上下文放前面也无法缓存复用。问题越多、上下文越长,重复计算越重。换来的是每个模型参数都参与了对上下文的双向理解。
实现层面,build函数把class token、问题、分隔符、mask+选项、再分隔符、上下文依次拼接。推理时取last hidden state,从问题span里取出token做mean pooling得到query向量,再取出各选项mask位置的向量,两者点积后过softmax,就是各选项概率。
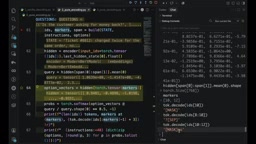
零训练的结果并不准确——一个本应是"是"的问题只给出30%左右。但教程强调,768维嵌入本身质量很高,缺的只是"输出要符合概率语义"这一层。因此给出三条递进路径:只训一个线性头把768维映射为标量;做LoRA微调;或全量重训backbone。选哪条取决于任务复杂度与可用数据量。
路线二:Decoder实现,prefill一次缓存复用
解码器路线的关键差异在于上下文可以前置并缓存。因果掩码下,上下文只需prefill一次拿到KV cache,后续每个问题直接复用,只计算新增的问题token。教程提到Jev官方支持在单个state上挂载多达5000个问题,因此推测其底层走的可能是解码器路线——但官方未公开实现,作者也提醒不要下定论。
具体做法把问题组织成补全任务:上下文+问题+冒号,模型吐出第一个token后,只在该token的概率分布里查选项对应token的概率,其余全部忽略。两个免训练变体:一是把选项改写成A/B/C/D字母让模型选;二是加一个线性指针头把概率变成可解释分布。教程还提到两个开源参考——Kev(Jev的开源替代)和Cloudflare的Clef(用pooled span覆盖完整选项再加线性头)。
重复首token的坑
如果两个选项首token相同,比如fraud和fraud review,简单实现会直接失效——模型只能给出50/50。作者的工程处理是检测到重复首token就抛错,提示用户改写选项(比如把fraud review改成review)。Clef的pooled span方案从根上规避了这个问题,因为它对整个选项做池化,即使选项完全重复也能区分。
多问题打包的掩码设计
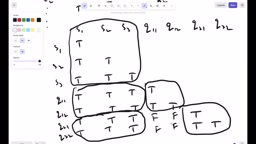
把多个问题塞进一次前向传播时,因果掩码需要改造:每个问题都能看到完整上下文,但问题之间必须互相隔离。如果问题二能看到问题一的内容,提问顺序就会影响答案,可复现性被破坏。作者特别指出,Cloudflare的Clef没有做这层隔离,在他看来这会导致换序后输出漂移。
实现上用segments标记每个token属于哪个问题,构造同问题掩码与标准因果掩码做逻辑与,再把上下文部分全部置为可见,得到最终attention mask。以73个token(38个上下文+35个问题token)为例,切片后能看到清晰的块状结构:左下角全false(问题二看不到问题一),问题块内保持因果。
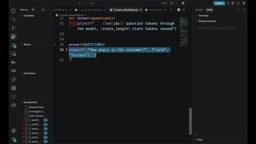
解码器路线的一个意外收获:开箱即用。教程中第一个问题"客户是否要求退款"给出95%置信度,第二个问题"哪个团队负责"给出97%归属billing,无需任何微调。上下文缓存后可以持续追加新问题、更换选项,状态始终不变。
因果掩码(causal mask) 是解码器模型的基础机制:每个位置只能看到自己和之前的 token,保证生成时不会“偷看”未来。Jev 在多问题打包时改造了这一掩码——上下文对每个问题都可见,但问题之间互相屏蔽。实现上构造一个块对角矩阵:问题 i 只能 attend 到上下文和问题 i 自身的 token,不能看到其他问题。这样即使把几十个问题塞进一次前向,每个问题的答案也与单独提问完全一致,顺序无关、可复现。
RLCD训练:用GRPO把概率校准到教师分布
训练部分教程只讲原理不跑代码,核心是RLCD(带校准决策的强化学习)。起点是教师-学生蒸馏:教师给出概率分布(如0.7/0.2/0.1),学生的原始分数softmax后保持了排序但分布偏离,目标是让学生分布逼近教师。
由于Jev把输出约束在有限token上,没有天然的多条轨迹,于是用GRPO的思路人工制造轨迹:对原始分数加入随机扰动,生成若干候选分布。评分由三部分构成——log score衡量概率质量是否落在教师高概率的位置,spherical score衡量整体方向是否一致,两者都按教师概率加权。序数型score接口额外加入RPS(rank probability score),它捕捉序数预测中"错得有多离谱":真实答案是"非常愤怒"时,预测"沮丧"应比预测"平静"得分更高,而普通log score对这两种错误给分相同。
轨迹得分减去均值再除以标准差得到advantage,正advantage的轨迹获得更低loss。最终损失为完整交叉熵加上RL损失(spherical+log,score接口再加RPS),反向传播可以只训线性头、训LoRA,或全量微调。
GRPO(Group Relative Policy Optimization) 是 DeepSeek广告 提出的强化学习算法,与 PPO 不同,它不依赖独立的 value 网络,而是对同一 prompt 采样一组轨迹,用组内平均分作为基线计算 advantage。Jev 借用这一思路:由于输出被约束在有限 token 上、没有天然的多条轨迹,作者对原始分数加随机扰动来人工制造候选分布,再按组内相对表现分配 advantage。这样无需价值函数即可完成策略优化,训练更轻量,也契合 Jev 推理密集型的设计取向。
编码器与解码器怎么选
教程最后给了对照维度:
- 上下文复用:编码器每问必重读,解码器读一次缓存;问题多而上下文有限时选解码器
- 成本随问题增长:编码器线性增长,解码器基本持平(只有问题token是新的)
- 长文档:解码器更合适
- 问题与上下文的双向交互:双向注意力让编码器略占优势
- 多token选项:编码器的mask前置设计天然适配,解码器偏弱
- 多标签同时输出:编码器可换sigmoid头,解码器受限于softmax需改架构
- 参数量效率:同等任务下编码器通常可用更小模型完成,对显存和速度敏感的场景值得权衡
工程落地上,编码器写一条序列对应一个问题,解码器则要处理掩码、位置与缓存的组合。教程的立场很清楚:先把第一性原理吃透,各家实现的差异和调优自然就看得懂。
对需要低延迟、输出可枚举的软件逻辑判断场景——风控分级、工单路由、客服情绪打分——Jev这种"只prefill不decode"的范式提供了一个值得认真评估的工程选项。
相关推荐

Cursor免费版8分钟建生产级应用,却败在同一个安全细节
Cursor免费版用8分12秒构建生产级Node+Postgres应用,22项API测试与界面检查全绿,比Copilot快6分钟,但默认密钥、无法撤销的JWT会话和登录无限流三个问题暴露了AI编程工具的安全盲区。
GoHighLevel对话AI接入MCP:智能体可调用40+外部应用
GoHighLevel 对话 AI 新增 MCP 支持,智能体可在对话中调用 40+ 外部应用完成预约、付款、表格写入等操作。了解功能限制、配置方法和上线时间。
物业管理软件为何必须拥抱AI与MCP协议
物业管理软件正转向开放生态。某系统已上线MCP服务器并筹备云端连接器,支持AI智能体接入与自定义工作流。本文分析MCP、开放API为何成为物业软件选型新标准。