继承的权重:语言模型的Tokenization溢价与主权成本

微调无法摆脱基座模型的继承属性,全球南方面临隐性主权成本。
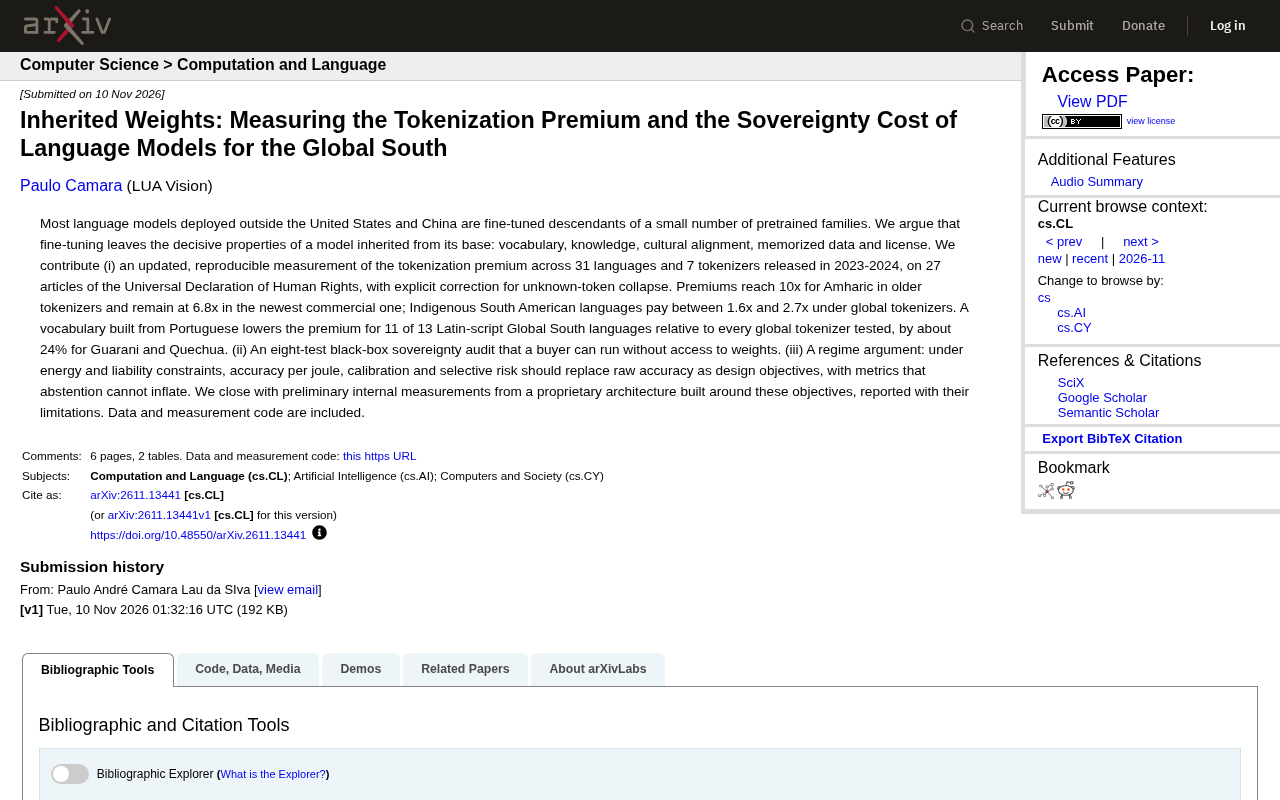
论文指出,美国和中国之外部署的语言模型多为少数预训练家族的微调后代,而微调无法改变基座继承的词汇表、知识、文化对齐、记忆数据和许可证,这使全球南方国家不仅面临技术依赖,还承担隐性主权成本。研究测量了31种语言和7个分词器,发现阿姆哈拉语溢价高达10倍、最新商业分词器仍为6.8倍,南美原住民语言为1.6至2.7倍;而基于葡萄牙语的词汇表可使11种拉丁字母全球南方语言的溢价下降,瓜拉尼语和克丘亚语降约24%。论文还提出八项黑盒主权审计测试,并主张以每焦耳精度、校准和选择性风险取代原始精度作为设计目标。
大多数在美国和中国之外部署的语言模型,都是少数预训练家族的微调后代。一篇新论文指出,微调并不能改变模型从基座继承的决定性属性:词汇表、知识、文化对齐、记忆数据和许可证。这意味着,对于全球南方国家而言,使用这些模型不仅意味着技术依赖,更意味着一种隐性的主权成本。
微调掩盖不了的继承性
论文的核心论点是,微调只是在基座模型上做表面调整,而基座模型的关键特征会原封不动地传递给下游应用。词汇表决定了模型如何切分文本,直接影响多语言场景下的效率与公平;预训练知识决定了模型理解世界的框架;文化对齐反映了基座模型训练数据中的价值观;记忆数据可能包含敏感信息;许可证则限定了使用边界。
这一视角将语言模型的选择从单纯的技术决策提升到了战略层面。对于希望发展本土AI能力的地区,依赖微调模式意味着核心能力始终受制于人。
Tokenization溢价:多语言场景中的隐形税
论文对31种语言和7个分词器(tokenizer,2023-2024年发布)进行了可复现的测量,使用《世界人权宣言》的27条文章作为测试语料,并明确校正了未知token崩溃(unknown-token collapse)带来的偏差。
测量结果揭示了显著的不平等:阿姆哈拉语(Amharic)在较旧的分词器中溢价高达10倍,即使在最新的商业分词器中仍保持在6.8倍。南美原住民语言在全球分词器下的溢价在1.6倍到2.7倍之间。这意味着,处理同样语义内容时,这些语言需要消耗更多的token,直接推高了推理成本,也降低了有效上下文长度。
更有意思的是,一个基于葡萄牙语构建的词汇表,相对于所有测试过的全球分词器,能将13种拉丁字母书写的全球南方语言中11种的溢价降低,其中瓜拉尼语(Guarani)和克丘亚语(Quechua)的溢价降低了约24%。这证明,针对性的词汇表设计可以显著缓解tokenization溢价问题,为语言多样性提供了可行的技术路径。
分词器(Tokenizer)与BPE
分词器是语言模型处理文本的第一步:它将原始字符串切分为子词单元(token),再把每个token映射为整数ID送入模型。主流模型普遍采用字节对编码(BPE)或其变体:从字符级词表出发,反复合并语料中最高频的相邻符号对,直到达到预设的词表规模。词表的构成完全由预训练语料的语言分布决定——英语和少数高资源语言占据绝大部分合并名额。
这带来一个直接后果:同一段语义内容,在词表覆盖不足的语言中会被切分成更多、更碎的token。例如一个在英语中对应1个token的常用词,在阿姆哈拉语或克丘亚语中可能被切成4至8个token。由于推理成本、上下文窗口占用都与token数量成正比,词表覆盖的失衡就转化为实实在在的经济成本差异,这正是“tokenization溢价”的技术根源。
未知token崩溃(unknown-token collapse)
在多语言分词评测中,一个常见的测量陷阱是:当分词器遇到词表外的字符时,会将其映射为统一的未知标记(UNK)或替换字符。如果不加校正,原本需要多个token的文本会被压缩成少量UNK,从而在统计上“降低”token数量,使该语言看起来溢价很低甚至为负。
论文明确校正了这一偏差,做法通常是改用字节级回退(byte fallback)或将未知字符按UTF-8字节逐字节切分,确保任何语言的内容都能被完整表示,再计算token数。这一处理对于结论的可信度至关重要——若不校正,词表最匮乏的语言反而会显示出最低的溢价,得出与事实完全相反的结论。
主权审计:买家可以自己做的八项测试
论文提出了一个八项测试的黑盒主权审计框架,买家无需访问模型权重即可运行。这套框架的价值在于,它将主权评估从抽象讨论变成了可操作的工具。对于政府机构、企业或研究组织来说,这意味着可以在采购决策中引入具体的主权维度考量,而不仅仅关注基准测试分数。
审计的八项测试覆盖了模型行为的多个方面,虽然论文摘要未逐一列出,但其设计理念是让使用者能够独立验证模型是否符合本土需求与价值观。
从原始精度到每焦耳精度:设计目标的范式转移
论文的第三个贡献是一个制度性论点:在能源和责任的约束下,每焦耳精度(accuracy per joule)、校准(calibration)和选择性风险(selective risk)应当取代原始精度成为设计目标,并且需要采用不会被弃权(abstention)行为虚高的度量指标。
这一观点切中了当前AI评估体系的盲点。原始精度可以通过回避不确定样本而虚高,但校准和选择性风险指标能够揭示模型在真实场景中的可靠性。在能源成本日益成为AI部署瓶颈的背景下,每焦耳精度直接关联到可持续性和可及性。
论文最后提到了基于这些目标构建的专有架构的初步内部测量结果,并说明了其局限性。数据与测量代码均已公开,这为后续研究提供了可复现的基础。
校准与选择性风险
校准(calibration)衡量的是模型输出的置信度与实际正确率之间的一致程度:一个校准良好的模型,在它声称“80%把握”的样本上,真实正确率应接近80%。原始精度无法反映这一点——模型可能准确率很高,但置信度分布完全失准,导致下游系统无法据此设定阈值。
选择性风险(selective risk)则关注模型在“被采纳的预测”上的错误率:当系统允许模型弃权(abstention)、只对高置信样本作答时,覆盖率与错误率之间形成一条权衡曲线。只看原始精度会被弃权行为虚高——模型大量弃权后,剩余样本自然容易答对。因此需要同时报告覆盖率与选择性风险,才能真实刻画模型在有人机协作、风险敏感场景中的可用性。
对全球南方的启示
这项研究将语言模型的技术选择与主权问题联系起来,提供了一个可量化的框架。对于全球南方国家,关键洞察在于:微调不是万能药,基座模型的继承属性决定了能力上限和依赖关系。通过定制词汇表降低tokenization溢价、运行黑盒主权审计、调整设计目标,是在现有约束下争取技术自主的可行步骤。
论文的局限在于,专有架构的测量结果是初步且内部的,需要更多独立验证。但其所提出的测量方法和分析框架,已经为讨论语言模型的地缘政治经济学提供了有价值的工具。
相关推荐

美国新车均价突破5.1万美元:AI与软件定义汽车如何推高成本
美国新车平均价格突破5.1万美元创历史新高。本文从软件定义汽车、中央计算架构、辅助驾驶传感器预埋与车端AI推理成本角度,分析AI与软件如何推高整车售价,以及这一趋势对消费者和厂商的影响。
Anthropic无预警移除Claude Code功能,开发者社区不满
Anthropic无预警移除Claude Code功能引发开发者不满。本文分析事件经过、开发者敏感原因及对AI编程工具生态的启示,探讨厂商如何平衡迭代与用户信任。
MAFM:流匹配生成中的物理约束新解法
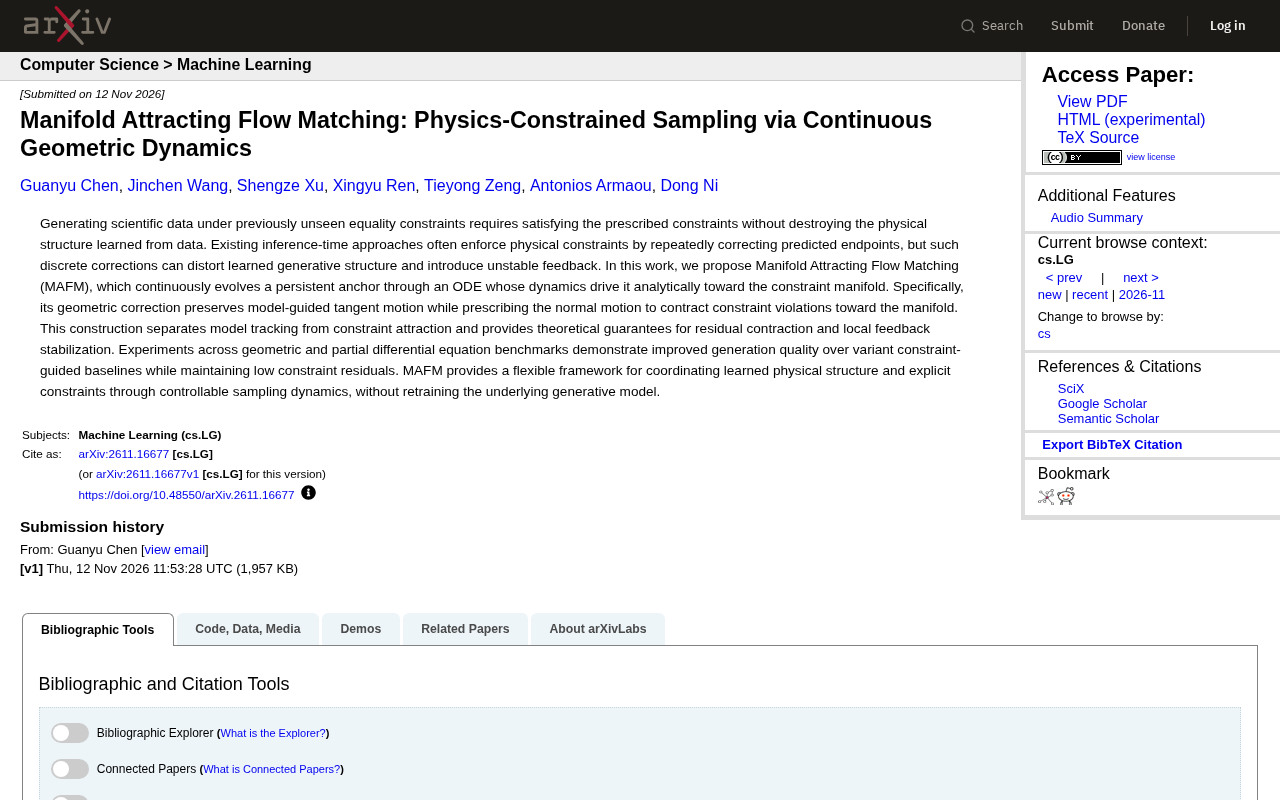
MAFM提出用连续几何动力学替代离散校正,在流匹配生成中实现物理约束满足。本文解析其切向/法向运动解耦机制、理论保证与实验表现,并讨论局限与展望。