机架级AI部署:Giga Computing展示背后的设施接口思考

机架级AI采购的关键不是算力数字,而是接口归属、冷却边界与运维责任的清晰划分。
本文以Giga Computing在OCP Global Summit展示NVIDIA Vera Rubin NVL72平台及集成液冷OCP ORV3机架为切入点,系统梳理了机架级AI系统采购中容易被忽视的工程与运营细节。文章指出,采购决策的核心不是厂商宣传的算力峰值,而是机架与建筑设施之间的电气热力接口规格、设施回路与设备回路的边界划分、交付路线与维护空间的同步规划,以及管理信号到运维角色的明确映射。多供应商产品组合还需指定跨组件责任归口,并维护一份可审批变更的受支持配置记录。文章最终将厂商展台的价值定位于「让机架级采购的广度变得可见」,而买家的真正工作,是将这种广度转化为可落地、可维护的具体工程方案。
机架级AI系统的采购,正在改变数据中心的规划边界。当交付团队面对一套预组装的系统时,首先要搞清楚的不是算力峰值,而是这套系统如何接入建筑、如何维护、每个接口归谁负责。这些看似琐碎的决策,往往在第一个工作负载分配之前,就已经决定了部署进度。
Giga Computing 在其 10 月 12 日的公告中,描述了计划在 OCP Global Summit 上展出的内容:一套配置好的 NVIDIA Vera Rubin NVL72 平台、代表性的 Vera CPU 与 Groq 3 LPX 节点,以及一个覆盖计算、存储、管理和 GPU 系统的 OCP ORV3 机架。公司表示其 OCP 服务器产品线集成了直接液冷技术,展台还将包括合作伙伴 TaiSol Electronics 提供的冷却分配单元(CDU)。
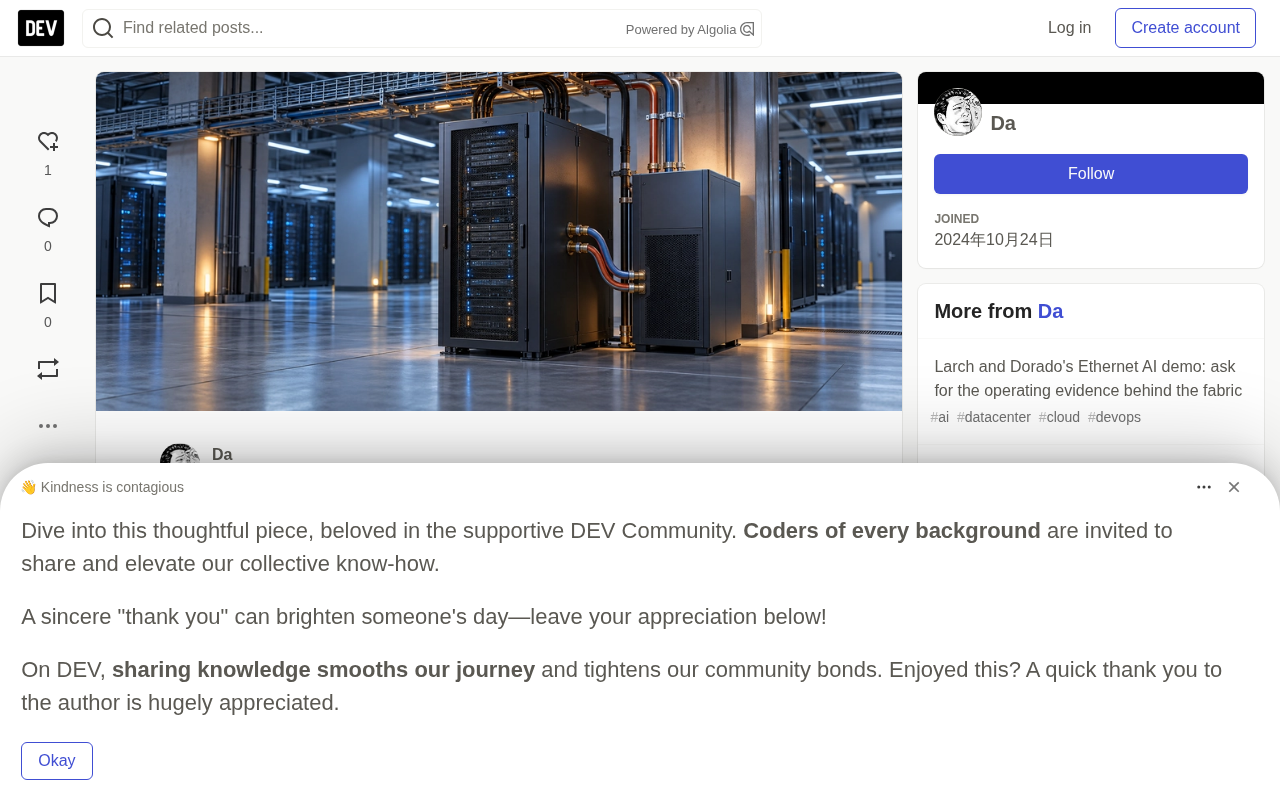
需要清醒认识的是,这是一则展会公告。它描述的是一个产品组合和展示方案,而非现场调试记录或经过独立验证的应用基准测试。采购方在把厂商的性能话术写进容量规划或财务模型之前,应当索要针对具体部署场景的证据。真正有价值的采购对话,应当从一份记录完整的「机架与设施之间接口清单」开始——而这场展示恰好把这类对话的多个关键环节一次性摆在了台面上。
先确定连接方式,再预留空间
一个机架位置应当附带一份经过各方认可的电气与热力规格。供电方式、支持的负载、保护要求、系统可运行的条件范围——这些都需要明确定义。更重要的是,除了正常运行工况,维护与故障场景下的假设也必须一并记录在案。
在冷却方面,关键在于厘清设施回路(facility loop)与设备回路(equipment loop)之间的边界。针对实际采购的配置,要明确所需的温度、流量条件、水质标准以及连接接口。同时还要指派专人负责核查这些条件,并在参数偏离约定范围时做出响应。
一个兼容的接头只是协议的一小部分。设施团队更需要知道:当冷却流量中断、电力恢复、或设备被下线检修时会发生什么。这些操作时序必须在安装工作开始前就与供应商逐一审查清楚。
设施回路与设备回路的边界划分,是液冷数据中心中最容易产生责任灰区的环节。设施回路通常由楼宇机电团队负责,涵盖冷却塔、主管路、换热器及一次侧水泵;设备回路则由IT或服务器供应商管理,负责将冷量分配至各计算节点的冷板或浸没槽。两个回路通过冷却分配单元(CDU)进行热交换,CDU本身的归属与维护责任若未在合同中明确,往往成为故障时推诿的焦点。OCP ORV3机架标准对机架侧的液冷接口有规范定义,但这并不自动意味着设施侧具备匹配的水质、压力或流量条件。水质标准尤其容易被忽视——铜铝混用的冷却回路对pH值和腐蚀抑制剂的要求与全铜系统不同,一旦不符将导致泄漏或沉积,而这类损坏通常不在设备保修范围之内。
交付路线与服务路线要一起规划
一套系统即便能装进最终位置,也得先「运」到那个位置。采购方应当向供应商索要交付配置、搬运要求,以及在组装好的机架进入机房前需要完成的任何前置工作。要拿着设备实际尺寸去核对卸货区、门洞和走廊的通行路线。
接着要审视维护空间。确认哪些组件可以原位更换,哪些干预操作需要排空、隔离或移动设备。工具、起吊通道以及拆下部件的临时存放空间,都要提前考虑进去。
这项评估应当把实际动手的人也纳入进来。设施工程师、服务器技术员和冷却承包商,各自看到的边界可能完全不同。在图纸上解决这些分歧,远比在真正的服务窗口期中临时发现要容易得多。
把管理信号接入设施决策
一套集成机架需要一条约定好的路径,把运行状态上报给更大范围的运维团队。要明确区分:哪些告警来自服务器、哪些来自冷却设备、哪些描述的是设施供电状态。还要搞清楚这些信号如何映射到使用该机架的工作负载上。
响应机制必须明确到人。谁负责调查一条警告、谁有权降低工作负载、谁能授权关机——这些都要写死。还要规定:当常规管理路径不可用时,技术员如何获得访问权限。
交接时要保留自动化的边界。对于定义明确的狭窄场景,自动响应或许是合适的,但操作员仍然需要一份关于「发生了什么、如何恢复服务」的记录。配置的归属权和变更审批流程,应当写进同一份运维文档。
集成机架的管理信号通常来自多个异构系统:服务器基板管理控制器(BMC)、冷却单元的本地控制器、PDU的电力监控模块,以及机架级别的环境传感器。这些信号往往使用不同协议(IPMI、Redfish、SNMP、Modbus等),汇聚到统一运维平台时需要额外的适配层。更关键的问题是告警的语义对齐:一条来自CDU的「流量低」告警,对冷却承包商意味着需要检查泵组,对IT运维人员则意味着可能需要降低计算负载,而对设施经理则可能指向主管路压力异常。若这三类角色各自订阅不同的告警视图,协调响应的时间窗口就会被延误。在部署前绘制一张「告警-角色-响应动作」映射表,是避免此类延误最直接的工程手段。
采购一个受支持的配置,并持续维护它
一个同时包含计算、存储、管理和冷却的产品组合,往往牵涉多家供应商。采购方应当要求指定一个跨组件问题的归口责任人,以及一份覆盖交付硬件、固件和管理软件的「受支持配置记录」。
同时要明确交接之后变更这份记录的流程。更换一个组件、更新一次固件,都应当有审批路径,并有办法确认系统仍处于其受支持的运行条件之内。
对于面向 B2B 的技术型供应商而言,这其实是一块可以向客户提供的实际价值:协调接口评审、记录责任划分、让交付配置始终与运维记录保持一致。Giga Computing 的这场展示让机架级采购的广度变得可见,而对买家来说,真正有用的产出是一份部署计划——把这种广度,连接到建筑本身,以及未来将维护它的团队身上。
「受支持配置记录」(Supported Configuration Record)在多供应商集成场景中的价值,往往到固件更新时才会充分显现。单一供应商的服务器更新流程已较为成熟,但当一次NVIDIA固件升级需要同步验证与特定版本的HGX基板固件、交换机固件及管理软件的兼容性时,若无一份维护中的配置矩阵,极易陷入「更新一处、破坏另一处」的循环。行业中通常将这份记录称为BOM(物料清单)的运营延伸版本,包含已验证的固件版本组合、变更审批记录及回滚路径。指定一个跨组件问题的归口责任人——有时称为「系统集成商」或「主承包商」——其核心职责之一,就是维护这份记录的时效性,并在任何一个组件发布更新时评估对整体配置的影响。
结语:展会之外的真功夫
机架级 AI 的热度集中在芯片与算力数字上,但这篇分析提醒我们,决定部署成败的往往是那些不性感的细节:接口归属、冷却边界、交付路线、告警响应。厂商的展台负责展示能力的广度,买家的工作则是把这种广度转化为可落地、可维护的工程方案。采购一套系统容易,运营好它才是长期的考验。
相关推荐

REA:无需编码,用AI逆向任意应用
REA是一款爆火GitHub的开源AI逆向工程工具,可让Claude、Codex等AI代理直接分析任意应用并生成功能克隆,无需编码。本文介绍其工作原理、安装方法、实测案例及法律风险。

2026年AI编程工具横评:Claude、ChatGPT、Gemini谁最强?
2026年五款主流AI编程工具横评:Claude Code、ChatGPT Codex、Gemini、DeepSeek和GitHub Copilot在真实项目、定价与代码质量上的全面对比,帮你决定每月20美元该花给谁。

ChatGPT Codex克隆任意软件?实测风险与真相
YouTube短视频宣称用ChatGPT Codex或Claude Code即可克隆Adobe、Excel、Figma等软件并终身免费使用。本文拆解其技术可行性、法律风险与私信引流套路,说明AI编程工具真正适合的用法。