即梦Agent做AI短剧/漫剧全流程实操:零基础也能低成本成片
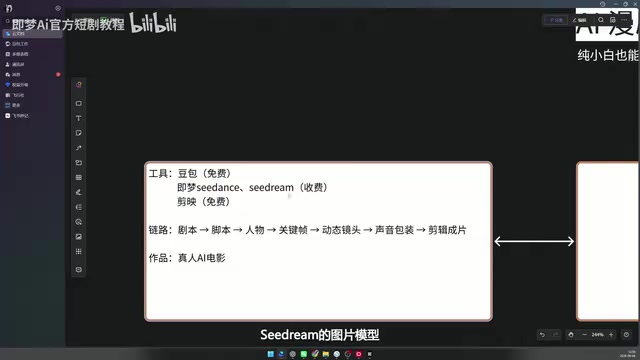
用豆包+即梦+剪映三件套,零成本走完AI漫剧/短剧从剧本到成片的完整七步链路。
这篇文章梳理了一套面向零基础用户的AI漫剧/短剧制作课程(第一节)的核心内容。课程将工具链精简为国内可直接访问的豆包(剧本)、即梦Seedream/Seedance(出图出视频)、剪映(剪辑)三件套,并借助豆包桌面版的官方赠送额度实现近乎零成本入门。整个成片流程被拆解为剧本、脚本、人物设计、场景融图、视频生成、配音配乐、剪辑七个清晰环节,并给出各环节的关键实操要点:人物设计需纯色背景三视图、场景注重空间占位关系、视频生成优先用全能参考并@标注参考图、特定轨迹镜头回归首尾帧模式、配音用ComfyUI+TTS2做声音克隆保证一致性。课程强调方法论优先于特定工具,流程框架可迁移至其他模型与平台。
AI短剧和漫剧近来成为内容创作的热门赛道,但不少想入门的人被工具门槛挡在外面——网络问题、专业软件复杂、成本高企。这套由B站UP主推出的「AI漫剧制作启蒙课」给出了一个更接地气的解法:用豆包、即梦、剪映三件套,把整个AI成片链路走一遍,尽可能把学习成本压到零。
本文基于该课程第一节的内容,梳理这套零基础全流程方案的工具选型、制作链路与关键注意事项,帮你理解AI短剧成片到底要经历哪些环节。
为什么从「启蒙课」重新讲起
作者坦言,此前讲过不少偏专业的课程,用到的是ChatGPT、Midjourney、ComfyUI等更高级的工具。但实际反馈是:很多同学根本跟不上实操。原因很直接——这些工具存在网络访问、基础知识等多重门槛,讲得再基础,学员也很难在自己电脑上一步步复现。
于是作者把工具链彻底简化,改用国内可直接上手的组合。这个思路的价值在于:即便日后进入工作岗位,公司提供的是其他模型、平台甚至第三方API,只要掌握了完整流程和底层逻辑,就能快速迁移。换句话说,课程教的是方法论而非特定工具。
三件套工具与「近乎零成本」的玩法
整套课程只需要三个工具:
- 豆包:作为大语言模型(LLM),负责剧本和脚本创作
- 即梦:提供图片模型 Seedream(人物、场景)和视频模型 Seedance(动态镜头)
- 剪映:负责最终剪辑合成
除了即梦的 Seedance 视频模型和 Seedream 图片模型需要付费外,其余全部免费。而作者给出的省钱关键在于:这两个付费模型也可以在豆包APP桌面版里调用。
课程录制时正逢豆包上线Agent模式(「豆包工作」),官方有赠送30天标准版会员的活动,学生党还能领三个月开学福利,普通用户下载并更新桌面版APP也能获得30天赠送额度。作者演示的账号额度可用至9月25号。借助这些额度,就能免费使用 Seedream 5.0 Pro/Lite 出图,以及 Seedance 2.0/2.5 生成视频——按当下条件基本可实现零成本学习。
值得一提的是模型选型上的取舍:即便Seedance 2.5已经推出,课程仍主推2.0,理由是在保证效果的前提下把成本压到最低。
完整成片链路:从剧本到成片
课程共7节,核心是把AI漫剧/短剧的完整生产链路拆解清楚。作者明确本次要带大家做的是真人AI电影(而非普通短剧),因此对质量要求相对拔高,并展示了为课程制作的电影PV《仙岛篇》作为成片目标,本期课程会实现该电影的前半段。
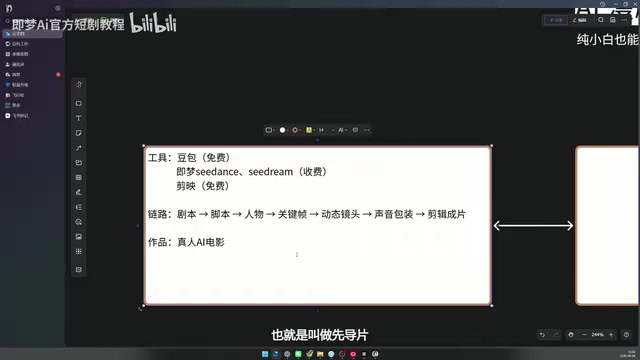
整个链路可以拆成几个关键环节:
剧本与脚本设计
无论漫剧还是真人短剧,前期的剧本、脚本逻辑是一致的,区别只在后期人物设计与生成环节。
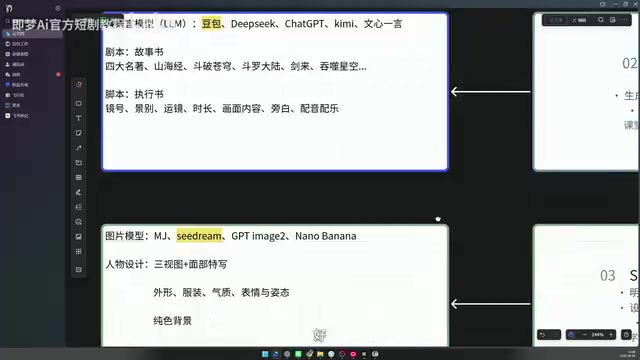
- 剧本:相当于小说或故事书,让创作者对整个视频有统筹的了解。作者以《斗破苍穹》《吞噬星空》等由小说改编的国漫为例,说明小说本身就是「剧本」的原型。
- 脚本:即执行书。针对AI视频,至少要包含镜号、景别、运镜、时长、画面内容、旁白以及配音配乐,让AI执行人员一眼看懂该怎么做、提示词怎么写。
这里的一个实操要点:前期设计只需判断一件事——这个镜头用真人做出来合适不合适。
景别是脚本中一个基础但关键的概念,指摄像机与拍摄主体之间的距离关系所形成的画面范围。常见景别从远到近依次为:远景(展现宏观环境)、全景(呈现人物全身与场景关系)、中景(腰部以上,常用于对话)、近景(胸部以上,突出表情与情绪)和特写(局部细节,如面部或手部)。在AI视频脚本中,景别的选择直接影响提示词的写法——不同景别对人物在画面中的占比、背景虚实程度的要求截然不同。运镜则指镜头的运动方式,如推镜(向主体靠近)、拉镜(远离主体)、摇镜(横向扫描)、跟镜(跟随运动主体)等。在Seedance等视频模型中,运镜方式需要用自然语言明确描述,是控制镜头动态感、叙事节奏的重要手段。
人物设计
这一步进入图片模型环节,可选 Midjourney、Seedream、GPT Image、Nano Banana 等,课程统一用 Seedream。作者特别提醒要区分即梦的两个模型:Seedance 是视频模型,Seedream 是图片模型。
人物设计只需产出人物全身三视图和面部特写,关注外形、服装、气质、表情与姿态等细节。一个容易被忽视的点是:背景必须是干净的纯色,这样后期做人物参考时才不会有干扰。
场景生成与人物融图
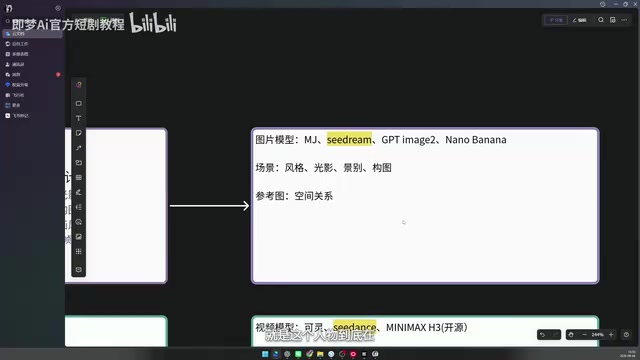
第四节根据剧本、脚本提取关键提示词生成场景,核心目标是让人物与场景「融图」。这一步仍是图片生成,模型依旧用 Seedream。
场景需要关注风格、光影、构图、景别;而参考图(关键帧)要处理好空间关系——人物在场景哪个位置、两个人物如何占位,这些是重点注意事项。
视频生成
前面所有图片就是生成视频的参考图。当前主流是全能参考模式,无论 Seedance 2.0/2.5 还是开源模型 MiniMax,都会用到。操作要点有两个:提示词要分段写清晰;参考图要逐一用 @ 符号标注,让模型看得更明确。
在有明确轨迹变化、且能生成首帧与尾帧状态图的特定情况下,作者建议回归首尾帧模式——因为全能参考本质是AI想象,而首尾帧能规定明确的运动轨道。
全能参考模式与首尾帧模式是当前主流AI视频生成工具中两种核心的生成范式。全能参考(也称单帧参考或图生视频)是指模型以一张静态参考图为基础,由AI自由推演后续的运动变化,灵活度高但运动轨迹不可控;首尾帧模式则要求用户同时提供视频的起始帧和结束帧两张图,模型在两个确定状态之间进行插值生成,能精确控制物体或人物的运动起点与终点。两种模式各有适用场景:前者适合需要自然动态(如风吹树叶、人物细微表情变化)的镜头;后者适合有明确位移或动作轨迹的镜头,例如角色从画面左侧走到右侧、镜头从近景推至特写等。MiniMax、Seedance等主流模型均支持这两种模式。
配音配乐
配乐现在很多视频模型可直接自带。但配音尤其是旁白,为保证声音一致性,需要找到合适的克隆模板来源,通过ComfyUI工作流克隆。作者强调不必被ComfyUI吓到——这是已经调好的工作流,底层只用了一个专门做声音克隆的开源模型 TTS2,效果不错,讲到对应章节时会直接发工作流给学员。
ComfyUI 是一款基于节点式工作流的开源AI图像与多媒体生成框架,用户通过连接不同功能节点(如模型加载、提示词输入、采样器等)来构建定制化的生成流程,无需编写代码。它的学习曲线相对陡峭,但优势在于高度可定制、支持接入大量开源模型。文中提到的 TTS2(Text-To-Speech 2)是一种开源语音合成与克隆模型,能够基于少量目标声音样本,将任意文本转换为高度接近目标音色的语音输出。在AI短剧制作中,声音克隆的意义在于保持旁白或角色配音在整部片子中的音色一致性——若每段配音分开生成,极易出现音色漂移问题。作者将直接提供配置好的ComfyUI工作流,学员无需从零搭建节点,降低了使用门槛。
剪辑合成
最后用剪映完成剪辑合成,涉及舍弃冗余素材、控制镜头节奏等,留到第七节详讲。
这套方案适合谁
从课程设计看,它面向的是完全没有AI视频经验、又被工具门槛劝退的人群。用国内可直接访问的豆包+即梦+剪映,配合官方赠送额度,把「跟不上实操」这个最大痛点解决掉。
更重要的是,课程把成片拆解为剧本→脚本→人物→场景→视频→配音→剪辑七个清晰环节。即便未来换用更高级的模型或第三方API,这套流程框架依然通用。对于想切入AI短剧/漫剧赛道的创作者来说,先建立起完整的流程认知,再逐环节打磨细节,是一条更稳的路径。
相关推荐

AI编程为何离不开Git?从版本回退到AI辅助命令全解析
Git是AI编程的必备工具。本文解析Git分布式版本控制在AI编程中的价值,包括应对AI幻觉的版本回退、分支管理等核心操作,以及如何用豆包、AI输入法等工具快速生成Git命令,帮助新手零基础入门。

拒绝AI胡编:一款"说不了谎"的求职信生成器是如何炼成的
一位开发者因AI求职信工具凭空捏造其Kubernetes经验和管理经历而屡遭拒信,于是打造了CoverCraft——通过代码计算评分、GitHub提交记录背书、对抗性审查与人工审批四重机制,构建一款"无法说谎"的AI求职信生成器。本文解析其对抗AI幻觉的工程设计。
Perplexity携手美国运通:为小企业主打造即用型AI技能库
Perplexity携手美国运通:为小企业主打造即用型AI技能库
Perplexity 联合美国运通推出面向小企业卡会员的即用型 AI 技能库,内置现金流预测、营销活动生成等预构建工作流,用户无需编写提示词即可让 AI 处理日常业务任务。