机器学习的数学基础:从Mitchell定义到概率视角全解析

引言:机器学习到底是什么?
当我们谈论"机器学习"(Machine Learning)时,究竟指的是什么?一台会学习的机器?这样的说法未免太过模糊。这也是许多初学者在踏入这个领域时最常遇到的困惑——概念听起来很酷,但缺乏一个精确的定义作为思考的起点。
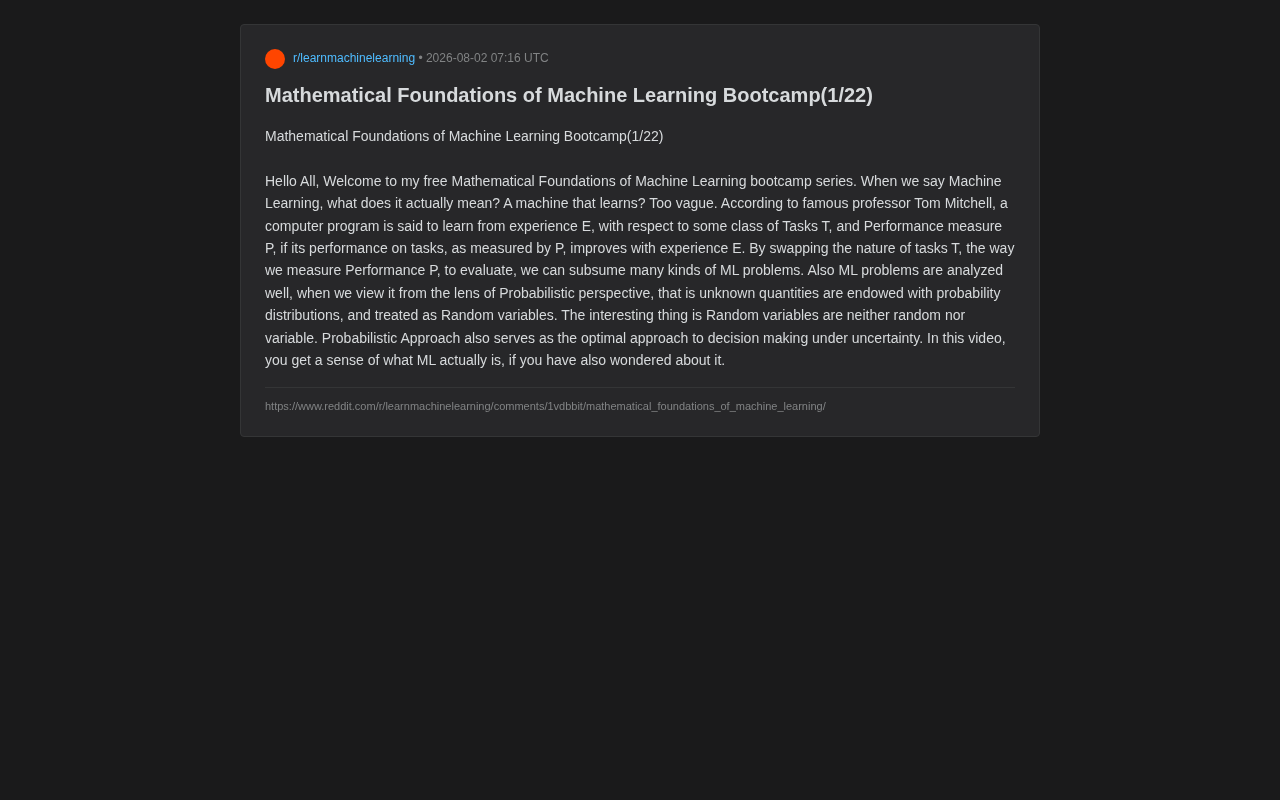
近期,一位内容创作者在 Reddit 上发起了一个免费的"机器学习数学基础训练营"系列(Mathematical Foundations of Machine Learning Bootcamp),第一讲(1/22)正是从这个最根本的问题切入。本文将围绕这一素材,梳理机器学习的经典定义、概率视角的重要性,以及为什么数学基础对理解 ML 如此关键。
Tom Mitchell 的经典定义:机器学习的三要素
要给"机器学习"下一个严谨的定义,绕不开卡内基梅隆大学著名教授 Tom Mitchell 的经典表述。他在教科书中提出:
如果一个计算机程序在某类任务 T 上的性能 P,能够随着经验 E 的积累而提升,那么我们就说这个程序从经验 E 中学习了。
Tom Mitchell 是卡内基梅隆大学机器学习系的创始系主任,该系成立于2006年,是全球第一个专门以"机器学习"命名的学术系。这一定义最早出现在他1997年出版的教科书《Machine Learning》中,该书至今仍是许多高校 ML 课程的标准教材。在此之前,AI 研究者们对"学习"的定义众说纷纭——有人强调符号推理能力的增长,有人强调神经网络对生物系统的模拟。Mitchell 的三要素框架超越了具体实现方法,提供了一个与算法无关的元定义,将机器学习从一个模糊的人工智能子领域提升为一个有着明确研究对象和评价标准的独立学科。
这个定义之所以经久不衰,还在于它巧妙地回避了当时AI领域的路线之争。1990年代,符号主义(基于逻辑推理的AI)与连接主义(基于神经网络的AI)两大阵营争论激烈。符号主义以McCarthy、Minsky为代表,主张通过逻辑规则和知识表示实现智能,其典型产物是专家系统;连接主义以Rumelhart、McClelland为代表,受生物神经元启发,主张通过大量简单计算单元的并行连接实现智能学习。Mitchell 的三要素定义不偏向任何一种实现方式——无论你用决策树、支持向量机还是神经网络,只要满足T-P-E框架,都属于机器学习的范畴。这种抽象层次的选择使得该定义在深度学习革命后依然完全适用,甚至可以无缝覆盖2017年之后兴起的大语言模型:T是文本生成、P是困惑度(perplexity)、E是海量文本语料。
这个定义的精妙之处在于它的可操作性和通用性。它没有停留在"机器像人一样学习"这种拟人化的比喻上,而是把学习拆解成三个可以明确定义、可以度量的要素:任务(T)、性能度量(P)和经验(E)。
通过三要素统一各类机器学习问题
更重要的是,这个框架具有极强的概括能力。通过替换任务 T 的性质、改变性能 P 的度量方式,我们几乎可以囊括所有类型的机器学习问题:
- 分类任务:T 是判断邮件是否为垃圾邮件,P 是分类准确率,E 是历史标注数据。
- 回归任务:T 是预测房价,P 是均方误差(Mean Squared Error,衡量预测值与真实值差距的平方的平均值),E 是历史成交记录。
- 强化学习:T 是在游戏中获得高分,P 是累计奖励,E 是与环境的交互过程(即智能体通过试错不断调整策略的历史轨迹)。
值得注意的是,这三类任务对应了机器学习的三大范式。监督学习(分类和回归)依赖标注数据,其理论基础是统计学习理论(Vapnik的VC维理论和PAC学习框架);无监督学习(如聚类、降维)在没有标签的情况下发现数据的内在结构;强化学习则源于动态规划和最优控制理论,核心挑战是在探索(exploration)与利用(exploitation)之间取得平衡。Mitchell的定义统一了这三大范式,区别仅在于"经验E"的形式不同——有标签的数据、无标签的数据、还是交互反馈。
换句话说,Mitchell 的定义不是一句空话,而是一个可以套用到无数具体场景的"模板"。这也是为什么它历经数十年仍然是机器学习入门教材的开篇之言。
概率视角:理解机器学习的最佳透镜
训练营第一讲强调的另一个核心观点是:机器学习问题在概率视角下能够得到最好的分析。
为什么要用概率的眼光看待机器学习?
现实世界充满不确定性。我们观测到的数据往往是有噪声的、不完整的,而我们想要预测的未来更是未知的。概率论恰恰是描述和处理不确定性的数学语言。
概率论作为严格数学分支的确立,要追溯到 Andrey Kolmogorov 于1933年发表的《概率论基础》(Grundbegriffe der Wahrscheinlichkeitsrechnung)。在此之前,概率被视为一种不够严谨的"经验工具"——频率学派认为概率是无限次重复实验中事件发生的频率极限,而古典学派则依赖"等可能性"假设(如拉普拉斯的"不充分理由原则")。这些定义在面对连续分布、条件概率的复杂嵌套等情况时经常陷入悖论。Kolmogorov 用测度论的语言给出了公理化定义——仅需三条公理(非负性、规范性、可列可加性)便构建起了整个概率论大厦,使概率论成为严格的数学分支。这一框架为后来的随机过程(如Wiener过程、马尔可夫链)、信息论(Shannon 1948)、乃至现代机器学习的理论分析(如PAC-Bayes界、信息瓶颈理论)奠定了不可动摇的基础。
在概率视角下,那些未知的量都被赋予概率分布,并被当作随机变量(Random Variable)来处理。这里有一个颇有哲学意味的观点:随机变量既不"随机",也不是"变量"。
这句话初看令人费解,但深究其数学本质便豁然开朗——随机变量在数学上其实是一个从样本空间到实数的确定性函数。在 Kolmogorov 公理化概率论框架中,随机变量被严格定义为从概率空间 (Ω, F, P) 到可测空间(通常是实数轴配备 Borel σ-代数)的可测函数。这里 Ω 是样本空间(所有可能结果的集合),F 是事件的 σ-代数(我们关心的事件集合,需满足对补运算和可列并运算封闭),P 是概率测度(对事件赋予概率值的函数,满足Kolmogorov三公理)。给定一个样本点 ω∈Ω,随机变量 X(ω) 的值是唯一确定的实数。所谓的"随机性"来自于我们对底层事件的不确定认知——我们不知道自然选择了哪个样本点 ω——而非函数本身的不确定。这个认识论与本体论的区分至关重要:不确定性存在于观察者的知识中,而非世界本身(至少在经典概率论的语境下如此,量子力学另当别论)。理解这一点,是从直觉走向严谨数学思维的重要一步,也是后续学习条件期望(作为可测函数的投影)、马尔可夫链(通过转移核描述状态演化)、鞅论等高级概念的基础。
不确定性下的最优决策:贝叶斯方法
概率方法的价值不止于建模,更在于决策。概率方法是在不确定性下进行决策的最优途径。
这一论断有着坚实的理论支撑。贝叶斯决策理论的核心思想可以形式化表述为:给定观测数据 x,选择使期望损失最小化的行动 a*,即 a* = argmin_a E[L(θ,a)|x],其中 L 是损失函数,θ 是未知参数,期望是关于后验分布 p(θ|x) 计算的。而后验分布通过贝叶斯定理获得:p(θ|x) ∝ p(x|θ)·p(θ),它将我们的先验知识 p(θ)(在看到数据之前对参数的信念)与数据的似然 p(x|θ)(在给定参数下观测到数据的概率)优雅地结合在一起。
贝叶斯定理本身极为简洁——它不过是条件概率定义的直接推论——但其哲学和实践意义却深远无比。Thomas Bayes 牧师于18世纪提出的这个想法,直到20世纪后半叶才随着计算能力的提升(特别是马尔可夫链蒙特卡洛方法MCMC的发展)而真正在实践中大放异彩。
值得注意的是,贝叶斯方法与频率统计学之间存在深刻的哲学分歧。频率学派认为参数θ是固定的未知常数,概率只能描述可重复事件的长期频率——因此频率学派会说"95%置信区间"意味着如果重复实验无限次,95%的区间会包含真实参数值;贝叶斯学派则将概率视为对不确定性的主观度量,允许对参数本身赋予概率分布——因此贝叶斯学派会说"参数有95%的概率落在该可信区间内"。在机器学习实践中,贝叶斯方法的优势尤为突出:它天然提供预测的不确定性量化(而非仅给出点估计),这在医疗诊断和自动驾驶等安全关键应用中至关重要;在小样本场景下通过先验信息弥补数据不足(如迁移学习中的先验知识编码);并且通过边际似然 p(x) = ∫p(x|θ)p(θ)dθ 自动实现模型复杂度的惩罚(即贝叶斯奥卡姆剃刀效应——复杂模型需要将概率质量分散到更大的参数空间,导致边际似然下降)。
这个框架的最优性不仅仅是直觉上的合理,还可以通过完备类定理(Complete Class Theorem)严格证明——在温和条件下,任何可容许的决策规则(即不被其他决策规则在所有情况下一致优于的规则)都是某个先验下的贝叶斯规则。这个定理由 Abraham Wald 在1940年代奠基的统计决策理论中建立,它从根本上论证了贝叶斯方法的逻辑必然性:如果你不想被"支配"(dominated),你必须是贝叶斯的。从垃圾邮件过滤(朴素贝叶斯分类器至今仍是基线方法)到自动驾驶的路径规划(贝叶斯滤波处理传感器噪声),从医学诊断(贝叶斯网络整合多种检查结果)到金融风控(贝叶斯时间序列模型捕捉市场regime变化),背后都隐藏着这套概率决策的逻辑。
为什么数学基础对学好机器学习如此重要?
这个训练营取名为"数学基础"(Mathematical Foundations),本身就传递了一个明确的信号:想要真正掌握机器学习,绕不开数学。
很多初学者热衷于调用现成的框架和 API(如 scikit-learn、PyTorch、TensorFlow),几行代码就能训练一个模型。scikit-learn(2007年首发,由David Cournapeau作为Google Summer of Code项目启动)封装了经典机器学习算法(SVM、随机森林、K-Means等),以统一的fit/predict接口著称,适合表格数据和中等规模问题;TensorFlow(Google于2015年开源,继承了内部系统DistBelief的架构思想)强调生产部署和大规模分布式训练,其静态计算图设计虽然调试不便,但利于编译器优化和跨平台部署;PyTorch(Meta于2016年发布,源自Lua语言的Torch框架)以其动态计算图(define-by-run)和Pythonic设计赢得了研究社区的青睐,2019年后在学术论文中的使用率超过了TensorFlow。然而,这些框架的便利性是一把双刃剑:它们降低了入门门槛,但也可能让使用者陷入"黑箱调参"的陷阱。当面对梯度爆炸(梯度在深层网络中指数级增长导致参数更新失控)、模式崩塌(mode collapse,生成模型只产出少数几种输出而忽略多样性)或分布漂移(distribution shift,部署环境的数据分布与训练数据不一致)等问题时,只有理解底层数学原理的人才能有效诊断和解决。
当模型不收敛、结果不理想时,缺乏数学直觉的人往往束手无策。而理解了概率论、线性代数和微积分这些基础,才能明白:
-
损失函数为什么这样设计:例如交叉熵损失函数直接来源于信息论中的 KL 散度和最大似然估计,选择它而非均方误差作为分类任务的损失函数,有着深刻的概率论依据。具体而言,Claude Shannon 于1948年在贝尔实验室发表的划时代论文《通信的数学理论》创立了信息论,引入了"信息熵"H(p) = -Σp(x)log p(x) 作为信息量的度量——它等于对分布p的数据进行最优编码所需的最小平均比特数。交叉熵 H(p,q) = -Σp(x)log q(x) 衡量的是用分布q设计的编码方案来编码实际服从分布p的数据所需的平均比特数——由于编码方案并非最优,交叉熵总是大于等于信息熵。KL散度 D_KL(p||q) = H(p,q) - H(p) 则量化了这种"次优性",即两个分布之间的"信息差距"。最小化交叉熵损失等价于最小化模型预测分布与真实分布之间的KL散度(因为H(p)是常数),而这又等价于最大似然估计(MLE)——对数似然 log p(x|θ) 的负值恰好是交叉熵。这条从信息论到概率论再到优化的链条,揭示了为什么交叉熵是分类任务损失函数的"自然"选择,而非某个工程师的任意决定。相比之下,均方误差对应的是高斯噪声假设下的MLE,用于分类任务时会导致梯度在预测置信度高时变得极小(梯度饱和),严重影响训练效率。
-
梯度下降为什么有效:梯度是多元函数在某点增长最快的方向(这是方向导数取极值的结论),沿负梯度方向移动是局部最速下降策略。理解导数的链式法则才能理解反向传播(Backpropagation)算法如何高效计算深度网络中数百万乃至数十亿参数的梯度。反向传播的本质是动态规划——它利用计算图的拓扑结构,从输出层向输入层逐层传播误差信号,每个中间节点只需被计算一次,避免了朴素方法中梯度的重复计算,将时间复杂度从指数级降为与网络参数量成线性的量级。这一算法的核心思想最早可追溯到控制论中的伴随方法(adjoint method),但其在神经网络中的系统化应用由 Rumelhart、Hinton 和 Williams 于1986年在Nature杂志发表的论文中推广,证明了多层网络可以通过梯度学习内部表征——这篇论文直接推动了连接主义的复兴。至今,反向传播仍是所有深度学习训练的基石,而现代自动微分(Automatic Differentiation)系统如JAX中的grad函数,本质上是对反向传播的泛化实现。
-
模型为什么会过拟合,正则化又如何缓解:过拟合本质上是模型复杂度过高导致在训练集上记住了噪声而非规律——用统计学习理论的语言说,假设空间的容量(如VC维或Rademacher复杂度)超过了训练数据所能约束的范围。L2 正则化(也称Ridge回归或权重衰减)在优化目标中添加了参数范数的惩罚项 λ||w||²,在贝叶斯视角下这等价于对参数施加零均值的高斯先验分布 p(w) ∝ exp(-λ||w||²)——参数离零越远,先验概率越低,优化时就会被"拉回"。类似地,L1正则化(Lasso)等价于拉普拉斯先验,倾向于产生稀疏解。这些正则化方法优雅地体现了奥卡姆剃刀原则——在解释数据的同时偏好更简单的模型。从偏差-方差分解(Bias-Variance Decomposition)的角度看,模型的泛化误差 = 偏差² + 方差 + 不可约噪声。过于复杂的模型偏差低但方差高(对训练数据的微小变化极为敏感),正则化通过引入少量偏差来大幅降低方差,从而在偏差-方差权衡中找到更好的平衡点,改善模型的泛化性能。
机器学习的三大数学支柱各司其职又相互交织:概率论与统计学提供了建模不确定性和从数据中推断的工具(贝叶斯推断、假设检验、渐近理论);线性代数是处理高维数据的语言——从 PCA 降维到 Transformer 的注意力机制都依赖矩阵运算和向量空间变换;多元微积分与优化理论则是模型训练的核心引擎(梯度下降、凸优化、拉格朗日对偶)。
以线性代数为例,主成分分析(PCA)通过计算数据协方差矩阵 Σ = (1/n)X^TX 的特征分解 Σ = UΛU^T,找到方差最大的正交方向(即最大特征值对应的特征向量),从而实现降维——其数学本质是在最小化重构误差 ||X - XUU^T||² 意义下的最优线性投影。这个看似简单的矩阵分解背后连接着深刻的几何直觉:特征向量定义了数据"散布"最广的方向,特征值量化了每个方向上的信息量,截断小特征值对应的方向就是在丢弃噪声的同时保留信号。
而在Transformer架构(Vaswani等人2017年提出的"Attention Is All You Need")中,自注意力机制的核心运算 Attention(Q,K,V) = softmax(QK^T/√d_k)V 本质上是查询向量与键向量的内积加权求和——QK^T 计算所有查询-键对之间的相似度(内积越大表示越相关),除以√d_k防止内积值过大导致softmax梯度消失,softmax将相似度转化为归一化的注意力权重,最后对值向量V加权求和得到输出。这是向量空间中相似度计算和线性组合的直接应用,也是"软性信息检索"的数学实现。理解矩阵乘法的几何意义(线性变换——旋转、投影、缩放的复合)和代数意义(行空间与列空间之间的映射),是深入理解现代深度学习架构的必经之路。没有线性代数的直觉,你就无法理解为什么低秩近似(LoRA)能高效微调大模型,为什么注意力头可以学习不同的"子空间"表征。
三者的交织无处不在:概率模型的参数估计归结为优化问题(最大似然→梯度下降),优化的目标函数涉及矩阵运算(Hessian矩阵决定了损失函数的局部曲率),而矩阵的特征分解又揭示了数据的统计结构(协方差矩阵的谱揭示了数据的内在维度)。更深层次地,现代机器学习理论(如神经切线核NTK、信息几何)正在揭示这三者之间更为深刻的统一联系。
数学不是机器学习的装饰,而是它的骨架。这也是这类系统性训练营存在的意义——帮助学习者建立起从"会用"到"理解"的跨越。
结语
从 Tom Mitchell 的经典定义到概率视角的引入,这个免费训练营的第一讲为初学者搭建了一个清晰的认知框架。它提醒我们:机器学习不是玄学,而是一套建立在坚实数学基础之上、用于在不确定世界中做出最优决策的系统方法论。
对于那些同样困惑于"机器学习到底是什么"的人来说,从定义出发、以概率为透镜、以数学为根基的学习路径,无疑是一条值得走的正道。这也是任何免费开放教育资源最有价值的地方——降低理解门槛,让更多人得以窥见 AI 技术的内核。
核心要点
- **Mitchell三要素定义(T-P-E框架)**是理解机器学习本质的最佳起点,它以方法无关的方式统一了分类、回归、强化学习等所有范式
- 概率视角为处理现实世界的不确定性提供了数学上最优的框架,贝叶斯决策理论通过完备类定理保证了其逻辑必然性
- 数学三大支柱(概率论、线性代数、多元微积分)不是可选的装饰而是机器学习的骨架,理解它们才能从"调用API"升级为"诊断和创新"
相关推荐

Cursor AI编程实战:30分钟从零构建学生管理系统
B站UP主实战演示Cursor AI编程:30分钟用自然语言生成学生管理系统。详解Agent模式、Claude模型选择、提示词技巧与使用门槛,帮你判断Cursor是否值得入手。

AI编程工具20强榜单:从夯到拉的评分矩阵
B站UP主发布AI编程工具20强榜单,从夯到拉分为T0-T4五个层级,Claude Code和Codex并列T0。本文详解评分维度(能力、可靠性、耐操性、耐久性、成本、国内可用性)及工具表现,帮助开发者选择适合的AI编程助手。

Vibe Coding系统教程:零基础玩转AI编程实战
B站UP主耗时三个月打造的Vibe Coding系统教程,覆盖Codex、ClaudeCode、Cursor等AI编程工具,从基础逻辑到商业级项目实战三段式讲解,适合零基础学习者系统入门AI编程。