机器学习论文越来越"啰嗦"了吗?一场关于学术写作的讨论

ML论文篇幅急剧膨胀、口语化写作与框图泛滥,正在侵蚀学术研究的严谨性与可复现性。
本文讨论了机器学习学术写作中一个日益显著的现象:论文篇幅从过去的8-12页膨胀至动辄四五十页,与此同时写作风格也在发生质变——口语化表达渗入严肃技术文献,严格数学推导被框图和描述性叙述所取代。这些变化背后有客观原因:顶会页数限制催生附录文化、大模型研究横跨多个子领域、实验对比需要大量基线和消融分析。然而,框图依赖损害了复现性,口语化写作模糊了科学声明与探索性直觉的边界。文章最终指出,篇幅不等于贡献,学术写作的本质是高效传递知识,而非堆砌工作量。
当论文动辄四五十页:ML研究的"水化"焦虑
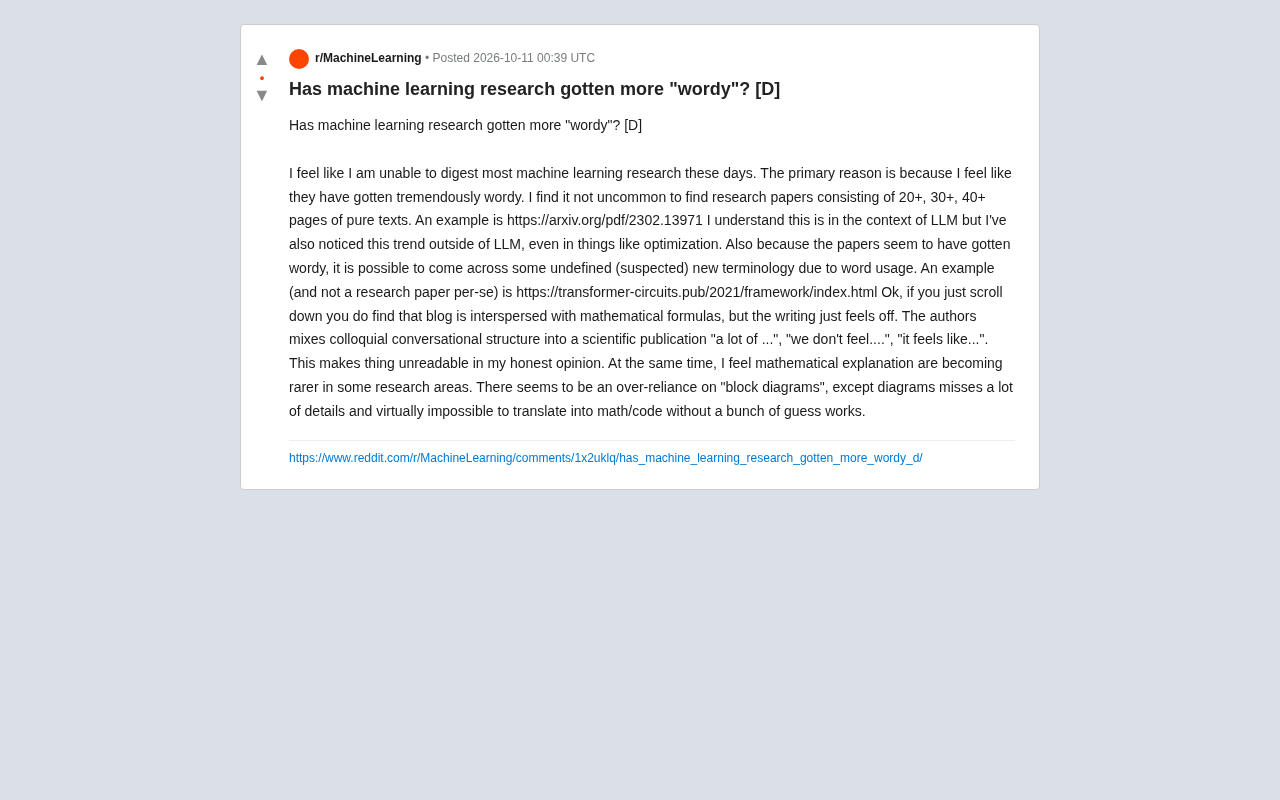
一位研究者在Reddit上抛出了一个引发广泛共鸣的问题:机器学习研究是不是变得越来越"啰嗦"了?他坦言自己越来越难以消化如今的ML论文,核心原因在于论文篇幅的急剧膨胀——动辄20页、30页乃至40页以上的纯文本内容已经不再罕见。
这位发帖者以Meta发布的LLaMA论文(arXiv:2302.13971)为例,指出即便理解大语言模型(LLM)本身需要大量篇幅去描述训练细节、数据集和评估结果,但这种"文字堆砌"的趋势正在蔓延到LLM之外的领域,甚至连优化(optimization)这类传统上高度数学化的方向也未能幸免。
这个话题触及了学术界一个真实的痛点:在论文数量爆炸、页数不断增长的今天,读者获取有效信息的成本正在上升,而非下降。
口语化表达入侵科学写作
发帖者的另一层担忧,是科学写作风格本身的变化。他特别提到了Anthropic的《A Mathematical Framework for Transformer Circuits》这篇颇具影响力的技术博客(transformer-circuits.pub)。虽然文章确实穿插了数学公式,但其写作方式让他感到"不对劲"。
问题出在作者将大量口语化、对话式的表达混入了严肃的技术publication中,诸如"a lot of..."、"we don't feel..."、"it feels like..."这类措辞频繁出现。在这位读者看来,这种风格削弱了内容的严谨性和可读性——科学结论应当建立在可验证的论证之上,而非主观"感觉"。
这背后其实反映了一个更深层的张力:当研究越来越依赖经验性发现和直觉驱动的探索(尤其在可解释性和大模型行为分析领域),作者往往难以给出严格的数学证明,只能用描述性语言表达观察。这既是领域发展阶段的真实写照,也可能是写作训练缺失的结果。
《A Mathematical Framework for Transformer Circuits》(2021)是Anthropic可解释性团队发表的一篇奠基性工作,试图用线性代数的语言解析Transformer内部的注意力机制,提出了"残差流"(residual stream)、"注意力头组合"等概念框架。该文以技术博客而非传统期刊论文的形式发布,这一选择本身就体现了ML领域的发表生态变化——越来越多的重要工作绕过同行评审,直接以预印本(arXiv)或机构博客的方式公开。博客体裁天然允许更具叙事性的写作风格,作者可以自由表达探索过程中的直觉和不确定性,但这也使得文体边界模糊:读者面对的是一篇科学声明,还是一篇思考记录?当这种风格反向渗透到正式学术论文中时,便会产生原帖所描述的不适感。
数学消失,框图泛滥
帖子中最具技术分量的批评,是关于表达方式的退化。发帖者认为,在某些研究领域,严格的数学解释正变得越来越稀少,取而代之的是对"框图"(block diagrams)的过度依赖。
问题在于,框图虽然直观,却天然地遗漏了大量实现细节。想要仅凭一张架构图把一个方法准确地翻译成数学公式或可运行代码,几乎不可能,往往需要大量的猜测和逆向工程。这对于复现研究、验证结论构成了实质性障碍。
这种"图胜于式"的趋势,某种程度上是深度学习工程化的副产品——当模型由模块拼装而成,框图确实是最自然的沟通语言。但对于追求精确性和可复现性的研究者而言,缺乏数学规范和伪代码的论文,等于把复现的负担甩给了读者。
消融实验(ablation study)是现代深度学习论文中验证各组件贡献的标准做法:通过逐一移除或替换模型的某个模块,观察性能变化来量化该组件的必要性。然而,消融实验的可信度高度依赖精确的数学描述——如果论文只提供框图而不给出各模块的形式化定义,读者往往无法判断两篇论文中"相同名称"的组件是否指向同一操作。这正是框图依赖带来的隐性成本:当研究者试图在自己的工作中复现某个消融设置时,模糊的可视化表达会导致实现偏差,进而使跨论文的结果比较失去意义。深度学习领域的可复现性危机(reproducibility crisis)在一定程度上与此密切相关——NeurIPS和ICML等顶会已陆续引入"Reproducibility Checklist"等机制,要求作者明确报告超参数、随机种子和代码实现,正是对这一趋势的制度性回应。
篇幅膨胀的几个结构性原因
抛开写作风格的个人偏好,ML论文变长其实有其客观背景,值得理性看待:
实验负担加重
现代ML论文需要在大量benchmark上进行对比,附带消融实验(ablation)、超参数分析和多种基线对比。仅仅是把这些实验结果和分析讲清楚,就足以占据十几页篇幅。
附录文化的兴起
许多会议对正文页数有限制,于是作者把大量细节塞进附录。一篇"40页论文"中,可能有一半以上是附录中的证明、额外实验和实现细节。从某种意义上说,这反而是透明度提升的表现。
主流ML顶会对正文页数的限制由来已久:NeurIPS和ICML通常规定正文不超过8-9页(不含参考文献),ICLR采用类似惯例。这一规则最初是为了控制审稿负担、保持论文聚焦,但在实践中催生了体量可观的附录——部分论文附录篇幅是正文的两到三倍。更值得注意的是,附录内容通常不在审稿人的强制审阅范围之内,这意味着大量技术细节游离于同行评审之外。从信息完整性的角度看,附录的存在确实优于"细节略去";但当核心假设的证明、关键的数据处理步骤都被挤入附录,读者实际上需要投入远超"8页论文"预期的时间才能形成完整判断,篇幅限制的初衷便已落空。
领域跨度扩大
大模型研究往往横跨数据工程、训练基础设施、评估方法学等多个子领域,每一块都需要交代,自然推高了篇幅。
这到底是进步还是退步?
这场讨论没有标准答案,但它揭示了ML研究社区正在经历的分化。一方面,更长的篇幅、更多的实验细节和附录,确实提升了研究的完整性和可复现性;另一方面,口语化写作和框图依赖,又在一定程度上损害了严谨性和信息密度。
对于读者而言,一个务实的应对策略是:先读摘要和结论,再看核心图表和公式,把冗长的文字叙述作为补充而非主线。而对于写作者,这个帖子的价值在于提醒我们——篇幅不等于贡献,清晰的数学表达和规范的伪代码,往往比成千上万个描述性词汇更有价值。
归根结底,学术写作的目标应该是高效传递知识,而不是展示工作量。当论文越来越像"叙事"而非"论证"时,或许整个社区都该重新审视,我们究竟是在推进科学,还是在增加噪音。
相关推荐

花旗14000名工程师用Devin,技术外包账单砍掉30%
花旗集团14000名工程师使用AI编程智能体Devin,一年内将技术供应商账单削减30%,产品发布提速30-40%。但30%仅限单一成本项,摩根大通同期表示AI收益尚未体现在财报中,揭示企业AI落地的真实分化。

AI写代码,程序员要失业?Devin自主编程真相
Devin等自主AI编程代理正改变软件开发:从Copilot辅助编码到全自动工程代理,程序员角色从写代码转向系统设计与监督。本文分析AI编程对就业、代码安全、初级开发者培养的影响,以及效率悖论下程序员需求的真实走向。

AGENTS.md 实战指南:让编程 Agent 真正好用
AGENTS.md 和 CLAUDE.md 能显著提升编程 Agent 表现,但研究发现用错反而让成本上升 20%。本文详解该写什么、该删什么、200 行与 32KB 的硬边界、Monorepo 嵌套规则及安全提醒。