计算星期几的极致优化:从取模公式到单指令位运算魔法

从取模公式到单指令位运算,揭示「计算星期几」背后的底层优化进化史
本文梳理了计算某天是星期几这一问题的算法演进历程。最朴素的方案是 `(day_count + 4) % 7`,但负数输入会导致结果为负。通用修正版引入两次取模操作,在数据库等高频调用场景中开销过大。Hinnant 算法以一个 if 分支取代第二次取模,利用 epoch 周四起点与偏移值的巧合对齐实现简化。Neri 算法则更进一步,借助二进制补码类型重新解释与「2^32 % 7 = 4 恰好等于周四偏移量」这一数学巧合,将有符号与无符号的边界处理融为一体,最终在特定硬件上可压缩为单条机器指令。文章以此为例,展示了系统级性能工程如何从数学恒等式出发,逐层榨取硬件层面的最后开销。
计算机科学里有两件难事:命名变量,以及计算某一天是星期几。前者是永恒的哲学难题,后者却藏着一段让人惊叹的算法进化史。这篇内容基于一位 YouTube 技术博主对「如何最快计算星期几」的深度讲解,从最朴素的取模公式一路推进到堪称「魔法」的位运算技巧,展示了底层优化的迷人之处。
这类问题看似冷门,实则是数据库日期库、编译器实现中的常见挑战——每一次日期到星期的转换,都可能在海量调用中累积成可观的性能开销。
从最朴素的取模公式说起
问题的起点很直接:距离 epoch(纪元起点)第 57 天是星期几?答案是周五。
最直觉的做法是给每一天编号——周日为 0,周一为 1,一直到周六为 6,然后用 57 % 7 得到结果。但这个算式返回的是 1(周一),显然是错的。我们真正想要的是周五。
问题出在哪?关键在于 epoch 的起始日本身并不是周日,而是周四(编号 4)。于是公式修正为 (day_count + 4) % 7,此时 57 天算出来是 5,也就是周五。看起来大功告成。
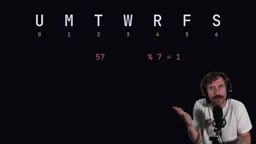
但这个公式有个致命缺陷:一旦引入负数(比如 epoch 之前的日期),结果会变成 -1,而根本不存在编号为 -1 的星期几。朴素公式在负数面前彻底崩溃。
这里的「epoch」在日期计算中通常指 Unix 时间戳的起点:1970 年 1 月 1 日,星期四。这一天被定义为第 0 天,后续日期以整数递增,1970 年之前的日期则用负整数表示。之所以选择周四作为偏移量 4 的来源,完全是历史偶然——Unix 系统的设计者在选定这个纪元时并没有刻意挑选某个特定的星期。然而正是这个「周四起点」,在后续的 Neri 算法中与补码溢出特性意外地完美咬合,成为整条优化链条的关键锚点。
修正负数问题的通用公式
要让公式同时兼容正负数,核心思路是把取模结果统一「搬」到正数区间。
单独做 day_count % 7,结果会落在 -6 到 6 之间——负数输入产生负余数。解决办法是在中间加一个 7,把整个区间平移到正数范围。这里利用了一个巧妙的数学性质:先加 7 再对 7 取模,等价于什么都没做,但它成功地把负值推入了正数世界。
最终的通用公式是:
((day_count % 7) + 7 + 4) % 7
即先取模、加 7、加周四偏移量 4,再对整体取模一次。这个版本对正负数都成立。
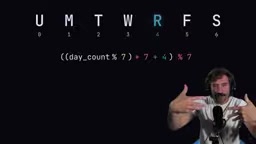
但优化者并不满意——这个公式里有两次取模运算。在数据库这种对性能极度敏感的场景中,取模是相对昂贵的操作,两次更是无法接受。真正的挑战才刚刚开始。
Hinnant 算法:用条件分支替代双取模
视频中提到,一种更高效的算法将双取模拆成了两部分加一个 if 判断。
第一部分很熟悉:对于所有大于等于 -4 的输入,直接使用最初的简化公式即可。因为经过验证,那个公式在从周日一路到周三、周二、周一直到 -4 都能正常工作,只是超过这个边界才失效。
对于小于 -4 的情况,则需要一个专门的公式。它先把值映射到 -6 到 0 之间,再通过 +6 把区间平移到 0 到 6。神奇之处在于公式中的 day_count + 5:当输入 -5 时结果为 0,加 6(周四偏移)后恰好对应正确的星期。这种对齐并非刻意设计,而是因为第一天正好是周四,才让 +6 的平移与真实星期完美吻合。

这种「凑巧对齐」本身就体现了算法优化中常见的美感——数学结构与业务约束意外契合,从而省去了额外的计算步骤。
Neri 算法:位运算的终极魔法
如果说前面的优化还算常规,那么 Neri 算法则将这件事推向了博主口中「令人兴奋到发光」的境界。
要理解它,先得掌握二进制补码(two's complement)。表示一个负数只需两步:把对应正数的每一位取反(0 变 1,1 变 0),然后加 1。以 8 位有符号数为例,-5 就是这样得到的,其最高位为 1 表示负数。
关键的魔法在于类型重新解释。Neri 算法只在特定位宽下成立——U32 和 U8 恰好都符合条件。当你把一个有符号数直接当作无符号数来读:正数保持不变,而负数会发生变化。比如 8 位下的 -5,重新解释为无符号数就是 251,也就是 256 + (-5)。
真正的高潮是这个巧合:256 对 7 取模等于 4——而 4 正是我们的周四偏移量。U32 和 U8 都恰好满足「位宽对 7 取模等于 4」这一条件,使得整个计算能借助无符号溢出的自然行为一步到位。
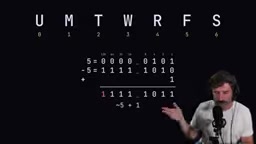
公式中还需要对正数输入额外加 4:因为处理正数时不存在补码重新解释带来的那个偏移,需要手动补上,才能与原始简化公式一致。
博主坦言更复杂的后续部分他没有展开,而是推荐读者去读原始博客文章,其中引用了他心目中最爱的书《Hacker's Delight》——这本书汇集了各种疯狂的位运算技巧和「宇宙中最奇怪的常量」。文章甚至声称:在某些机器上,计算星期几可以浓缩为单条机器指令。
「位宽对 7 取模等于 4」这一条件并非偶然触手可得。U8 的位宽是 8,U32 的位宽是 32,而 8 % 7 = 1、2^8 = 256、256 % 7 = 4;同理 2^32 = 4294967296,4294967296 % 7 = 4。两种类型的「满溢回绕值」恰好都与周四偏移量 4 相等,这才是 Neri 算法能成立的数学根基。U16 的 2^16 = 65536,65536 % 7 = 2,U64 的 2^64 % 7 = 2,均不等于 4,因此这两种位宽下该算法无法直接套用。这种对特定位宽的强依赖也意味着:将算法迁移到不同数据类型时,必须重新验证这个前提,否则计算结果会悄无声息地出错。
为什么这类底层优化值得关注
从 (day + 4) % 7 到单指令位运算,这条优化路径浓缩了系统级性能工程的精髓:识别真正的性能瓶颈(取模操作)、利用数学恒等式重构逻辑、再借助硬件层面的补码溢出特性榨干最后一点开销。
对于日常写业务代码的开发者,可能永远用不到这种极致优化。但它揭示了一个道理——即便是「计算星期几」这样看似琐碎的问题,背后也能延伸出令人惊叹的工程深度。理解这些底层技巧,不仅能帮助编译器和数据库作者写出更快的代码,也能让每一位程序员对「计算的本质」多一层敬畏。
顺带一提:一个 byte 是 8 个 bit,而 4 个 bit 叫做 nibble(小口咬)——因为它是「小一号的 byte」。底层世界的冷幽默,也是它的魅力所在。
《Hacker's Delight》由 Henry S. Warren Jr. 所著,书名直译为「黑客的喜悦」,是位运算与整数算术优化领域的经典参考书。书中系统整理了大量利用二进制补码、溢出行为和魔法常量来替代除法、取模等昂贵操作的技巧。编译器后端(如 GCC、LLVM)在做常量传播和强度消减时,许多变换规则正是源自该书总结的数学恒等式。对于希望深入理解「为什么编译器能把除以 7 优化成乘法加位移」的开发者,这本书是不可多得的第一手资料。
相关推荐

Claude.ai 官方入门指南:提示词、文件、模型与 Research 全解析
Claude.ai 官方入门指南完整解析:如何写好提示词、上传文件补充上下文、选择合适的 Claude 模型(Sonnet 与扩展思考模式),以及用 Research 功能完成系统性调研。帮你快速上手这款 AI 协作工具。

核函数赌博机的通用遗憾下界:接近最优性的理论突破
一篇arXiv论文为核函数赌博机建立了通用的极小极大遗憾下界 Ω(√(Tγ_T/logT)),证明现有上界在对数因子内接近最优,并对Matérn核、γ-指数核等精确确定了Θ(√(Tγ_T))最优尺度。

非可逆锚定朗之万动力学:加速非光滑与重尾分布采样
本文解读arXiv最新研究,提出非可逆锚定朗之万动力学(NALD)与反射版本(NRALD),通过引入环流漂移项打破可逆性,在无需梯度的情况下加速非光滑、重尾及约束域分布的采样,并给出收敛性与方差缩减的理论证明。