基于游程BWT的高效Lempel-Ziv预测

基于RLBWT实现LZP预测器指数级加速,并提出O(1)预测的LZM变体。
本文针对Lempel-Ziv Plurality (LZP)预测器原始实现更新时间高达O(z log^7 n)的问题,提出了一种基于游程编码Burrows-Wheeler变换(RLBWT)的高效在线实现,将更新时间降至O(log z + log log n),实现了指数级提升。同时,作者引入了一种新的变体——Lempel-Ziv Majority (LZM)预测器,它在保持相同错误上界和更新时间的前提下,将预测时间降至O(1)且与字母表大小σ无关。两种预测器均支持在线更新,无需预先知道字母表,适用于流式数据处理。对于已知字母表的情况,还提供了另一种数据结构,每个符号处理时间为O(σ(1+log z/log log n))。这些改进为LZ预测在数据压缩、文本生成等领域的实际应用提供了高效基础。
Lempel-Ziv Plurality (LZP) 是一种利用字符串的Lempel-Ziv分解来预测下一个符号的算法,由Kosoy提出。该算法对于长度为n、具有z个LZ77短语的字符串,最多犯O(z log n)个错误。然而,Kosoy的实现更新时间为O(z log^7 n),在实际应用中可能成为瓶颈。本文介绍了一种基于游程编码Burrows-Wheeler变换(RLBWT)的高效在线实现,将更新时间降至O(log z + log log n),实现了指数级提升。同时,我们引入了一种新的变体——Lempel-Ziv Majority (LZM)预测器,它以O(1)时间进行预测,且与字母表大小σ无关。
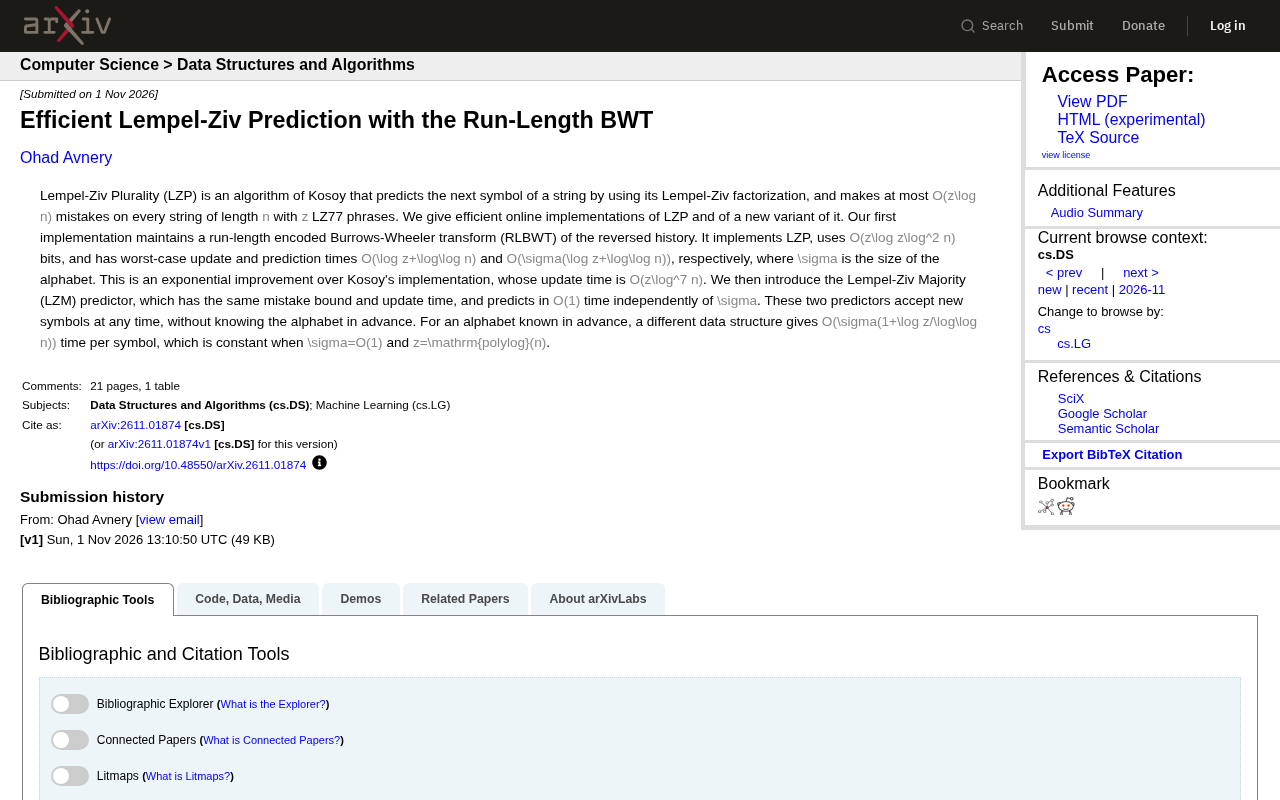
背景:LZP与LZ77分解
LZP的核心思想是通过LZ77分解来捕捉字符串中的重复模式,从而预测下一个符号。LZ77分解将字符串划分为一系列短语,每个短语是之前出现过的子串的引用。LZP利用这些短语的上下文来预测下一个符号,其错误上界为O(z log n),其中z是短语数量。这种预测能力在数据压缩和文本生成等领域具有潜在应用。
然而,Kosoy的原始实现虽然保证了错误上界,但更新时间高达O(z log^7 n),对于长字符串或需要频繁更新的场景效率较低。因此,设计更高效的在线实现成为关键挑战。
LZ77分解是一种无损数据压缩的基础技术,由Lempel和Ziv于1977年提出。它将输入字符串解析为一系列短语(phrase),每个短语要么是单个字符,要么是对之前出现过的子串的引用(通常表示为距离-长度对)。这种分解能够捕捉数据中的重复模式,是许多压缩算法(如DEFLATE、LZ4)的核心。在LZP的上下文中,LZ77短语的数量z直接决定了预测器的错误上界:字符串的重复性越高,z越小,预测错误也越少。因此,LZP的性能与字符串的LZ77分解紧密相关。
基于RLBWT的高效实现
我们提出的第一个实现维护了反转历史的游程编码Burrows-Wheeler变换(RLBWT)。RLBWT是一种压缩数据结构,能够高效表示重复子串。通过在这种结构上操作,我们实现了LZP预测器,其空间占用为O(z log z log^2 n)比特,最坏情况下的更新时间为O(log z + log log n),预测时间为O(σ (log z + log log n)),其中σ是字母表大小。
与Kosoy的实现相比,更新时间从O(z log^7 n)降至O(log z + log log n),这是一个指数级的改进。这意味着即使对于大规模数据,该实现也能保持较高的响应速度。此外,该实现支持在线更新,即可以在任意时刻接受新符号,而无需预先知道字母表。
Burrows-Wheeler变换(BWT) 是一种可逆的字符串变换,通过将字符串的所有循环移位排序并取最后一列,使得相同字符聚集,从而极大地提高压缩率。BWT是bzip2等压缩工具的核心。游程编码(Run-Length Encoding, RLE) 则是一种简单的压缩技术,将连续重复的字符替换为字符及其重复次数。RLBWT 将两者结合:对BWT的结果进行游程编码,从而高效表示高度重复的字符串。RLBWT支持高效的字符串匹配和更新操作,是许多现代压缩索引(如r-index)的基础。在本文中,RLBWT用于维护反转历史,使得LZP预测器能够在线更新,并达到O(log z + log log n)的更新时间。
新变体:Lempel-Ziv Majority预测器
除了LZP,我们还提出了Lempel-Ziv Majority (LZM)预测器。LZM具有与LZP相同的错误上界和更新时间,但预测时间仅为O(1),且独立于字母表大小σ。这一特性使得LZM在处理大字母表时具有显著优势,因为预测时间不随σ增长。
LZM和LZP都支持在线更新,无需预先知道字母表。对于已知字母表的情况,我们提供了另一种数据结构,每个符号的处理时间为O(σ (1 + log z / log log n)),当σ=O(1)且z=polylog(n)时,该时间为常数。这进一步扩展了算法的适用场景。
性能分析与比较
从理论复杂度来看,我们的RLBWT实现将LZP的更新时间从O(z log^7 n)降低到O(log z + log log n),预测时间也从较高水平降至O(σ (log z + log log n))。对于LZM,预测时间更是降至O(1),且与σ无关。这些改进使得算法在实际应用中更加高效。
空间占用方面,RLBWT实现使用O(z log z log^2 n)比特,这与z和n的对数多项式相关,对于压缩性较好的数据,空间效率较高。此外,算法支持在线更新,适用于流式数据处理场景。
需要注意的是,这些复杂度结果是理论最坏情况下的保证,实际性能可能因数据特性而异。但指数级的改进意味着在大多数情况下,新实现将显著快于原实现。
在线更新是指算法在读取输入符号的同时逐步构建数据结构,并能够立即用于预测或查询,而无需等待整个输入处理完毕。这对于流式数据(如实时日志、传感器数据)至关重要。字母表大小σ 是字符串中不同字符的数量,例如ASCII文本的σ=128,而Unicode文本的σ可能很大。预测时间对σ的依赖性直接影响算法在大字母表场景(如自然语言处理或生物序列分析)中的实用性。LZM预测器通过O(1)的预测时间且独立于σ,显著提升了在大字母表下的效率。
应用前景与总结
高效LZP和LZM预测器在数据压缩、文本预测、生物信息学等领域具有应用潜力。例如,在压缩算法中,准确的预测可以提高压缩率;在文本生成中,快速预测可以提升交互体验。在线更新能力使其适用于实时数据流。
总之,通过RLBWT数据结构,我们实现了LZP的指数级加速,并提出了更高效的LZM变体。这些成果为基于LZ分解的预测算法在实际系统中的应用奠定了基础。未来工作可能包括进一步优化实际性能、探索更多变体以及应用于特定领域。
相关推荐

Qwen 3.8编程击败Opus,你的Mac能跑吗?
Qwen 3.8开源模型在编程测试中击败Opus 4.6,仅18GB大小,但你的Mac需要多少内存?实测显示24GB会崩溃,32GB才是甜点区,本文详解各档Mac配置的实际表现与上手方法。

Claude Code + Agent:打造AI全自动测试闭环
B站课程解读:测试开发如何用 Claude Code 终端型 Agent 打造 AI 全自动测试闭环。对比终端型与设备型 Agent 的权限边界,讲清企业级项目为何选 Claude Code 而非 Open Claude 类工具,并梳理 Node.js 环境准备与 DeepSeek 模型搭配的落地路径。

与AI智能体共事,你需要钢铁般的神经
AI智能体越自主,使用者的心理负担反而越重。本文从Hacker News讨论出发,分析智能体协作中的黑箱焦虑、行为漂移与监控疲劳,并给出沙箱隔离、权限控制、任务粒度管理等降低认知负荷的实用思路。