急诊分诊AI评估新框架SAFE-Triage:超越准确率的多维评测

SAFE-Triage框架从三维度四手段评测患者端分诊AI,超越单一准确率指标。
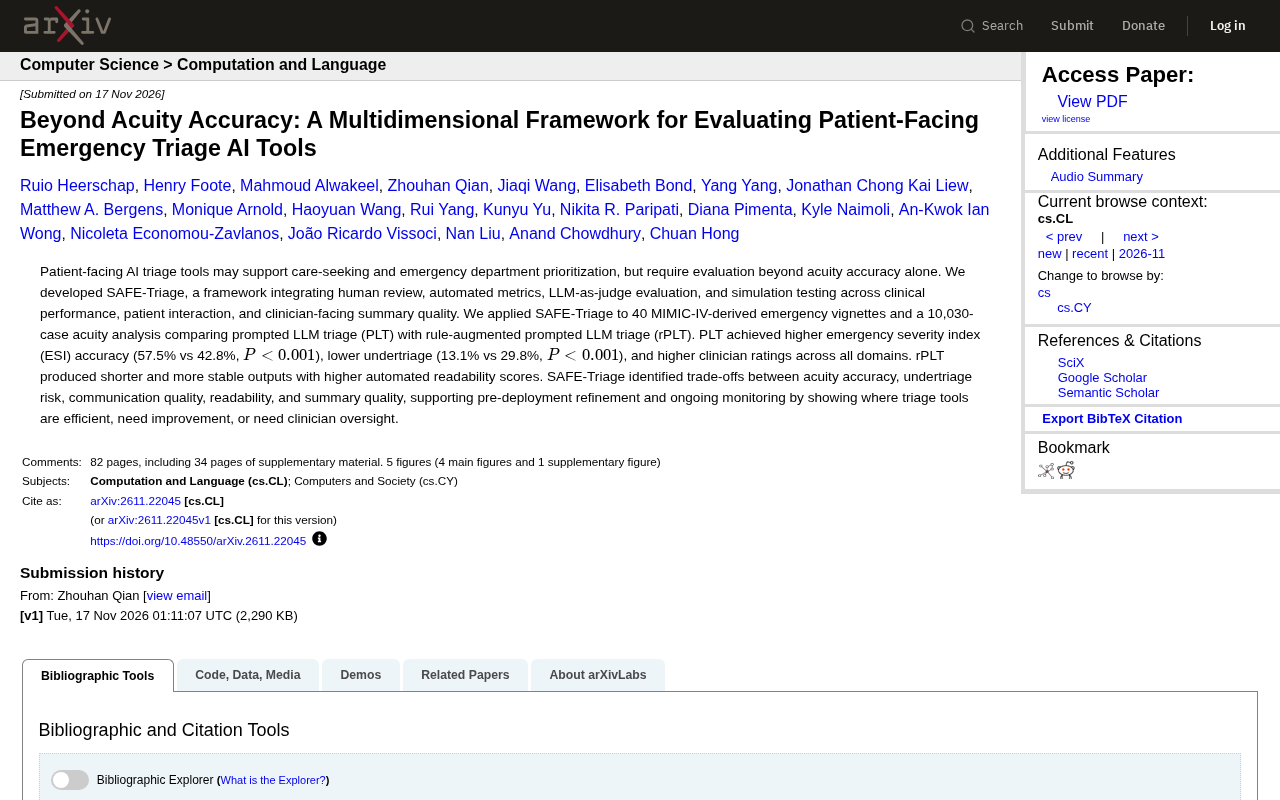
一篇arXiv研究提出SAFE-Triage框架,主张面向患者的AI分诊工具不能仅凭分诊准确率评价,而应从临床性能、患者交互质量和医生摘要质量三个维度综合评测。框架整合人工审核、自动化指标、LLM-as-judge和模拟测试四种手段,应用于40个MIMIC-IV急诊病例vignette及10,030例病情严重度分析。对比实验显示,提示式LLM分诊(PLT)的ESI准确率为57.5%,显著高于规则增强方案(rPLT)的42.8%,undertriage率13.1%也远低于29.8%;但rPLT输出更短、更稳定、可读性更高,揭示了准确性与沟通质量之间的核心权衡。论文将SAFE-Triage定位为支持部署前优化与持续监控的工具。
面向患者的AI分诊工具正在成为缓解急诊压力的潜在手段,但仅凭“分诊准确率”这一项指标来评价它们,可能掩盖更关键的风险。一篇来自arXiv的研究提出了SAFE-Triage框架,试图从临床性能、患者交互和医生摘要质量三个维度重新定义这类工具的评测标准。
为什么准确率不够用
传统分诊AI评测通常聚焦于 acuity accuracy(病情严重度判断准确率),即模型输出的紧急程度与金标准是否一致。但论文指出,面向患者的分诊工具承担着双重角色:一方面要帮助患者判断是否需要就医、何时就医;另一方面要为急诊科提供分诊优先级参考。
这意味着一个“准确”的模型可能在沟通上让患者困惑,或者在医生端生成的摘要遗漏关键信息。论文明确写道,这类工具“需要超越 acuity accuracy 的评估”。SAFE-Triage的出发点正是捕捉这些被单一指标遮蔽的权衡。
Acuity accuracy(病情严重度判断准确率) 是分诊AI评测中最常用的指标,指模型输出的紧急程度等级与金标准(通常由临床专家标注)完全一致的比例。在急诊分诊场景中,紧急程度通常按ESI(Emergency Severity Index)五级量表划分,从1级(需立即抢救)到5级(非紧急)。Acuity accuracy看似直观,但它将所有误判一视同仁——把2级重症误判为4级与把4级轻症误判为5级,在准确率上贡献相同的扣分,但临床后果天差地别。此外,该指标不反映模型输出的沟通质量、可读性或对患者决策的实际影响,因此单独使用会掩盖分诊工具在真实部署中的系统性风险。
SAFE-Triage的四层评测结构
该框架整合了四种评测手段,覆盖三个评估领域:
- 人工审核:由临床人员对模型输出进行质性判断
- 自动化指标:包括ESI准确率、 undertriage 率、可读性分数等
- LLM-as-judge:用大模型作为评判者对输出质量打分
- 模拟测试:基于急诊病例 vignette 的端到端模拟
三个评估领域分别是临床性能、患者交互质量和面向医生的摘要质量。这种分层设计让评测不再停留在“对/错”的二元判断,而是能定位工具在哪个环节表现良好、哪里需要改进、哪里必须引入医生监督。
LLM-as-judge 是一种利用大语言模型作为自动化评判者的评测方法。具体做法是:将待评估的模型输出连同评分标准(rubric)一起提交给一个能力较强的大模型,由它按维度打分或给出质性评价。这种方法成本远低于人工审核,且可批量执行,适合在开发迭代中频繁使用。但其局限也很明显:评判模型自身可能存在偏见、对临床细节的敏感度不足,且评分的一致性依赖于提示设计。因此论文将LLM-as-judge定位为人工审核的补充而非替代,强调临床人员审核仍是框架的必要组成部分。
PLT与rPLT的对比实验
研究团队将SAFE-Triage应用于40个源自MIMIC-IV的急诊病例 vignette,以及一个包含10,030例的病情严重度分析。实验对比了两种方案:提示式LLM分诊(PLT)和规则增强的提示式LLM分诊(rPLT)。
结果显示,PLT在ESI准确率上达到57.5%,高于rPLT的42.8%(P < 0.001); undertriage 率为13.1%,显著低于rPLT的29.8%(P < 0.001)。在临床人员评分中,PLT在所有维度上都获得更高评价。
但rPLT并非全无优势。它的输出更短、更稳定,自动化可读性分数更高。这揭示了一个核心权衡:追求分诊准确性的方案可能在输出简洁性和可读性上做出让步,而规则增强的方案虽然牺牲了一部分准确性,却换来了更一致的表达。
MIMIC-IV 是当前医疗AI研究中最广泛使用的公开重症监护数据库之一,由麻省理工学院与贝斯以色列女执事医疗中心合作维护,包含数万名匿名患者的电子健康记录,涵盖生命体征、检验结果、用药和临床记录等。论文从MIMIC-IV中提取急诊病例并整理成vignette(病例摘要),用于模拟分诊场景。使用MIMIC-IV的好处是数据真实、可复现,便于同行对比;但需注意其数据来自单一医疗系统,病例复杂度和人群分布可能与其它机构存在差异,因此基于该数据集的评测结果外推时需谨慎。
Undertriage(漏判重症) 指模型将本应归为高紧急等级的患者错误地判定为较低等级,导致其分诊优先级被下调。与之相对的是overtriage(过度分诊),即将轻症判为重症。在急诊场景中,undertriage的临床后果通常更严重——患者可能因此延误救治,风险远高于overtriage造成的资源浪费。因此论文将undertriage率作为独立的高优先级指标,而非准确率的附属品。实验中PLT与rPLT在undertriage率上的差距(13.1% vs 29.8%)远大于准确率差距(57.5% vs 42.8%),说明仅看准确率会严重低估两种方案在安全性上的实质差异。
多维评测揭示了什么
SAFE-Triage的价值在于把这种权衡显性化。论文指出,该框架能够识别 acuity accuracy、 undertriage 风险、沟通质量、可读性和摘要质量之间的取舍关系。对于准备部署的分诊工具,这意味着团队可以在上线前明确工具的“效率区间”和“监督区间”——哪些场景可以自动运行,哪些必须由临床人员复核。
这一思路与当前医疗AI评测的趋势一致:单一准确率指标无法反映真实临床环境中的复合风险。面向患者的分诊工具尤其如此,因为它们的输出同时影响患者的就医决策和急诊科的资源分配。
对AI分诊产品开发的启示
从产品角度看,SAFE-Triage提示了几条可操作的评测原则。第一, undertriage (漏判重症)应当作为独立的高优先级指标,而非准确率的附属品——实验中PLT与rPLT在 undertriage 率上的差距远大于准确率差距。第二,可读性和沟通质量需要纳入常规评测,因为患者端的理解成本直接影响工具的实际效用。第三,LLM-as-judge和模拟测试可以作为人工审核的低成本补充,但论文同时强调人工审核仍是框架的组成部分。
论文将SAFE-Triage定位为支持“部署前优化和持续监控”的工具,而非一次性认证。这与医疗AI需要持续监测的监管共识相呼应。对于正在开发患者端分诊AI的团队,该框架提供了一个可参考的多维评测骨架,其核心主张是:分诊工具的优劣不能由单一指标裁决,而应由一组相互牵制的指标共同定义。
相关推荐

Gemini 4 Neon评测:跑分比肩Carbon,API定价与额度解析
Google Gemini 4 Neon正式上线,跑分紧咬Carbon,API定价3/15为Hydrogen两倍。本文汇总B站UP主实测:Neon可平替90% Carbon场景,AntiGravity中额度消耗仅为Carbon三分之一,并解析订阅渠道限制与2API封号风险。

Gemini 4 Helium或将至?Google订阅限制松绑信号
Google团队成员预告发布将继续,社区推测Gemini 4 Helium(Flash Lite)或成下一款模型;订阅封禁争议获回应,产品负责人以「Soon」暗示可能开放限制。本文梳理Gemini动向、OpenAI Coding Agent与风险管理、豆包实时音视频API及算力商业动态。

AI辅助React开发实战:视频应用优化与错误处理
14年经验开发者演示如何用AI辅助优化React视频应用:通过ImageKit将视频从80MB压缩至5MB(约94%),并实现可靠的错误处理与重试机制。包含与AI协作的规划、代码理解和验证方法。