机制可解释性需要一套推理逻辑:从观察神经元到科学解释的五项原则
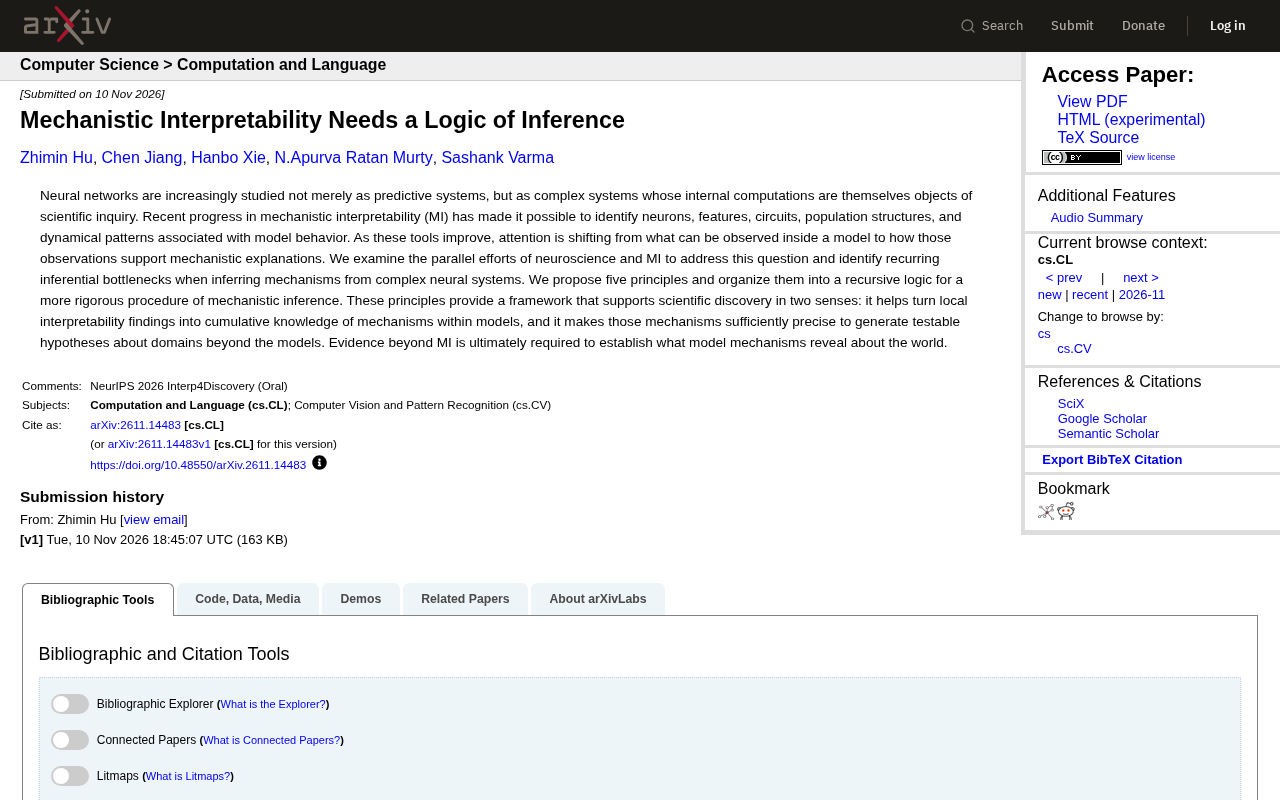
MI需借鉴神经科学的推理逻辑,以五项原则规范机制推断并强调外部证据。
本文介绍了一篇关于机制可解释性(MI)推理逻辑的论文。文章指出,MI正从“能观察到什么”转向“观察如何支撑机制解释”,并面临与神经科学相似的推理瓶颈,如从相关推断因果、从局部推广到全局、以及将模型机制与外部世界关联。为此,论文提出五项原则并组织为递归推断逻辑,强调推断需在神经元、电路、行为等层级间反复验证与修正。该逻辑支持双重目标:累积模型内部机制知识,并生成可检验的外部假设。核心结论是:仅靠MI内部证据不足以确立模型机制对世界的揭示意义,最终需要MI之外的证据来验证假设,研究者应避免将模型机制直接等同于世界真相。
神经网络正日益被视为复杂系统,其内部计算本身成为科学研究的对象。机制可解释性(Mechanistic Interpretability, MI)的进展让我们能够识别与模型行为相关的神经元、特征、电路、群体结构和动力学模式。随着工具改进,关注点正从模型内部能观察到什么,转向这些观察如何支撑机制解释。一篇来自rss的论文《Mechanistic Interpretability Needs a Logic of Inference》指出,神经科学和MI在从复杂神经系统中推断机制时面临相似的推理瓶颈,并提出了五项原则,组织成递归逻辑,以构建更严谨的机制推断流程。
从观察到解释:MI的推理瓶颈
MI的目标不止于预测,而是理解模型内部的因果机制。研究者已经能够定位特定神经元或电路,但如何从这些局部观察中得出可靠的机制解释,仍缺乏系统方法论。论文识别出反复出现的推理瓶颈:例如,从相关性观察推断因果机制、从局部电路推广到全局行为、以及将模型机制与外部世界知识关联。这些问题与神经科学中从神经元活动推断认知机制的挑战高度相似,暗示两个领域可以相互借鉴。
机制可解释性(MI)与神经科学共享一个根本性的方法论难题:从可测量的低层信号(神经元激活、权重矩阵、注意力模式)推断出高层因果机制,本质上是一个逆问题(inverse problem),即从观测数据反推生成数据的潜在因果结构。该问题具有病态性(ill-posedness):多组不同的机制假设可能产生相同的观测,仅凭模型内部的激活数据难以唯一确定真因。神经科学中的经典案例——从单个神经元的放电率推断其编码的认知变量——已经表明,这种推断需要借助干预实验、跨条件对照与理论先验来约束假设空间。MI研究者面临同样的困境:定位某个注意力头或MLP神经元与某行为的相关性,并不等于证明该组件是该行为的因果驱动因素。因此,论文指出的推理瓶颈并非MI独有的技术缺陷,而是复杂系统机制推断的普遍认识论难题,这也解释了为何两领域的方法论可以相互迁移。
文中提到的“从局部电路推广到全局行为”涉及MI中的尺度问题(scale problem)。MI研究通常在细粒度层级(单个神经元、注意力头、小规模电路)上定位可解释结构,但模型行为往往由大量组件的分布式交互涌现(emergence)产生。局部电路在孤立条件下表现出的功能,在完整网络中可能因冗余、补偿或上下文依赖而被改变。这与神经科学中从单个皮层柱或局部回路推断整体认知功能的困难异曲同工。解决尺度问题需要明确不同分析层级之间的映射关系,例如通过消融(ablation)、激活修补(activation patching)或因果追踪(causal tracing)等手段,验证局部发现在全模型行为中的稳健性,而非默认局部机制可无损推广至全局。
五项原则构建递归逻辑
针对上述瓶颈,作者提出五项原则,并组织成一个递归的推断逻辑。这些原则旨在为机制推断提供更严谨的流程,帮助研究者评估证据强度、避免过度解读。递归意味着推断过程不是线性的,而是需要在不同层级(如神经元、电路、行为)之间反复验证和修正。论文强调,这种逻辑能支持科学发现的双重目标:一是将局部可解释性发现累积为模型内部机制的累积知识;二是使机制足够精确,从而生成关于模型之外领域的可检验假设。
“递归逻辑”在此处的含义值得展开:它借鉴了科学哲学中关于溯因推理(abductive reasoning)与假设-检验循环的思想。与线性归纳不同,递归逻辑要求研究者在“观察→假设→干预验证→修正假设”的闭环中反复迭代,且每一层的结论都要向上、向下两个方向接受检验——既需与更细粒度的机制证据一致,也需与更高层的行为证据吻合。这种结构在神经科学中体现为从单细胞记录到群体解码再到行为实验的多层级验证链。递归性的另一层含义是:对机制的每一次解释本身都可能成为下一轮推断的观察对象,研究者需持续评估解释的置信度而非一次性锁定结论,从而避免过度解读单一层级的证据。
超越MI的证据:机制揭示世界的局限
论文的一个核心观点是:仅靠MI内部的证据不足以确立模型机制对世界的揭示意义。最终需要MI之外的证据来验证假设。换言之,即使我们完全理解了模型内部的某个电路,也需要外部实验或理论来确认该机制是否对应现实世界的因果结构。这一立场提醒研究者避免将模型机制直接等同于世界真相,而应将其视为需要进一步检验的假设来源。
“需要MI之外的证据”这一主张触及模型-世界关系(model-world relation)的认识论问题。MI能够揭示模型内部的计算结构,但模型机制是否对应外部世界的真实因果结构,取决于模型训练数据与目标的外部效度(external validity)。一个电路即便在模型内部被完整刻画,也可能只是拟合了训练分布中的虚假相关(spurious correlation),而非捕捉了现实世界的因果机制。验证这种对应关系需要独立于模型的证据来源,例如在真实环境中进行干预实验、与领域理论对照,或检验机制所生成的假设在模型外的可复现性。这与科学哲学中“理论须经受独立检验”的原则一致,也提示MI的解释应被定位为可检验假设的生成器,而非关于世界真相的最终裁决。
对MI研究的启示
这项工作的价值在于将科学哲学中的推理逻辑引入MI实践。对于MI研究者,五项原则提供了评估解释质量的框架;对于跨学科研究者,它架起了神经科学与MI之间的方法桥梁。随着MI工具日益强大,建立严谨的推理逻辑将成为将观察转化为可靠知识的关键一步。
相关推荐

智能体与工作流:LangGraph 工作流编排的核心概念解析
基于B站老肖的LangGraph教程,解析工作流与智能体的本质区别:编排权归属、复杂业务选型、StateGraph三大组件及构建流程,帮助开发者合理选择架构方案。
LangGraph工作流与智能体:企业级AI编排新解
LangGraph工作流与智能体的核心区别是什么?本文解析状态图三要素(状态、节点、边),探讨工作流如何编排复杂AI业务,以及LangChain 1.0企业级应用中的协同策略。

4个习惯正在偷走你的Claude Code额度(附诊断提示词)
Claude Code额度消耗过快?本文拆解4个常见烧额度习惯:模糊需求、冗长日志、随意开子代理、长会话不切换。附一个能扫描最近七天日志、自动找出你个人耗电前三名的提示词,并给出针对性修正规则。