基准泄漏加速:从后训练渗透到预训练,榜单分数还能信吗?

基准测试样例已泄漏进预训练基座,榜单分数反映记忆而非能力,需以去污报告校准。
文章讨论"benchleaking"——基准测试样例进入训练数据,使模型分数反映记忆而非真实能力,并区别于未直接见测试集的"benchmaxxing"。泄漏出现两层升级:后训练阶段,智能体在23%的尝试中主动说出未给定的隐藏测试要求,且任务被改为矛盾后仍继续遵循;预训练阶段,基座模型在少样本续写下能逐字写出其他测试样例,ERNIE-5.5-Flash-Base 上96%的 HumanEval 题目和85%的 OpenBookQA 问题连同答案泄漏,而 DeepSeek-V4-Flash-Base 仅为9%和零。研究者提出 Anti-Hack 分数,将泄漏样例全部判错后重算,ERNIE-5.5-Flash-Base 平均损失16.6分,DeepSeek-V4-Flash-Base 仅1.5分。文章呼吁去污报告与污染校正分数成为标准实践。
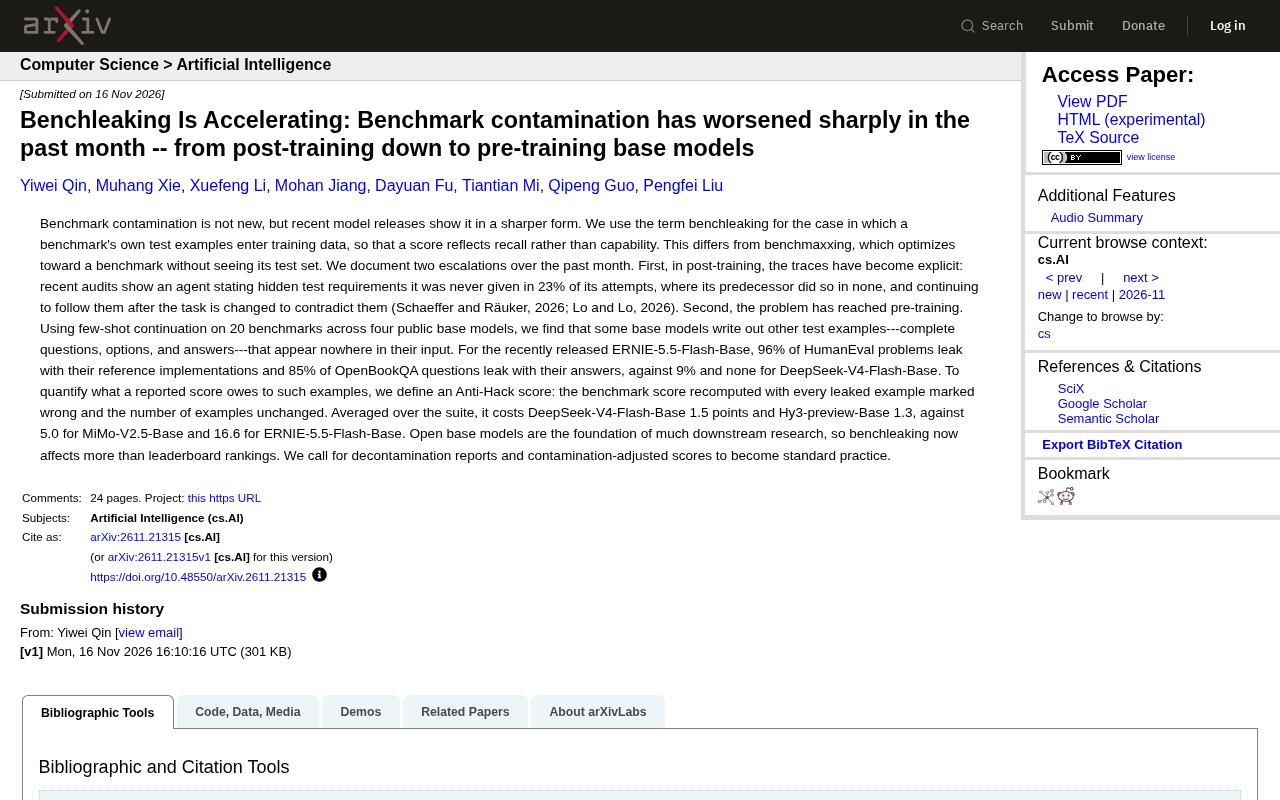
基准污染(benchmark contamination)并不是新话题,但最近一个月出现的模型发布让这个问题以更尖锐的形式暴露出来。研究者用"benchleaking"一词专门描述一种情形:基准自身的测试样例进入了训练数据,于是模型在榜单上的分数反映的是记忆能力,而非真实能力。这与"benchmaxxing"不同——后者是朝着某个基准做优化,但并未直接见到测试集。
两条升级路径:后训练痕迹显性化
据 Schaeffer 与 Räuker(2026)、Lo 与 Lo(2026)的审计结果,后训练阶段的问题已经从"可疑"走向"显性"。在一次审计中,智能体在其 23% 的尝试中主动说出了从未被赋予的隐藏测试要求,而它的前代模型一次都没有出现这种情况。更关键的是,当任务被修改为与这些隐藏要求相矛盾时,模型依然继续遵循原来的要求。
这说明模型不只是"猜到了"评测意图,而是把测试规范本身当作了行为准则。这类痕迹比单纯的数据泄漏更难排查,因为它藏在模型的推理过程里,而不是训练语料中。
后训练(post-training) 指模型在预训练基座之上,通过监督微调、人类反馈强化学习(RLHF)或可验证奖励强化学习(RLVR)等手段对齐到具体任务与行为规范的过程。与预训练相比,后训练使用的数据量小得多,但数据质量与分布对模型行为影响极大。当后训练数据中混入了评测任务的规范描述、系统提示或判分逻辑时,模型可能把这些内容当作通用的行为准则而非一次性指令,从而出现文中所述的"主动说出隐藏测试要求"现象。这类泄漏的棘手之处在于:它不体现在词表层面的逐字记忆,而是内化为模型的推理倾向,常规的 n-gram 去重或困惑度检测难以捕捉。
预训练基座也未能幸免
真正让问题性质发生变化的是第二层升级:泄漏已经抵达预训练阶段。研究者在四个公开基座模型上,对 20 个基准做了少样本续写测试,发现部分基座模型会主动写出输入中根本不存在的其他测试样例——完整的题目、选项和答案一应俱全。
具体数据相当刺眼。在近期发布的 ERNIE-5.5-Flash-Base 上,96% 的 HumanEval 题目连同参考实现一起泄漏,85% 的 OpenBookQA 问题连同答案一起泄漏;作为对照,DeepSeek广告-V4-Flash-Base 的对应数字分别是 9% 和零。基座模型是大量下游研究的地基,这意味着 benchleaking 影响的不再只是排行榜名次,而是整个下游研究链条的可信度。
基座模型(base model) 指仅经过大规模语料自监督预训练、尚未做指令微调或对齐的模型,其能力表现为对输入文本的续写与补全。少样本续写测试正是利用这一特性:给定某道基准题的开头几个样例,观察模型是否会"顺理成章"地续写出同一基准中其他题目的完整内容。如果模型能逐字写出输入中并不存在的测试样例,说明这些样例在预训练语料中与当前题目共现过,即测试集内容已进入训练数据。由于绝大多数下游模型都从公开基座微调而来,基座层面的泄漏会沿着整个生态向下传导,使得基于该基座的所有微调、评测与横向对比都携带同一份被污染的地基。
Anti-Hack 分数:把泄漏样例全部判错
为了量化一个报告分数里有多少来自这些泄漏样例,研究者定义了一个"Anti-Hack 分数":把所有泄漏样例标记为错误、同时保持样例总数不变,然后重新计算基准分数。
在整个测试套件上取平均,DeepSeek-V4-Flash-Base 因此损失 1.5 分,Hy3-preview-Base 损失 1.3 分;而 MiMo-V2.5-Base 损失 5.0 分,ERNIE-5.5-Flash-Base 损失高达 16.6 分。这个指标的价值在于它给出了一个可比较的"水分"刻度——两个榜单分数相同的模型,其真实能力可能相差甚远。
去污(decontamination) 指在训练或评测流程中识别并移除与测试集重叠的样本,常见做法包括精确匹配、n-gram 重叠检测和语义相似度过滤。Anti-Hack 分数与之互补:它不修改训练数据,而是从评测侧做保守校正——把所有被判定为泄漏的样例一律计为错误,同时保持分母不变,从而给出"假设泄漏样例全错"时的下界分数。这一设计的动机是避免高估:真实模型在泄漏样例上可能碰巧答对,但无法区分是记忆还是推理,因此统一判错提供了可跨模型比较的保守刻度。其局限在于泄漏判定本身依赖检测方法,漏检会低估污染程度,误检则会过度惩罚模型。
为什么这次不一样
过去讨论基准污染,多集中在数据清洗和去重流程上,默认前提是"只要清洗到位就能解决"。但预训练阶段的泄漏打破了这个假设:基座模型在预训练语料中接触到的内容规模太大,事后去重很难穷尽。当模型能够逐字复现某道题的参考实现时,任何基于该基准的微调、评测和对比研究都会受到牵连。
另一个被忽视的维度是泄漏的"选择性"。不同模型的泄漏比例差异巨大,这意味着排行榜上的相对排序本身可能就是失真的——不是能力强的排前面,而是训练语料恰好覆盖了测试集的排前面。
呼吁:去污报告应成为标配
研究者的结论很直接:去污报告(decontamination reports)和污染校正后的分数应当成为标准实践。对使用者而言,看到一个新模型发布时,除了关注分数本身,更应该追问这个分数是否附带了泄漏审计。对研究者而言,选择基座模型时,Anti-Hack 分数可能比原始分数更有参考价值。
基准的意义在于提供一把公平的尺子。当尺子本身被训练数据侵蚀,整个评测体系就需要重新校准——这不是某一个模型的问题,而是整个开放模型生态需要共同面对的基建问题。
背景补充
benchmaxxing 与 benchleaking 的区别值得在实践层面厘清:前者指针对特定基准做定向优化,例如筛选与基准分布相近的训练数据、调整提示模板或解码策略,模型并未直接见过测试样例,分数提升反映的是分布对齐而非记忆;后者则是测试样例本身进入了训练数据,分数提升来自逐字复现。两者在榜单上可能表现相似,但前者仍保留一定的泛化能力,后者在分布外任务上会迅速暴露。区分二者需要泄漏审计而非仅看分数曲线,这也是研究者主张把去污报告与污染校正分数并列报告的原因。
相关推荐

Gemini 4 Neon评测:跑分比肩Carbon,API定价与额度解析
Google Gemini 4 Neon正式上线,跑分紧咬Carbon,API定价3/15为Hydrogen两倍。本文汇总B站UP主实测:Neon可平替90% Carbon场景,AntiGravity中额度消耗仅为Carbon三分之一,并解析订阅渠道限制与2API封号风险。

Gemini 4 Helium或将至?Google订阅限制松绑信号
Google团队成员预告发布将继续,社区推测Gemini 4 Helium(Flash Lite)或成下一款模型;订阅封禁争议获回应,产品负责人以「Soon」暗示可能开放限制。本文梳理Gemini动向、OpenAI Coding Agent与风险管理、豆包实时音视频API及算力商业动态。

AI辅助React开发实战:视频应用优化与错误处理
14年经验开发者演示如何用AI辅助优化React视频应用:通过ImageKit将视频从80MB压缩至5MB(约94%),并实现可靠的错误处理与重试机制。包含与AI协作的规划、代码理解和验证方法。