加数据前,先检查你的标注规则是否稳定

在计算机视觉(CV)项目中,一个常见的场景是:模型性能陷入停滞,团队的第一反应往往是「再加点数据」或「换个模型试试」。这些做法有时确实奏效,但很多时候,问题的根源被彻底忽略了——你的模型正在被要求学习一条连人类都没有达成共识的规则。
本文基于一位来自 Supervisely(计算机视觉平台)从业者在 Reddit 上分享的实战观察,探讨一个被严重低估的问题:标注规则的稳定性,往往比数据量更能决定模型的上限。
为什么盲目加数据会放大问题
很多团队默认「数据越多越好」,但这个假设有一个隐含前提:数据的标注是一致的。
这个隐含前提的学术表述是:训练数据应满足独立同分布(i.i.d.)假设,且标注函数应是确定性的。在理想情况下,同一输入对应唯一的正确输出。但在实际的视觉标注中,许多场景的「正确答案」本质上是一个分布而非单点——不同标注员对同一图像的合理标注形成了一个概率分布,而非收敛于一个确定值。当这个分布的方差过大时,模型实际上是在尝试学习一个「平均答案」,而这个平均值可能不对应任何一种真实的合理标注。
现实中,大量困难样本的「正确答案」本身就是模糊的。比如:
- 部分可见的物体:只露出一半的车、被遮挡的行人,到底该不该标?
- 不确定的边界:物体与背景交界处模糊,边界框画到哪里算对?
- 被画面裁切的目标:出现在图像边缘、只剩一角的物体,是否算作一个实例?
对于这些情况,两个标注员完全可能给出不同却都「说得通」的答案。当这种不一致存在时,增加更多数据只是在成倍放大这种混乱。模型接收到的是自相矛盾的监督信号,性能自然难以提升——你喂的数据越多,噪声越大。
标注不一致如何在模型内部制造混乱
要理解这个问题的严重性,需要回到监督学习的基本原理。在训练过程中,模型通过最小化预测值与标注值(ground truth)之间的损失函数来更新参数。当同一类型的样本存在相互矛盾的标注时,损失函数本质上在对模型施加相反方向的梯度力——模型被同时拉向两个不同的方向,导致在这类样本上的权重更新相互抵消。
具体来说,在目标检测任务中,这种矛盾会同时影响两个学习目标:分类分支和回归分支。当一个被遮挡50%的行人在一些图像中被标注、在另一些中被忽略时,分类分支接收到矛盾的正负样本信号;当边界框的精确位置在不同标注员之间差异较大时,回归分支的L1或Smooth L1损失会指向不一致的优化方向。在特征空间中,这意味着网络为这些边界情况分配的特征表示会变得模糊——它们既不完全像正样本,也不完全像负样本,导致决策边界在这个区域变得不稳定。
这在学术界被称为"标签噪声"(label noise)问题。2017年Zhang等人的经典论文《Understanding Deep Learning Requires Rethinking Generalization》证明,深度网络有能力完美记忆完全随机的标签,这意味着网络会花费大量参数容量去拟合噪声标注,而非提取有意义的视觉特征。研究表明,即使 5%-10% 的标签噪声就能使模型在边界样本上的准确率显著下降,而深度神经网络由于其强大的记忆能力,甚至会尝试记住这些矛盾的标注,导致过拟合噪声而非学习真正的模式。
近年来,学术界为应对标签噪声提出了多种方法,包括:使用置信学习(confident learning)自动识别可能错误的标注、设计对噪声鲁棒的损失函数(如对称交叉熵、广义交叉熵)、以及通过课程学习(curriculum learning)让模型先从干净样本中学习再逐步引入噪声样本。然而,这些方法本质上是在"适应"噪声,而非"消除"噪声——从源头提高标注一致性仍然是最根本的解决方案。
换句话说,模型并非「学不会」,而是在一个不可能完成的任务中耗尽了容量。
一个低成本的标注一致性检查方法
原作者提出了一个非常实用、几乎零成本的验证流程,核心思想是:先诊断规则,再扩大规模。
这个流程在方法论上属于数据中心AI(Data-Centric AI)范式的实践。与传统的模型中心AI(Model-Centric AI)专注于改进算法和架构不同,数据中心AI由Andrew Ng等人在2021年前后大力倡导,其核心理念是:在模型架构已经足够成熟的今天,系统性地改善数据质量往往比改进模型本身更能提升最终性能。该范式的一个关键洞察是——对于大多数工业应用,模型的选择空间相对有限(通常在几个主流架构中选择),而数据的改善空间几乎是无限的。
第一步:双人独立标注困难样本
从数据集中挑选 20–30 张困难图像(注意不是随机样本,而是那些边界情况多、容易产生歧义的样本),让两名标注员独立完成标注。
选择困难样本而非随机样本,这一点至关重要。在统计学中,如果你随机抽样检查一致性,由于大部分样本是「简单」的(如画面中央、完全可见、轮廓清晰的物体),你会得到一个虚高的一致率,掩盖了真正有问题的区域。这就像一个考试只出简单题——所有人都能得90分以上,但你无法区分出谁真正掌握了知识。刻意选择困难样本进行一致性测试,本质上是一种压力测试,目的是暴露标注规则中的模糊地带。
第二步:审查分歧,而非只看一致率
这是关键区别。大多数团队只关心「一致性得分」这个数字,看到 90% 就满意了。但真正有价值的信息藏在那 10% 的分歧里。
不要只看你们同意了什么,要认真研究你们为什么不同意。
在标注质量研究中,衡量标注员一致性的经典指标包括 Cohen's Kappa 系数(双人场景)和 Fleiss' Kappa(多人场景)。Cohen's Kappa的计算公式为 κ = (Po - Pe) / (1 - Pe),其中Po是实际观察到的一致率,Pe是在假设两人完全独立随机标注时的期望一致率。这个指标的精妙之处在于,它排除了纯粹由于偶然因素导致的一致——例如在二分类任务中,即使两个人完全随机标注,仍有50%的概率"碰巧一致",简单一致率无法反映这一点。在分类不平衡的场景下,这一问题尤为突出:若99%的区域是背景,两人只要都倾向于标"背景",就能获得极高的简单一致率,但这并不能证明他们在正样本的标注上达成了共识。
对于目标检测任务,常用的衡量方式是计算不同标注员标注框之间的 IoU(Intersection over Union),通常以 0.5 或 0.75 作为阈值判断两个标注是否"一致"。IoU = 0.5意味着两个框的重叠面积至少占两者总覆盖面积的50%,这是一个相对宽松的标准;而IoU = 0.75则要求更精确的对齐,适用于对定位精度要求较高的应用场景(如自动驾驶中的行人检测)。除了框级别的IoU,还需要考虑匹配策略:当标注员A标了3个物体、标注员B标了4个物体时,如何将它们配对?通常采用匈牙利算法进行最优匹配,剩余未匹配的标注则被计为分歧。
但正如前文所述,单纯看数值可能掩盖问题——整体 90% 的一致率背后,可能特定类别或特定场景的一致率低至 50%,这些局部问题才是模型性能瓶颈的真正来源。
每一个反复出现的分歧,都应该被转化为一条成文规则,并配上一个正面示例和一个反面示例(各一张可视化图片)。这样,模糊的口头约定就变成了可执行、可复现的标注标准。
第三步:换新样本重新测试
规则写好后,不要立刻开始大规模标注。而是拿一批全新的样本再跑一遍同样的双人测试,验证新规则是否真的消除了分歧。只有当规则被证明稳定后,才值得投入资源扩大数据规模。
这个验证步骤对应软件工程中的回归测试思想:每次修改规则后,需要确认修改不仅解决了已知问题,而且没有引入新的歧义。在实践中,建议保存每次双人测试的原始标注结果,形成一个可追溯的「一致性测试历史」。这不仅帮助追踪规则的演进,也为后续新加入的标注员提供了一套现成的校准材料——他们可以先独立标注这些历史测试样本,再与已有的参考标注对比,快速发现自己对规则的理解偏差。
自动标注同样需要这套逻辑
随着自动标注(auto-labeling)和预标注工具的普及,很多团队用推理速度来衡量工具好坏。但原作者提醒,评估自动标注的指标应该换一换:
- 漏检的物体数量(missed objects)
- 每张图像的人工修正时间(correction time per image)
而不是只看推理速度。
这个观点直击痛点:如果预标注速度飞快,但每张图仍然需要人工全面复核,那么这份「快」毫无意义。一个高速却低质的自动标注,反而可能因为诱导标注员偷懒(直接接受错误的预标注)而引入新的不一致。
从工程经济学的角度看,标注流程的效率应该用端到端时间(从原始图像到最终验收的总时间)来衡量,而非任何单一环节的速度。一个生成速度为每张0.1秒但需要每张30秒修正的预标注系统,实际效率(30.1秒/张)可能还不如一个生成速度为每张2秒但只需5秒修正的系统(7秒/张)。真正衡量自动标注价值的公式是:节省时间 = 从零标注的时间 - (预标注生成时间 + 人工修正时间),只有当这个值显著为正时,自动标注才真正创造了价值。
预标注中的锚定效应陷阱
自动标注流程通常指使用预训练模型或已有模型对新数据进行初步推理,生成候选标注后由人工审核修正。常见的技术方案包括:使用在COCO等大规模数据集上预训练的通用检测器(如YOLOv8、DINO)进行初始推理;使用项目早期版本的模型对新采集数据进行推理;或使用SAM(Segment Anything Model)等基础模型生成分割掩码后转换为标注。这种"预标注+人工校验"的方式在工业界被广泛采用,因为它能将标注效率提升2-5倍。
但它引入了一个来自认知心理学的隐患——锚定效应(anchoring effect)。锚定效应最早由Nobel经济学奖得主Daniel Kahneman和Amos Tversky在1974年的研究中系统描述,他们发现人在做数值估计时,会不自觉地以最先接触到的数字为锚点进行调整,即使这个锚点完全随机、与问题毫无关系。在标注场景中,预标注的边界框就是这样一个强力锚点。
当标注员看到已有的预标注结果时,他们的判断会不自觉地被这个"锚点"牵引,倾向于接受而非推翻它,即使预标注存在微小错误。心理学研究表明,推翻一个已有判断所需的认知努力远大于接受它——这不是懒惰,而是人类认知系统的固有特性。在标注工作这种高重复性、高疲劳度的任务中,这种效应被进一步放大:标注员平均每天需要处理数百到数千个标注框,注意力资源有限,对每个预标注框进行深度审视是不现实的。
这意味着低质量的预标注不是"中性"的——它会系统性地将标注员的判断拉向错误方向,产生一种隐蔽的偏差,比完全从零开始标注更难察觉和修正。更糟糕的是,这种偏差具有一致性:当所有标注员都受同一个模型预标注的锚定影响时,他们之间的"一致率"可能很高,但这种一致是人人都犯了同样的错误——这在标准的一致性检查中是检测不出来的。
因此,真正有价值的自动标注,是能实实在在减少人工工作量、且不牺牲质量的那种——它的质量必须高到让"接受默认值"在多数情况下是正确的选择。一个实用的验证方法是:随机抽取一批图像,让标注员在不看预标注的情况下从零标注,然后将结果与预标注辅助下的标注进行对比。如果两者之间存在系统性差异,就说明锚定效应正在影响标注质量。
对 CV 项目团队的实践启示
这条观察虽然来自平台从业者,但作者强调这是一个与具体平台无关的通用经验。它给团队的几点启示是:
第一,性能停滞时先怀疑标注,而非模型。 在增加数据或更换架构之前,花半天时间做一次双人一致性测试,成本极低,回报可能极高。
在实践中,一个快速判断标注问题是否为瓶颈的方法是:观察模型的训练损失和验证损失的关系。如果训练损失可以降到很低但验证损失很高(过拟合),可能意味着模型在记忆噪声标注;如果训练损失本身就难以下降,且在特定类别或场景上的损失异常波动,更可能意味着标注内部存在矛盾。另一个信号是:如果增加数据量后模型性能不升反降,这几乎可以确定是标注不一致的问题——新增的矛盾信号抵消了更多数据带来的统计优势。
第二,标注规则应当是文档化、可视化的资产。 口头约定和「凭感觉」会随着团队扩张而崩溃。把每个边界情况写成带正反例的规则,是数据工程中最容易被忽视的基础设施。
以知名数据集的实践为参考:COCO 数据集的标注指南长达数十页,对每种物体类别的边界情况都有明确定义;Waymo Open Dataset的标注规范规定了超过20种遮挡等级的处理方式;nuScenes数据集为3D标注定义了可见性分级(0-40%、40-60%、60-80%、80-100%)。这些规范的共同特点是:不回避模糊情况,而是为模糊情况制定明确的决策树。例如,「当物体被遮挡超过75%且无法确认类别时,不标注」比「被严重遮挡的物体可以不标」更具可执行性——前者提供了明确的判断阈值,后者将「严重」的定义权留给了每个标注员的主观判断。
工业级标注团队通常维护一个"边界案例库"(edge case library),将每次发现的歧义情况归档为规则。这些规则的格式通常包括:触发条件描述、正确标注示例(正例)、常见错误标注示例(反例)、以及规则背后的业务逻辑解释。最后一点尤为重要——当标注员理解「为什么」要这样标(例如,「被遮挡超过75%的物体不标注,是因为下游的追踪模块对这类检测无法做出有效关联」),他们更容易在遇到新的未覆盖情况时做出符合整体意图的判断。随着团队规模扩大或标注人员更替,这份文档就成为保证数据一致性的核心基础设施,其重要性堪比代码库中的编码规范。
第三,用正确的指标评估工具。 无论是人工标注还是自动标注,评估标准都应围绕「最终数据质量」和「实际节省的人力」,而不是表面上的速度或一致率数字。
在工具评估中,建议建立一个标准化的基准测试集(benchmark set):选取50-100张覆盖各类困难场景的图像,由资深标注员创建"黄金标准"标注,然后用这个标准来衡量不同工具或流程的实际效果。关键指标应包括:与黄金标准的mAP差异、人工修正到黄金标准所需的平均时间、以及特定困难类别上的召回率。这种基于结果的评估方式,比任何营销数据都更能帮助团队做出正确的工具选择。
结语
数据质量是模型性能的天花板,而标注规则的稳定性又是数据质量的天花板。在追求更大数据集、更强模型之前,退一步问自己:我们真的知道什么是「正确」的标注吗?
这个问题的答案,在哲学层面触及了机器学习的一个根本局限:监督学习本质上是在学习「人类共识」,当共识本身不存在时,学习就失去了明确的目标。这也是为什么数据中心AI运动如此强调标注规范——它不仅仅是一个工程问题,更是在为机器学习创造一个「可学习的世界」。当我们花时间去定义和统一标注规则时,我们实际上是在为模型构建一个逻辑自洽的学习环境,让梯度下降有一个明确的、可到达的目标。
如果两个人对同一张图都无法达成一致,那么再多的数据也拯救不了你的模型。你的数据集里,哪种标注边界情况最让人头疼?这或许正是下一次性能突破的关键所在。
相关推荐
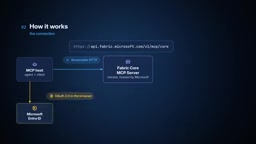
Fabric Core MCP Server正式发布:AI智能体管理Fabric资源的权限与风险
微软Fabric Core MCP Server正式发布,让AI智能体以经过认证和审计的方式管理Fabric工作区、项目与权限。本文解析其身份认证机制、职责边界、使用场景与破坏性操作风险。

一条推文背后:产品留存与商业决策的启示
一条简短的 Twitter 推文反映了用户对某项商业决策的认可,并由此探讨科技产品中商业决策与用户留存之间的关系与启示。
AWS MCP Server 配置指南:让 Claude 直连你的云环境
本文详解如何通过 OAuth 方式配置 AWS MCP Server,将 Claude 与 AI agent 安全连接到 AWS 云环境,涵盖 CLI 验证、清理旧配置、安装服务器、OAuth 授权及 IAM 权限边界等完整步骤。