检索是决策问题而非相似度问题:GPT Researcher实验的启示
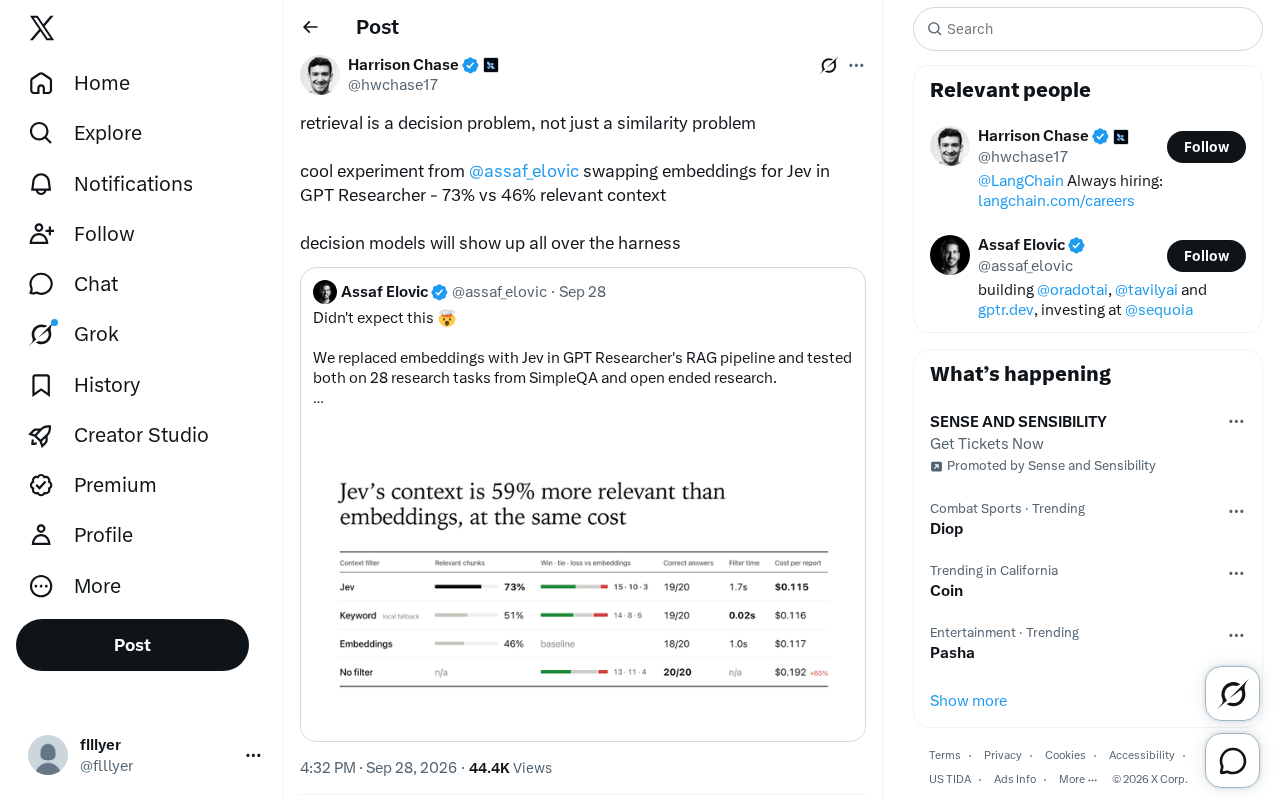
检索应被视为决策问题而非相似度匹配,实验显示决策式检索可将有效上下文比例从46%提升至73%。
本文基于一项来自 GPT Researcher 的实验,提出将 RAG 系统中的检索环节从「相似度匹配」范式重新定义为「决策问题」。传统向量嵌入检索依赖语义距离排序,无法感知任务目标与上下文动态,容易召回冗余或表面相关但实际无用的内容。实验对比显示,决策式检索方案(Jev)将有效上下文比例提升至73%,远高于嵌入检索的46%。文章进一步指出,这一范式转变不止于检索环节,决策模型有望渗透至 Agent 执行框架的工具调用、上下文管理、步骤规划等多个层面,带来系统性的性能提升。作者同时提示该数据来自单一实验,缺乏大规模复现,宜作为方向性参考而非定论。
重新定义检索:从相似度到决策
在RAG(检索增强生成)系统的构建中,长期以来主流思路是把检索当作一个相似度问题——通过向量嵌入(embeddings)计算查询与文档片段之间的语义距离,取最接近的若干结果作为上下文。但一条来自Twitter的观点正在挑战这一惯性思维:检索本质上是一个决策问题,而不仅仅是相似度问题。
这个区别看似微妙,实则关系到整个检索链路的设计哲学。相似度只告诉你「哪些内容看起来相关」,而决策模型要回答的是「哪些内容真正应该被送进上下文窗口」——后者需要判断、取舍与场景适配,而不是单纯的距离排序。
向量嵌入检索(Embedding-based Retrieval)的工作原理是将文本映射到高维向量空间,通过余弦相似度或点积等度量计算查询与文档的距离,选取距离最近的 Top-K 片段。这一方法依托 FAISS、Weaviate、Pinecone 等向量数据库,在大规模文档场景下效率极高,是目前 RAG 系统最普遍的技术选型。其局限性在于:嵌入空间捕捉的是统计意义上的语义相似,而非逻辑层面的「对当前任务有用」。同一个查询在不同推理阶段可能需要完全不同的信息,但嵌入检索无法感知这种上下文动态变化,每次查询都是独立的静态匹配。决策式检索则试图在这一步引入目标感知(goal-awareness),即检索组件能够理解「为什么要检索」,而不仅仅是「检索什么像这个查询」。
GPT Researcher的对比实验
据推文引用 @assaf_elovic 在 GPT Researcher 上进行的一项实验,团队尝试将传统的嵌入检索替换为一种名为 Jev 的决策式检索方案,结果对比相当鲜明:
- 决策模型(Jev):73% 的检索上下文被判定为相关
- 传统嵌入检索:仅 46% 的上下文相关
这意味着在同样的任务场景下,决策式方法把有效上下文的比例提升了近 27 个百分点。对于一个依赖上下文质量的研究型 Agent 而言,这样的提升直接影响最终生成结果的准确性与可信度。
为什么差距会这么大
嵌入检索的核心局限在于它是「无状态」的语义匹配:它不理解任务目标、不考虑已经检索到的内容是否冗余、也难以在多个候选之间做出「这个更值得放进有限上下文」的判断。当查询模糊、语义多义或存在大量表面相似但实际无用的片段时,纯相似度排序很容易被误导。
决策模型则可以引入更丰富的判断维度——比如内容的信息增益、与当前推理步骤的契合度、是否补充了新事实等。它把「检索什么」当成一个需要主动权衡的选择,而非机械的最近邻查找。
信息增益(Information Gain)是决策式检索的一个核心判断维度,指某段内容相对于当前已有上下文带来了多少新的、不重复的事实或推理依据。传统嵌入检索不具备此能力,容易将同一事实的多个近似表述全部召回,造成「语义冗余」——内容看似丰富,实际有效信息密度很低。这一问题在多跳推理(Multi-hop Reasoning)场景中尤为突出:Agent 需要依次检索多条相互关联的事实,每一跳的检索应当基于前一跳的结论做增量补充,而非重复搜索相同语义区域。决策模型可以显式追踪「已知信息集合」,从而避免冗余召回,将有限的上下文预算分配给真正能推进推理的内容。
决策模型将渗透整个 Agent 框架
推文中一个更具前瞻性的判断是:决策模型将出现在整个 harness(Agent 执行框架)的各个环节。
这句话点出了一个正在成型的趋势。在现代 AI Agent 的执行链路中,需要做「选择」的地方远不止检索一处:
- 工具调用:该用哪个工具、什么时候调用
- 上下文管理:哪些历史信息保留、哪些丢弃
- 步骤规划:下一步该做什么、是否需要回溯
- 检索取舍:本文讨论的核心场景
如果这些环节都从「基于规则或相似度的启发式」升级为「显式的决策建模」,那么 Agent 的整体表现有望获得系统性提升。检索只是这一范式转变最先显现的领域之一。
Agent 执行框架(Agent Harness)泛指驱动 AI Agent 完成复杂任务的调度层,负责协调大语言模型、工具调用、记忆模块与外部检索之间的交互流程。典型的实现包括 LangGraph、AutoGen、CrewAI 等框架,它们将任务分解为一系列可组合的步骤节点。当前大多数框架在各节点之间的路由决策上仍依赖规则模板或简单的模型输出解析,缺乏对「在当前推理状态下,哪个动作的预期价值最高」的显式建模。将决策模型引入 Harness 的各个环节,本质上是将强化学习或贝叶斯决策的思想注入 Agent 的控制流——不再把每一步选择视为孤立的分类任务,而是作为面向最终目标的序列决策过程的一部分。这与近期兴起的「LLM as a Planner + 专用决策头」架构探索方向一致。
对 RAG 系统设计的启示
对于正在构建 RAG 或研究型 Agent 的开发者,这个实验提供了几点实用参考:
第一,不要把嵌入检索当作终点。 向量召回可以作为初筛,但在召回之后引入一层决策式的重排或筛选,往往能显著提高送入模型的上下文纯度。
第二,关注上下文的「相关比例」而非「召回数量」。 73% vs 46% 的对比说明,衡量检索质量的关键指标应当是有效上下文占比,而不是简单地扩大召回范围——后者反而可能引入噪声,稀释有限的上下文预算。
第三,把「选择」显式化。 与其依赖模型隐式地忽略不相关内容,不如在架构层面用专门的决策组件筛选内容,让每一份进入上下文的信息都经过判断。
一个值得关注的方向
需要说明的是,上述数据来自单一来源的实验分享,尚未见到大规模、多场景的复现验证,具体的实验设置(数据集、任务类型、Jev 的实现细节)也未在原始信息中充分披露。因此这个 73% vs 46% 的结论更适合作为一个启发性的方向指引,而非可直接照搬的定论。
但无论具体数字如何,「检索是决策问题」这一视角的价值在于它促使我们重新审视 RAG 的底层假设。当 AI Agent 越来越复杂、上下文窗口越来越成为稀缺资源时,如何做出更聪明的检索决策,很可能是下一阶段性能突破的关键之一。
相关推荐

MrBeast百万美元挑战:吃空整家超市的内容工业拆解
深度拆解MrBeast百万美元吃空超市挑战:430万卡路里、202天封闭拍摄、规则设计与人物成长,解析头部内容创作者的工业化方法论与商业慈善双线叙事。

Cloudflare 推出 OHTTP 网关:隐私保护的新基础设施
Cloudflare 宣布推出 OHTTP 网关服务,通过中继与网关职责分离,将用户身份与请求内容解耦,为应用遥测、隐私合规等场景提供托管式隐私保护基础设施。本文解析 OHTTP 原理、信任模型与适用局限。

AI 自动化冷邮件:从网站痛点生成个性化外联的实战思路
一位网页设计从业者分享如何用 AI 工具 Swokei 自动诊断潜在客户网站的设计、速度、移动端与 SEO 问题,并生成个性化冷邮件,重构 B2B 外联工作流。本文解析其价值、分工逻辑与合规边界。