交互式AI数字人:重塑网站交互体验的技术全解析

给AI agent加一张会说话的脸,并让它实时操控网页界面的完整技术实现。
本文介绍了一种将AI数字人嵌入网站的实时交互架构,其核心突破在于:数字人不只是能说话的"摆设",还能作为交互主体直接操控页面——筛选菜单、添加订单、滚动区块。整套系统的设计逻辑围绕延迟展开,采用WebRTC传输、VAD语音检测、STT转录、轮次检测、LLM推理、工具调用、TTS合成、面孔渲染八个流水线环节,各环节并行推进以将响应延迟压缩到接近自然对话水平。开发者实际需要编写的只有三个文件:token服务器、AI agent和前端页面,LiveKit负责房间路由,Synthesia负责实时渲染面孔。由于头像只消费音频流,为已有agent加一张脸基本只需增加几行代码,成本门槛相对较低。
从聊天框到会说话的脸:网站交互的下一步
今天几乎所有网站的交互方式都是单向的——你阅读、你打字、然后等待回复。无论是聊天框、表单还是FAQ页面,本质上都没有脱离"读与写"的循环。而一种新的交互范式正在出现:给AI一个真实的面孔和声音,让用户直接开口说话,而不是不停滚动页面寻找想要的东西。
在一个餐厅网站的演示中,交互式数字人"Ava"不只是在回答问题,它真正地在操控界面:当用户要求"帮我创建一个全是素食菜品的订单"时,它一次性添加了focaccia、南瓜、burrata、芹菜根、pavlova和巧克力等菜品,还能滚动不同菜单区块、创建预订。这意味着数字人不再是摆设的"脸",而是能够实时改变用户界面的交互主体。
这类体验背后,是一整套精心设计的实时架构。本文将拆解它的工作原理、涉及的各个组件,以及如何用极少的代码把它搭建出来。
整个系统围绕一个核心问题:速度与延迟
理解数字人系统的关键,是理解它为什么对延迟如此敏感。在正常对话中,一个人说完到另一个人开口的间隔大约只有200毫秒。如果AI在聊天窗口里花3秒、5秒甚至10秒才回复,没人会太在意。但如果一张脸盯着你看10秒却不说话,整个体验就彻底崩了——它会显得完全坏掉。
正因如此,架构中的每一个环节都是为"快"而设计的,而且大多数组件在上一个环节还没结束时就已经开始工作。这种"边想边说"的流水线思路,是让数字人感觉自然的根本。
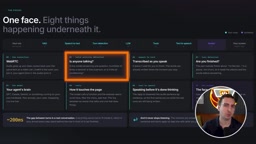
完整的组件流水线
从连接到最终的那张脸,整个链路包含以下几个环节:
- 连接(WebRTC):负责音视频流传输,和Zoom等视频通话用的是同一套技术。系统会建立一个"房间",由LiveKit来处理。房间里有三个参与者——浏览器中的你、AI agent、以及数字人头像。
- VAD(语音活动检测):一个类似小模型的组件,每秒回答数百次"现在有人在说话吗",用来区分真正的说话声和空调声、背景噪音。
- 语音转文字(STT):实时转录你说的话并发给大模型。在医生诊所、汽车维修店等专业领域,还需要能理解特定术语。
- 轮次检测(Turn Detection):这是容易被忽略的一环。如果你说"我想要……"然后停顿思考,模型不该立刻抢话。判断对方是否真的说完,由专门的模型负责。
- 大模型(LLM):agent的"大脑",可以是GPT、Claude或Gemini,负责生成文本回复或进行工具调用。
- 工具(Tools):接入模型后,让它知道自己能做什么,也是数字人操控页面的途径——这正是它超越普通语音接口、显得生动的关键。
- 文字转语音(TTS):把模型的回复实时转成声音,必须逐token流式送入语音,不能等全部回复生成完。
- 面孔(Avatar):由Synthesia负责渲染。它需要一个看起来真实的实时头像,并把文字实时同步到声音和唇形上,确保不脱节。
WebRTC(Web Real-Time Communication)是一套开放标准,允许浏览器之间直接建立点对点的音视频连接,无需安装插件或中间服务器转发媒体流。它内置了回声消除、噪声抑制、自适应比特率等功能,是Zoom、Google Meet等视频会议产品的底层基础设施。在数字人系统中,WebRTC承担的角色是"搬运工"——把麦克风捕获的PCM音频实时传到agent,再把Synthesia渲染好的视频帧实时传回浏览器,整个过程的传输延迟通常在50毫秒以内。LiveKit是一个开源的WebRTC服务器框架,解决了原生WebRTC在多人场景下的房间管理、信令协商和媒体路由等复杂问题,使开发者可以用SDK调用代替繁琐的底层协议处理。
四个真实组件:架构其实很简单
搭建一个真正可用的AI数字人,你自己需要写的东西其实只有三样:一个承载数字人的网页、一个极小的token服务器,以及AI agent本身。另外两块——LiveKit和Synthesia——是你连接的外部服务,帮你处理掉大量复杂逻辑。
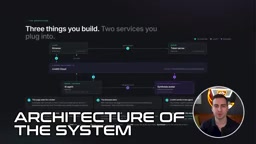
最好的理解方式就是把它想象成一次视频通话。LiveKit是"这通电话",负责房间管理、音视频流和各参与者之间的路由。房间里有三个参与者:浏览器中的客户端、AI agent、以及Synthesia头像。
完整的数据流
整个流程可以拆成五步:
- 客户端请求票据:网页不能直接加入房间,它要向token服务器(一个很小的Python服务)申请access token。所有密钥都存在服务器端,所以这一步必须在服务端完成。token还会告诉LiveKit该把哪个agent送进房间。
- 浏览器加入房间:拿到token后,页面加入LiveKit房间并开始发送麦克风音频。整个客户端大约只需30行代码——播放Synthesia视频、响应消息、把麦克风音频推入房间。
- LiveKit送入agent:Python agent运行在自己的服务器上等待加入。房间打开后,agent听到麦克风音频,开始跑STT→LLM→TTS的流水线。
- agent把语音交给Synthesia:通过LiveKit插件写几行代码,把音频重定向到Synthesia的头像服务,而不是直接播进房间。
- 头像加入通话:Synthesia渲染出面孔、完成唇形同步,作为独立参与者发布视频流。浏览器看它就像电话里的另一个人。当agent调用工具(比如筛选菜单)时,会通过房间发一条小消息回浏览器来控制界面。
一个关键事实是:头像并不关心词是谁生成的。所有思考都由你的agent完成,头像只接收音频。所以如果你已经有一个AI agent,给它加一张脸基本上只是三四行代码的事。
Token服务器这一设计模式在实时通信系统中极为常见,其核心价值是"凭证换权限"的安全隔离。浏览器端的JavaScript代码是完全公开可见的,如果把LiveKit的API密钥直接写在前端,任何人都可以提取并滥用,产生无限账单或恶意注入。Token服务器作为唯一持有密钥的可信方,在服务端对请求做身份校验后,签发一个短期有效的JWT(JSON Web Token),其中编码了用户身份、允许加入的房间名、以及读写轨道等具体权限。LiveKit在收到这个token时无需查询原始密钥,只需验证签名合法性即可授权接入。这种"密钥不出服务端、前端只持短效凭证"的模式,是现代实时通信系统的标准安全实践。
关于那张脸:Synthesia做了什么
负责渲染面孔的是Synthesia,它是目前最大的AI视频平台之一,超过90%的财富100强企业在使用。其核心产品是:输入脚本,得到一段逼真的AI主持人视频。平台提供240多个库存头像,也可以自定义,拥有上千种声音,还能把视频翻译成160多种语言。
过去这些头像都是预录的,而新的"交互式头像"把它们变成了实时的——同样的画质,但实时渲染,可以直接对话。
使用方式有两种。非开发者可以用Synthesia内置的"角色扮演会话",设置销售通话、棘手客户对话等场景,和头像出声练习并获得反馈。开发者则用API——它本质上是LiveKit的一个插件,按量计费,每分钟约0.12美元,并附带免费额度。甚至还有专门给Claude Code和Cursor的skill,能自动完成配置。
实际代码:三个核心文件
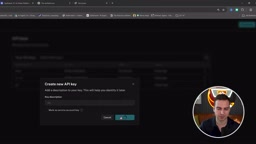
要动手搭建,你需要一个LiveKit项目和一个Synthesia账号,两者都提供免费额度。在LiveKit中创建项目后,进入设置里的API Keys生成新密钥,会得到三个环境变量直接复制即可。在Synthesia的开发者标签页创建API key,注意要赋予它interactive avatars的权限。
代码主要是三个文件:
- server.py:token服务器,负责提供网页和发放加入LiveKit房间的token。两个路由,一个生成token,一个渲染网站。
- agent.py:最复杂的部分。引入Synthesia插件、加载各项配置、给agent命名(需与server.py匹配)、指定avatar ID和声音、写入prompt或指令。演示中prompt告诉数字人菜单内容和可选项;你也可以接入工具、RAG等。文件中定义了show section、filter menu、focus dish、add to order等工具供模型调用,并创建agent session,指定STT、LLM、TTS和轮次处理方式,再用几行代码把Synthesia作为插件接入。
- index.html:前端连接token服务器,订阅视频、推送音频轨道,并监听房间事件以便在前后端之间通信,根据事件点亮或更新界面。
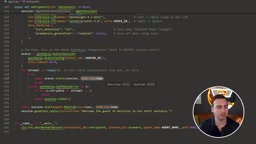
整个agent.py的逻辑可以概括为:创建session → 连接头像 → 头像尝试加入房间 → 启动session开始监听 → 让它开口说话。头像加入房间通常只需几秒,设置好超时和错误处理即可。
在演示中,当用户问"最贵的甜点是什么",数字人几乎瞬间回答"是巧克力",同时在后台调用工具高亮对应菜品、滚动页面。按下停止后,用户立即被移出房间,也就停止了计费和监听。
这会是网站交互的未来吗
值得一提的是,这套方案的门槛比想象中低得多。如果你已经配置好LiveKit,只需安装一个插件;或者直接给你的编程agent加上Synthesia skill,让它自动帮你接好LiveKit房间、添加插件、改好所有配置——演示中作者正是这么做的,没有手写任何代码。
LiveKit完全开源,你可以调整任何部分、自行托管服务器,不必依赖官方provider。头像、声音、模型都是可替换、可定制的。
从技术角度看,交互式数字人把"语音对话"和"界面操控"结合在了一起,让网站从被动的信息展示转向主动的、对话式的服务。它是否真的会成为网站交互的未来还有待观察,但这套实时流水线架构,确实为"用说话代替点击"提供了一个相当完整且可落地的技术样板。
当前交互式数字人面临的最大挑战不是技术可行性,而是用户接受度和场景适配。研究者将过于逼真但又不完全真实的虚拟形象引发的不适感称为"恐怖谷效应"(Uncanny Valley)——当数字人的面部表情、眨眼频率或唇形同步出现细微偏差时,反而比明显卡通化的形象更令人不安。此外,并非所有用户场景都适合语音交互:嘈杂环境、公共场所、或用户本身不便开口说话的情境都会造成障碍。从商业部署角度看,每分钟约0.12美元的渲染成本意味着一个日活万人、平均交互3分钟的网站每月需承担数万美元的额外开销,这决定了这类体验短期内更适合高客单价的销售或服务场景,而非通用型网站。
相关推荐

Devin年收入逼近10亿美元:AI编程热潮背后的真实账本
Cognition旗下Devin AI编程智能体年化收入逼近10亿美元,四个月翻倍,估值达480亿美元。本文解析AI编程热潮背后的真实收入、53倍估值倍数、8亿美元现金消耗与企业客户版图。
n8n实战:从零搭建你的第一个AI Agent工作流
基于n8n in 100 days系列第14集实操,详解如何用n8n搭建第一个AI Agent:从When chat message received触发节点、AI Agent与Chat Model,到Memory记忆模块的作用与设计逻辑。

Aleph Alpha开放Kolibri 78B在线免费试用
Aleph Alpha旗下780亿参数大模型Kolibri 78B现已开放免费在线试用,用户无需部署即可通过网页体验这款欧洲本土AI模型的对话能力。