接受率≠加速:有损投机解码的"长度膨胀"陷阱

有损投机解码虽提高接受率,却因输出变长抵消加速收益。
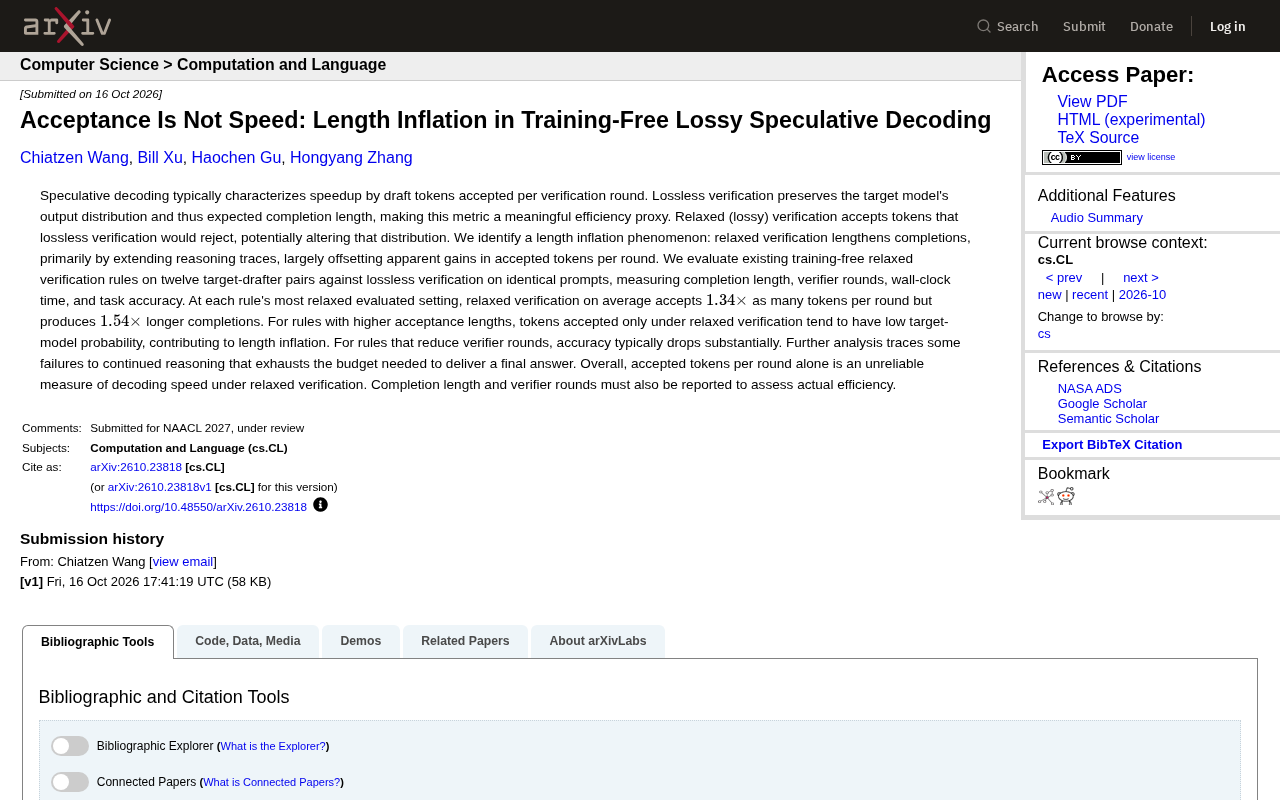
本文剖析了无训练有损投机解码中一个被忽视的陷阱:松弛验证虽然提高了每轮接受的 token 数,却同时拉长了生成结果,使得看似可观的加速被抵消。研究在十二组目标-草稿模型配对、相同提示词下对比现有松弛验证规则与无损验证,发现最宽松设置下每轮接受 token 数达 1.34 倍,但完成长度膨胀至 1.54 倍。其机制在于,被额外接受的低目标概率 token 会诱导模型继续推理而非收束答案,推理类任务尤为明显;能减少验证轮数的规则往往伴随准确率下降,部分失败案例源于推理耗尽预算而无法给出最终答案。文章据此建议,有损场景下不能单独以接受 token 数衡量速度,需同时报告完成长度、验证轮数、实际耗时与任务准确率。
接受率≠加速:有损投机解码的"长度膨胀"陷阱
投机解码(Speculative Decoding)一直被视为大模型推理加速的利器:用小模型快速草拟 token,再由大模型并行验证,理想情况下能在不损失输出质量的前提下显著提速。然而,一项针对无训练有损投机解码的研究揭示了一个被忽视的现象——放宽验证规则虽然提高了每轮接受的 token 数,却会让生成结果变长,反而抵消了看似可观的加速收益。
被误读的效率指标:每轮接受 token 数
在无损验证(lossless verification)下,输出分布与目标模型完全一致,因此"每轮接受的 token 数"确实能反映真实的加速比。但一旦采用松弛(有损)验证,接受了一些无损验证本会拒绝的 token,输出分布就被改变了,这个指标也随之失真。
研究团队在十二组目标模型-草稿模型配对、相同提示词下,系统对比了现有无训练松弛验证规则与无损验证的表现,测量了完成长度、验证轮数、实际耗时和任务准确率。结果颇具警示意味:在各规则最宽松的设置下,松弛验证平均每轮接受的 token 数达到 1.34 倍,但生成的完成长度却膨胀到 1.54 倍。
无损验证与松弛(有损)验证的区别在于草稿 token 被目标模型接受时所依据的判定准则。无损验证(如标准投机采样)采用精确的接受-拒绝采样:以目标模型与草稿模型概率之比为接受概率,并对拒绝位置按残差分布重新采样,因此最终输出分布与目标模型严格一致。松弛验证则放宽这一准则,例如只要目标模型对草稿 token 的概率超过某个阈值、或采用 top-k/top-p 近似匹配就直接接受,而不做严格的重要性修正。这样每轮能吞下更多 token,但被接受的 token 不再服从目标分布,输出质量与行为特性都可能偏离原始模型。理解这一区别是判断"接受率能否代表加速比"的前提:只有分布不变时,接受 token 数才与真实加速呈单调关系。
长度膨胀从何而来
这一现象的核心机制在于:在有损验证下被额外接受的 token,往往在目标模型中的概率很低。这些低概率 token 一旦进入推理轨迹,会诱导模型继续"思考"而非收束答案,从而显著拉长推理过程。
换句话说,接受率的提升并非来自更高效的并行验证,而是来自模型被带着走出了更长的推理路径。对于推理类任务,这种效应尤为明显——松弛验证主要延长的正是推理轨迹(reasoning traces)。
研究还发现,那些能够减少验证轮数的规则,通常伴随着准确率的明显下降;部分失败案例可以追溯到模型持续推理、耗尽了本应用于给出最终答案的预算,最终无法收敛到结论。
**推理轨迹(reasoning trace)**指具备思维链能力的模型在给出最终答案前生成的一系列中间推理步骤,如分解问题、试错、自我检查等。与普通对话输出不同,推理轨迹的长度并不固定,模型会在"继续思考"与"收束作答"之间动态权衡:当它认为当前思路尚不确定时倾向继续展开,当置信度足够时才输出结论。推理轨迹越长,消耗的生成预算(如最大 token 数限制)越多,端到端时延也随之上升。正因如此,任何改变 token 序列分布的机制——包括有损验证额外接受的低概率 token——都可能改变模型对"是否该继续思考"的判断,进而系统性地影响轨迹长度。这也是评估投机解码时不能只看吞吐、还必须关注输出长度的深层原因。
对工程实践的启示
这项分析给出了明确的评估建议:在有损投机解码场景下,仅报告每轮接受 token 数是不足以衡量解码速度的。要真实评估效率,至少需要同时报告完成长度和验证轮数,并结合实际耗时与任务准确率综合判断。
对于正在部署投机解码的团队而言,这意味着选型时不能唯"接受率"论。一个接受率更高的松弛规则,可能在端到端时延和输出质量上双双落后。真正有价值的加速,应当建立在输出分布可控、完成长度稳定的基础之上。
结语
投机解码的加速承诺并非无条件成立。当验证被放松,接受率就从一个效率代理指标退化为一个容易误导的数字。长度膨胀现象提醒我们:衡量推理加速,终究要回到端到端耗时与任务质量的真实表现上。
相关推荐

AGENTS.md 实战指南:让编程 Agent 真正好用
AGENTS.md 和 CLAUDE.md 能显著提升编程 Agent 表现,但研究发现用错反而让成本上升 20%。本文详解该写什么、该删什么、200 行与 32KB 的硬边界、Monorepo 嵌套规则及安全提醒。

花旗AI编程代理Devon:年省30%技术外包费,1.4万工程师已使用
花旗集团利用AI编程代理Devon,一年内削减30%技术供应商费用,1.4万工程师使用,产品发布提速30%-40%。本文分析其对IT外包行业的冲击及未来人机协作模式。

从生日派对到千亿AI帝国:新一代PayPal黑帮崛起
2015年一张生日派对合影,十年后催生Scale AI、Cognition AI等千亿估值AI公司。解析新一代PayPal黑帮的创业路径、互相投资生态,以及Peter Thiel的Founders Fund如何完成代际传承。