进化不是随机:Akarsh Kumar谈人工生命与另一种智能范式
进化算法与基础模型结合,正在重新定义对「可能存在的生命」与智能本质的搜索方式。
研究者 Akarsh Kumar 在访谈与论文 ASAL 中提出:进化绝非随机搜索,其选择机制能将指数级组合问题转化为线性搜索,是求解离散组合问题最强大的算法之一。他以康威生命游戏、Lenia、粒子生命等模拟器为例,说明极简规则如何涌现出令人惊叹的复杂性,并将研究议程定位于「可能存在的生命」而非地球现有生命。在智能范式层面,他区分了当前大语言模型所代表的「统计智能」与路径依赖式「规律性智能」,认为课程学习是一种极强的正则化,能将对称性直接烘焙进神经回路。ASAL 用视觉语言模型作为评判者参数化搜索模拟空间,成功发现了多类涌现现象;Core War 实验则证明,LLM 单独使用很弱,但放入带验证器的进化循环后能击败 96% 的人类程序。
当我们说进化是「随机」时,我们错了
人工智能领域有一个长期存在的误解:进化是一种笨拙、原始的算法,只有在无法使用梯度下降时才会退而求其次。研究者 Akarsh Kumar 在这期访谈中直接驳斥了这一观点——「我只想澄清一点,进化绝不是随机的。」
在他看来,进化恰恰是我们已知的、求解离散组合问题最强大的算法之一。关键在于进化中被严重低估的「选择机制」:如果你解决了拼图的一小部分并把它保留下来,再去搜索其余部分,你就能把一个指数级的搜索问题转化为线性搜索问题。这种「抓住已有成就、在其上继续构建」的能力,正是随机搜索所不具备的。
这场对话围绕 Kumar 的论文 ASAL(Automating the Search for Artificial Life with Foundation Models,用基础模型自动化搜索人工生命)展开,涉及人工生命、涌现现象,以及一种与主流深度学习截然不同的智能范式。
人工生命:研究「可能存在的生命」而非「现有的生命」
Kumar 引用了论文开头的一句话——人工生命研究的不只是「我们所知的生命」,更是「可能存在的生命」(life as it can be)。
他的逻辑很清晰:如果只想理解地球上现有的生命形态,去研究生物学就够了;如果只想理解智能,去研究神经科学就够了。但我们创造 AI,是为了获得一种更机械化、更本质的理解。借用 Jeff Clune 的说法,要真正宣称理解了智能或生命,就不能只谈论某一种特定形态,而必须理解「所有可能的智能空间」「所有可能的生命形态空间」。
「你不能只看一辆车就说所有车都是这样,」Kumar 举例,「你也不能只看 GPT-5 就说所有智能都是这样,不能只看人脑就说所有智能都是这样。存在一个空间,我们需要研究整个空间。」
人工生命有一个有趣的子领域叫「人工化学」——改变氢、氦这类元素的交互方式,看会发生什么。这赋予了研究者在「其他宇宙」中做反事实分析的能力:在哪些世界里会涌现出开放式的复杂性,在哪些世界里只会产生随机噪声?为什么同一套「物理法则」运行会产生惊人的现象,而换一套就什么都不发生?这正是 Kumar 想要围绕其展开的核心研究议程。
从康威生命游戏到粒子生命:几种模拟器
要理解这些抽象概念,最好从具体的模拟器入手。
康威生命游戏
最经典也最简单的例子是康威生命游戏(Conway's Game of Life):一个二维网格,每个细胞只有「生」或「死」两种状态,规则极其简单——比如一个死细胞若有恰好三个活邻居,就会「复活」。就是这样一个可能是最简单的世界,运行多步之后却能涌现出令人难以置信的复杂性。
Kumar 提到,有专门的 Discord 社区在不断分享他们发现的新模式——比如每 64 步重复一次、以某种速度移动的「飞船」。这些爱好者甚至定义了系统中的「因果速度」:信息每步最多传播一个细胞,他们称之为「光速 c」,并会说某个滑翔机以「c/16」的速度移动,就像真实物理学中那样。这实在是一个货真价实的人工宇宙。
其他模拟器
论文中还用到了几种更复杂的系统:
- Lenia(Bert Chan 创造):生命游戏的连续化推广,用连续微分方程更新规则,可扩展到 RGB 三通道。
- 神经元胞自动机(Mordvintsev,2020 年的「Growing Neural Cellular Automata」):用一个小型神经网络替代元胞的局部更新规则,通过训练让局部规则自组织地「生长」出一只壁虎的图像,哪怕删掉一部分,系统也能持续重建。
- Boids:模拟鸟群、鱼群集群行为的经典算法,每个个体只根据邻居的位置做出左右决策,却能涌现出整体的群集行为。
- 粒子生命(受 Tom Mohr 启发):在欧氏空间中抛入若干类型的粒子,用一个 6×6 矩阵定义不同类型粒子间的吸引、排斥或中性关系。改变这个「物理矩阵」,有些配置平淡无奇,有些却会形成看起来像细胞的、能持续存在的结构。
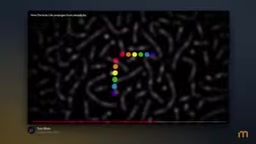
这个「细胞状物体」令人着迷:它通过利用物理规则,在这个世界里创造出一个能够持续存在的对象。正如 Kumar 所说,生命的本质或许就是「持存」(persistence)——这些有机体只是在设法让自己延续到下一帧,并为此利用了物理法则。
「涌现」(emergence)是这些模拟器背后最核心的概念:系统整体表现出的性质,无法从单个组成部分的规则中直接预测或推导出来。康威生命游戏里没有一条规则规定「会出现能移动的结构」,但「滑翔机」(glider)就是出现了。这种现象在复杂系统科学中被称为「强涌现」,与之对应的「弱涌现」则指原则上可从底层规则推导、但实际计算成本极高的宏观性质。区分二者至关重要:如果生命与智能属于强涌现,那么逐一检查底层规则永远无法理解它们,必须在更高层次上研究;如果属于弱涌现,则理论上存在可还原的解释路径。人工生命领域的核心争论之一,正是这些模拟中观察到的复杂性究竟属于哪一类。Wolfram 的「计算不可约性」概念与此密切相关——他认为某些系统的演化过程本身就是最短的计算路径,无法被任何捷径替代,只能模拟展开后才能知道结果。
统计智能 vs 规律性智能
这期访谈最有价值的部分,是 Kumar 提出的两种智能范式的区分。
他把当前的大语言模型称为「统计智能」——它们在统计意义上几乎是完美的,你可以把它们训练在任何东西上,甚至直接教它们微积分而无需先学算术。「这是一种非常怪异、非常外星的训练方式。」
与之相对的是「规律性智能」(regularity-based intelligence)。人类和动物的学习遵循一种天然的课程(curriculum):先学这个,再学那个,循序渐进,别无他法。Kumar 认为,人类按序学习、进化沿路径依赖的方式,恰恰是它能在表征中创造出优美、规整结构的原因——也正是其鲁棒、可适应、可泛化的根源。
这与此前「分裂纠缠表征」(Fractured Entangled Representation, FER)的研究一脉相承。访谈引用了 Kenneth Stanley 的观点:重要的不只是你到达了哪里,更是你如何到达那里。「现在我们往往只关心结果——看基准分数,看它是否通过了数学奥赛。但如果『如何到达』才是关键呢?」
Kumar 喜欢用「正则化」的视角来看待这一切。数据是一种正则化,权重衰减(L2)是另一种,而课程学习——尊重沿途习得的对称性——则是一种「极其极其强大」的正则化。他进一步把 FER 方法视为一种「自动对称性学习算法」:你无法用数学公式写出「光照不变性」这样的归纳偏置,但数据驱动的演化可以把这种规律直接「烘焙」进神经回路里。
「分裂纠缠表征」(Fractured Entangled Representation,FER)是理解这段讨论的关键背景。该概念来自 Kenneth Stanley 等人的研究,描述的是大型神经网络在训练后形成的一种内部表征状态:不同概念的特征在网络参数中高度纠缠,无法干净地分离,且同一概念的表征在网络中是碎片化分布的,而非局部、模块化地存在。这种表征结构在基准测试上表现优异,却在分布外泛化、组合推理和持续学习上表现脆弱——改变训练数据的少量细节,模型的内部表征可能发生灾难性漂移。与之对立的理想是「因子化表征」(disentangled representation):不同概念对应独立的内部维度,修改一个维度不影响其他维度,模型因此具备更强的组合泛化能力。Kumar 认为,遵循自然课程的路径依赖式学习,是让模型自发形成因子化表征、而非 FER 的关键机制。
用基础模型搜索人工生命:ASAL 的三种用法
ASAL 的核心思想是:与其硬编码单个模拟,不如参数化一个模拟空间,然后用基础模型(视觉语言模型)作为「评判者」去搜索。
这样做有两个好处。其一,更容易指定你想要什么——你不需要给出一张猫的精确图像并做像素级监督,只需说「我想要一只猫」,任何猫都行;这极大地简化了搜索问题。其二,它天然契合「计算不可约性」(computational irreducibility,源自 Stephen Wolfram):你无法预测某条物理规则会产生什么,那就直接模拟、让它展开,再把结果交给基础模型评判。
论文中的实验展示了几个发现。在监督目标实验中,多细胞生物、神经元网络、病毒、真菌群落等目标在 Lenia、Boids、粒子生命中都能找到对应的涌现现象。在开放式搜索中,他们找到了比康威生命游戏更具开放性的模拟。更有意思的是对全部 26 万条规则的绘制——他们将运行结果输入 CLIP 并在二维空间可视化,按开放性着色后发现:存在一个「不开放」的大岛屿,和一个所有最酷模拟都聚集其中的小岛屿。
一个耐人寻味的点在于:基础模型本身是「分裂纠缠表征」,它产出的往往是「冒牌货」(imposter)。但这恰恰够用——因为你只是把它当作评判者,用它来引导(bootstrap)出一个真正良构的、因子化的表征。对于这类只关心输出行为、不关心内部表征的任务,基础模型的表现几乎是完美的。
Core War 实验:进化 + LLM 的威力
为了验证进化的力量,Kumar 团队做了一个基于 Core War 的实验。Core War 是上世纪 80 年代的编程游戏:玩家用一种名为 Red Code 的汇编语言编写程序,放进虚拟机的随机内存位置同台竞技,目标是通过向对手执行线程注入非法操作使其崩溃,让自己成为最后运行的程序。
他们用 LLM 作为变异算子,在进化循环中优化程序去击败初始程序,并采用 MAP-Elites 来应对这个高度欺骗性、非局部的搜索空间。结果令人印象深刻:
- 仅第一轮训练产生的「战士」就能击败人类战士数据集中 96% 的对手(约 300 个人类程序)。
- 随着对抗演化轮次增加,战士变得越来越通用,更可能击败从未见过的人类战士,行为方差也在下降,趋向于一个「通才型」战士。
关键在于:LLM 零样本写 Red Code 很糟糕,best-of-N 采样也很糟糕,但一旦放进带验证器的进化循环,它就变得非常强大。这与 AlphaEvolve 的教训如出一辙。
Kumar 的解释直指进化的本质:进化只需要你的变异在 1% 的时间里是好的即可。前 LLM 时代的 AutoML-Zero 用随机变异做程序搜索极难奏效,因为任何随机变异产生有用代码的概率近乎为零;而 LLM 虽不能保证 100% 成功,却能远超 1%。于是每当成功,你就能保留成就并在其上构建——这正是「进化 + LLM」远胜单独使用 LLM 的根本原因。「差距甚至都不接近。」
MAP-Elites 是一种「质量-多样性」(Quality-Diversity,QD)优化算法,由 Mouret 和 Clune 于 2015 年提出。与传统进化算法只追求单一最优解不同,MAP-Elites 同时维护一个按「行为特征」分格的档案库,每个格子保存在该行为维度上表现最好的个体。这样做的好处是主动维持种群多样性,避免早熟收敛到局部最优,同时对高度欺骗性(deceptive)的适应度地形特别有效——在这类地形中,局部最优解与全局最优解之间隔着大量低分区域,贪心搜索极易陷入。Core War 场景天然具有欺骗性:一段在当前对手面前无敌的程序,可能对另一类对手完全无效;MAP-Elites 通过覆盖不同行为模式的战士,使种群整体具备对抗多种策略的能力,最终演化出泛化性更强的通才型程序。这也解释了为何随着对抗演化轮次增加,战士的行为方差会下降——档案库逐渐被真正鲁棒的策略填满。
一场面向长期的智能赌注
Kumar 坦言,人工生命是「一个关于智能的长期赌注」。他并不主张去模拟每一个底层粒子来自底向上地启动智能,而是希望从自然进化和这些模拟中提炼出正确的「抽象」——一个足够高效、能在十年后运行,并能以正确方式产出通用智能的抽象。
这正是深度学习的某种延伸逻辑:我们不想学会那只壁虎长什么样,而想学会从积木重建壁虎的「过程」;不想学会智能本身,而想学会「生长出智能的过程」。在统计智能已经取得巨大成功的今天,Kumar 的提醒值得深思——我们应继续走这条路,但不该把所有鸡蛋放在一个篮子里。
相关推荐

WorkBuddy保姆级教程:半小时跑通自动化工作流
WorkBuddy 自动化工作流保姆级拆解:为什么大多数人只把它用成聊天软件,27 个支点课程与 12 个模板如何帮助新手半小时跑通落地实操,附使用边界提醒。

Codex云端模式详解:环境配置与适用场景
本文详细解析Codex云端模式的工作原理、环境配置步骤及适用场景,包括如何创建环境、连接GitHub仓库、设置定时任务,并对比云端与本地模式的差异,帮助开发者高效利用Codex。

Claude Code免费使用真相:三条路与一个骗局
Claude Code 免费使用是否可行?本文拆解 Pro、Max 的真实成本(含汇率与税费)、社区免费方案的技术原理与隐私代价,以及假安装包、钓鱼页面等安全陷阱,并给出访客通行证、开源贡献者计划和本地模型三条合法免费路径。