进化神经可塑智能体:用物理索引专家记忆缓解灾难性遗忘

进化神经可塑智能体用物理状态索引专家记忆,以进化搜索替代梯度训练来缓解持续强化学习中的灾难性遗忘。
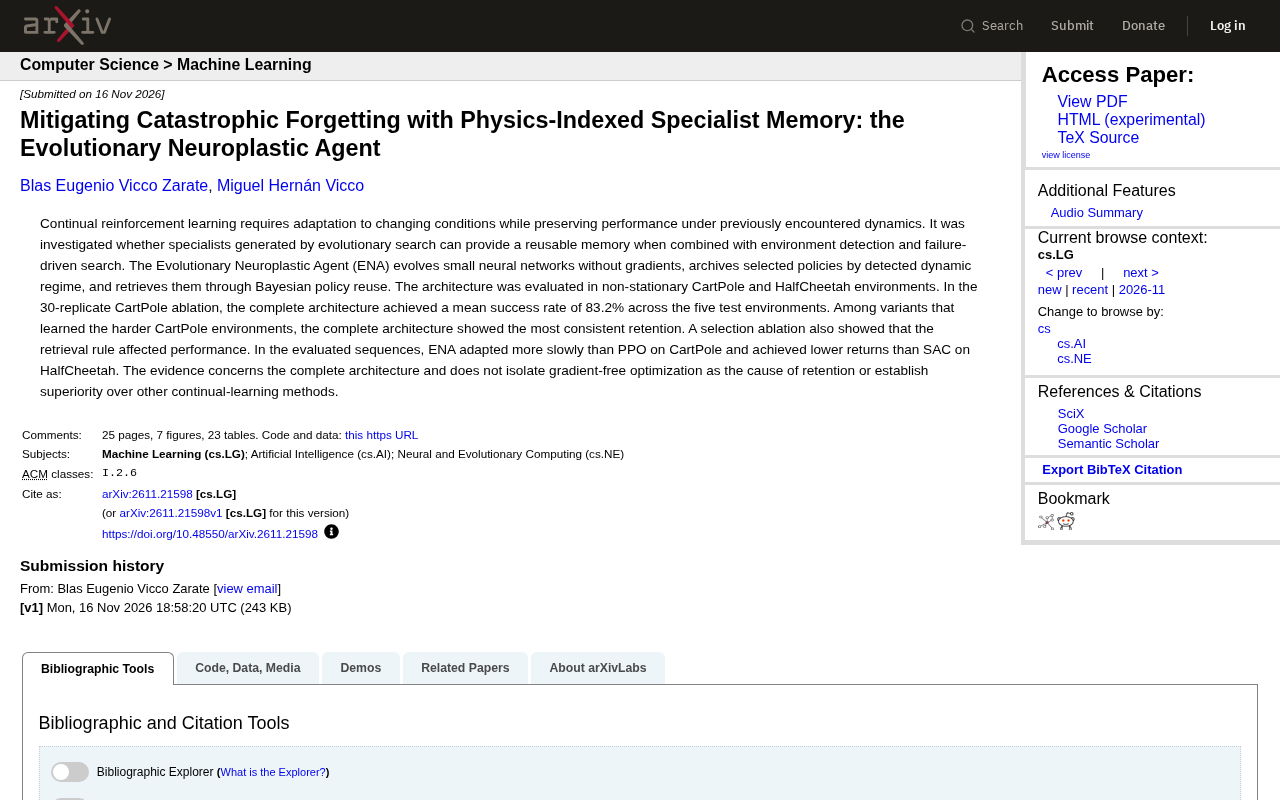
论文提出进化神经可塑智能体(ENA),通过进化搜索生成针对特定动力学状态优化的小型专家网络,并按检测到的环境动态状态归档。智能体利用贝叶斯策略复用机制检索专家策略,当检索失败或性能不佳时触发新一轮进化搜索。在非平稳的 CartPole 和 HalfCheetah 环境中,完整架构在 CartPole 的 30 次重复实验中平均成功率达 83.2%,且检索规则被证实对性能有显著影响。然而,ENA 在 CartPole 上适应速度慢于 PPO,在 HalfCheetah 上回报低于 SAC。研究未隔离无梯度优化本身的贡献,也未确立相对其他持续学习方法的优越性,但提供了一种将记忆组织维度从任务转向环境动力学状态的新思路。
持续强化学习面临一个根本矛盾:智能体需要不断适应环境变化,同时又要保留此前学到的技能。灾难性遗忘正是这一矛盾的集中体现——新任务的学习往往会覆盖旧任务的策略。一篇题为《Mitigating Catastrophic Forgetting with Physics-Indexed Specialist Memory: the Evolutionary Neuroplastic Agent》的研究提出了一种名为进化神经可塑智能体(Evolutionary Neuroplastic Agent, ENA)的架构,尝试用进化搜索生成的专家网络加上环境检测与失败驱动搜索,构建可复用的记忆机制。
核心思路:把专家策略按物理状态归档
ENA 的设计并不依赖梯度下降来训练一个大网络,而是通过进化搜索生成一系列小型神经网络,每个网络针对特定的动力学状态进行优化。当智能体检测到当前环境处于某个已知的动态状态时,就通过贝叶斯策略复用机制从档案中检索对应的专家策略。如果当前状态没有匹配的专家,或者检索到的策略表现不佳,失败信号会触发新一轮的进化搜索,生成新的专家并存入档案。
这种“物理索引”的命名指向一个关键点:档案的索引不是任务标签或时间步,而是检测到的动态状态本身。换句话说,记忆的组织方式与环境的物理特性绑定,而非与训练序列绑定。这为跨任务的知识复用提供了一种不同的视角。
进化搜索是一类受生物演化启发的黑箱优化方法,它不依赖梯度信息,而是通过种群初始化、变异、交叉和选择等操作迭代更新候选解。在 ENA 中,每个候选解是一个小型神经网络,其权重被编码为基因组,适应度由该网络在特定动力学状态下的表现决定。与传统神经进化类似,这种方法适合搜索空间非凸或梯度信号稀疏的场景,但样本效率通常低于梯度下降。贝叶斯策略复用则是在检索阶段使用贝叶斯推断:根据当前检测到的动态状态,计算档案中每个专家策略的后验匹配概率,并选择概率最高的策略进行复用。这种概率化检索允许智能体在状态模糊时进行软性选择,而非硬性匹配,从而提高了复用的鲁棒性。
实验设置与关键数据
研究在非平稳的 CartPole 和 HalfCheetah 环境中评估了 ENA。在 CartPole 的 30 次重复消融实验中,完整架构在五个测试环境上取得了 83.2% 的平均成功率。在那些成功学会了较难 CartPole 环境的变体中,完整架构表现出最一致的保留能力。此外,一项选择消融实验表明,检索规则本身对性能有显著影响——也就是说,贝叶斯策略复用的选择逻辑不是可有可无的装饰,而是影响最终表现的关键组件。
这些数据说明,专家档案加环境检测加失败驱动搜索的组合确实能在测试序列中维持一定的旧任务性能。但研究也明确指出了边界:在评估的序列中,ENA 在 CartPole 上的适应速度慢于 PPO,在 HalfCheetah 上的回报低于 SAC。
与主流持续学习方法的对比定位
这项工作的价值不在于宣称全面超越现有方法,而在于提供了一条不同的技术路线。梯度下降训练的持续学习智能体通常依赖正则化、回放缓冲或参数隔离来对抗遗忘,而 ENA 用进化搜索加策略复用替代了这些机制。代价是适应速度较慢,回报也可能不如专门的梯度方法——这与进化搜索本身的样本效率特征一致。
论文作者也坦承了证据的局限:实验评估的是完整架构的整体表现,并没有单独隔离无梯度优化这一因素,因此无法断定保留能力来自进化搜索本身;同样,实验也没有建立相对于其他持续学习方法的优越性。这种克制在强化学习论文中并不常见,但也意味着读者不应将 83.2% 的成功率直接解读为对 PPO 或 SAC 的胜利。
灾难性遗忘是人工神经网络在序列学习中的经典问题:当网络在新任务上训练时,权重更新会大幅改变与旧任务相关的参数,导致旧任务性能急剧下降。在持续强化学习中,这一问题尤为突出,因为环境分布会随时间变化,智能体需要在适应新动态的同时保留旧策略。主流应对策略包括:正则化方法(如弹性权重巩固,通过惩罚重要权重的变化来保护旧知识)、回放缓冲(存储旧经验并在新任务训练时混合采样)、以及参数隔离(为不同任务分配独立的子网络或模块)。ENA 则另辟蹊径,完全绕开梯度更新,转而依赖进化搜索生成专家网络,并通过环境状态索引实现策略复用,从而在机制层面规避了权重覆盖问题。
对持续强化学习研究的启示
从方法论角度看,ENA 提示了一种值得探索的方向:将记忆的组织维度从“任务”转向“环境动力学状态”。在现实场景中,任务边界往往模糊,而物理状态的变化更容易被检测。如果智能体能够根据检测到的动态状态检索对应的专家,就有可能在不依赖任务标签的情况下实现知识复用。
另一方面,失败驱动搜索的机制也值得关注。它把“检索不到合适策略”和“策略表现不佳”都转化为搜索信号,形成一种按需扩展记忆的闭环。这种设计在环境动态不可预知时可能比固定容量的回放缓冲更灵活,但也会带来档案规模和检索延迟的增长问题——论文未对此展开讨论,是后续研究可以补充的方向。
总体而言,这项研究为缓解灾难性遗忘提供了一个结构清晰、实验透明的候选方案。它的贡献不在于刷新性能纪录,而在于展示了物理索引专家记忆这一机制的可行性,以及它在非平稳环境中的保留能力。对于关注持续强化学习与进化计算方法交叉领域的研究者,这是一份值得细读的参考。
相关推荐
当哈利遇见莎莉:分手后睡一个人就能证明走出来了吗?
从《当哈利遇见莎莉》经典台词出发,探讨分手后用新的性关系证明自己走出来的逻辑是否成立。哈利与莎莉的辩论揭示了性经历与情感修复之间的复杂关系。

英伟达退出中国市场:黄仁勋卸任后的战略巨变
英伟达临时CEO宣布停止向中国销售芯片,标志着黄仁勋卸任后的重大战略转向。本文分析这一决策的背景、财务代价及对全球半导体格局的潜在影响。

Atomico报告:欧洲应拥有自己的科技成功故事
Atomico年度报告指出欧洲拥有众多全球最快增长公司,呼吁欧洲主动拥有并传播自己的科技成功故事,解决科技实力与国际认知的错位问题。