警惕AI教程套路:本地大模型部署的真相与误区
拆解"本地免费跑满血GPT-6"类视频的三大技术谎言,并说明本地AI部署的真实边界与正确姿势。
近期视频平台流传大量以"GPT-6""Gemini图像模型"为噱头的"本地免费部署教程",宣称几GB显存的旧电脑就能跑出与顶级闭源模型同等水平的AI。文章逐层拆解其中的硬伤:OpenAI与Google旗舰模型从未开放权重下载,所谓"本地运行官方模型"从技术前提上就不成立;真正可在低显存设备上运行的,是Llama、Qwen等开源量化模型,其能力与顶级闭源模型存在明显差距,"完全不缩水"的说法违背基本常识。本地部署开源模型本身是有价值的实践,适合离线问答与隐私保护场景,但应通过Hugging Face、Ollama官网等正规渠道获取,而非来路不明的"评论区工具包"。辨别此类内容的关键在于:核查模型名称是否真实存在、性能承诺是否符合硬件规律、资源渠道是否透明可信。
从一则"免费使用教程"说起
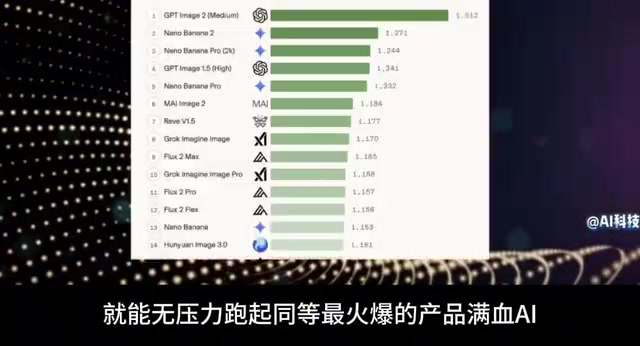
近期在视频平台上流传着大量以"GPT-6""Gemini图像模型"等名义包装的"国内免费使用教程",宣称只需一台几GB显存的轻薄本或旧电脑,就能在本地跑起"同等最火爆产品的满血AI",并且逻辑推理和代码能力"完全没有缩水"。
这类内容往往以"颠覆认知""整理宝级工具包""三分钟搞定部署"作为吸睛点,引导观众到评论区留言获取资源。作为读者,有必要冷静拆解这类宣传背后的逻辑,弄清哪些是可实现的技术、哪些是明显的夸大甚至误导。
宣传话术中的几个硬伤
"GPT-6"与"官方模型本地部署"并不成立
首要问题在于命名。目前并不存在名为"GPT-6"或"Gemini 3.8 Image2"的公开可下载模型。OpenAI 与 Google 的旗舰闭源模型从未开放权重下载,普通用户根本无法在本地"获取权重模型"来运行它们。所谓在轻薄本上跑"满血版"官方模型,从技术前提上就无法实现。
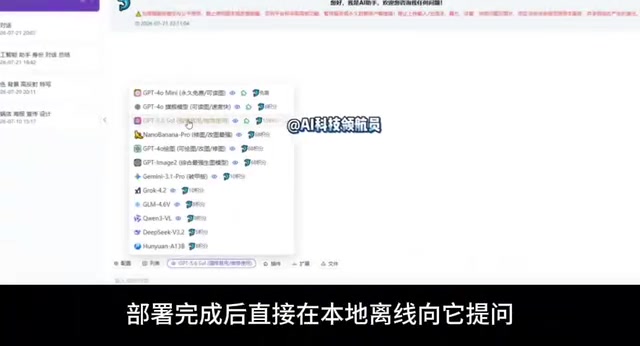
视频中含糊的表述——"获取权重模型""配置轻量化运行框架""本地图形化界面"——听起来像是在描述 Ollama、LM Studio 这类真实存在的本地推理工具,但这些工具运行的是开源模型(如 Llama、Qwen、Mistral 等),与 GPT、Gemini 是完全不同的东西。用开源模型冒充闭源旗舰产品,是这类教程最常见的偷换概念。
Ollama 是一款开源的本地大模型运行工具,支持在 macOS、Linux 和 Windows 上一键下载并运行 Llama、Qwen、Mistral 等开源模型;LM Studio 则提供了更友好的图形化界面,适合不熟悉命令行的用户。这两款工具本身合法、有价值,问题不在于工具本身,而在于部分内容创作者将它们与闭源旗舰模型混为一谈。Llama 系列来自 Meta,Qwen 来自阿里云,Mistral 来自法国同名公司,均以开放权重形式发布,任何人都可从官方渠道免费下载——这与 OpenAI、Google 从未公开权重的 GPT、Gemini 系列是本质不同的两类产品。
"几GB显存跑满血AI"违背基本常识
第二个硬伤是性能承诺。大语言模型的能力与参数规模、显存占用高度相关。真正接近顶级闭源模型水平的开源大模型,动辄数百亿参数,即便经过量化压缩,也需要相当可观的显存与内存。
在几GB显存的设备上,确实可以运行经过量化的小参数模型(例如7B以下),但其逻辑推理、长上下文处理和代码生成能力,与官方旗舰模型存在明显差距。宣传中"能力完全没有缩水"的说法,与实际体验严重不符。轻量化本地模型有其价值,但不该被包装成"平替满血GPT"。
量化(Quantization)是指将模型权重从高精度浮点数(如 FP16、BF16)压缩为低精度整数(如 INT8、INT4),以大幅减少显存占用和内存带宽需求。例如,一个 70B 参数的模型以 FP16 存储需约 140GB 显存,经 4-bit 量化后可压缩至约 35-40GB,但仍远超普通轻薄本的硬件规格。7B 参数模型经 4-bit 量化后约需 4-5GB 显存,确实可在入门级消费显卡上运行,但 7B 与 700B 级别模型在复杂推理任务上的能力差距,不会因量化工具的存在而消失。量化在压缩体积的同时不可避免地带来一定的精度损失,"能力不缩水"的说法在技术层面站不住脚。
本地部署到底能做什么
真实可行的技术路径
剥离夸大成分后,本地运行开源大模型本身是一项成熟且有意义的技术实践。借助 Ollama、LM Studio、text-generation-webui 等工具,普通用户确实可以在个人电脑上部署图形化的本地AI界面,实现离线问答、隐私保护、无需API费用等好处。
这类方案的合理预期应当是:
- 运行7B到14B级别的开源量化模型,用于日常问答、文本整理、简单代码辅助;
- 显存和内存越大,可运行的模型越大、响应越流畅;
- 离线运行意味着数据不出本地,适合注重隐私的场景;
- 生成质量与速度取决于硬件与模型选择,不存在"小马拉大车"的免费午餐。
需要警惕的风险点
评论区"留言领取工具包和配置文件"的引流方式,本身就值得提高警惕。来源不明的"整理包"可能捆绑恶意程序、挖矿脚本或需要付费解锁的陷阱。获取开源模型和工具,应当通过 Hugging Face、Ollama 官网、各模型的官方仓库等正规渠道。
Hugging Face 是目前最主流的开源模型托管平台,绝大多数公开发布的大模型权重、配置文件和使用文档都可在此找到,模型卡片中会注明许可证、参数规模和推荐硬件配置。Ollama 官网(ollama.com)提供经过整理的常用模型列表,支持一条命令完成下载与启动。通过这些渠道获取的文件来源可追溯、社区有审计,与来路不明的"整理包"相比,安全性有根本性的区别。如果一个教程要求你从网盘、评论区私信或不知名网站下载可执行文件或压缩包,应将其视为高风险操作。
如何辨别这类内容
判断一则AI教程是否靠谱,可以从几个角度入手:
模型命名是否真实存在——查证"GPT-6"这类名称是否为官方发布;性能承诺是否符合硬件常识——几GB显存跑顶级模型基本不可能;资源获取渠道是否透明——正规工具不需要"评论区私发";表述是否含糊其辞——大量堆砌"颠覆""满血""泄露级"等情绪化词汇却不给出具体模型名和参数,往往是危险信号。
本地AI是一个值得学习的方向,但学习应建立在准确信息之上。与其追逐"免费满血GPT-6"这类不存在的噱头,不如踏实了解 Ollama 与开源模型生态,根据自己的硬件选择合适的模型,才能真正在个人设备上用好本地AI。
相关推荐

Automattic高管在Mullenweg短暂离任期间签署互惠离职协议
Automattic公司CFO Mark Davies与法务负责人Andy Missan在Matt Mullenweg短暂离任期间相互签署离职补偿协议,包含一年薪资与额外股权归属,引发公司治理透明度关注。
H3 Singularity优化技巧:加速40%还能提升画质
Reddit社区分享的Minimax Singularity工作流优化技巧:在H3 Latent前插入RTX上采样器,实现40%加速同时提升画质,附参数取舍与12bit输出实践经验。
X上线Cashtags股票交易功能,社交与市场界限消融
X(原Twitter)宣布向美国用户开放通过Cashtags直接交易的功能,打通市场讨论与实际交易的通道。本文解析这一功能的运作逻辑、社交交易的机遇与风险,以及平台边界扩张背后的趋势。