警惕"GPT-6免费使用"骗局:本地部署AI的真相
用虚构产品名称包装开源小模型,是典型的信息差引流骗局。
近期流传的《GPT-6 Astra国内免费使用教程》等视频,存在两类根本性造假:其一,"GPT-6 Astra""Gemini3.8 Image2"均非真实发布的产品,属于拼凑热门关键词的虚构名称;其二,几GB显存的轻薄本在物理上无法运行能力接近云端旗舰的大模型,量化压缩虽能缩减显存需求,但代价是显著的能力损耗,"满血无缩水"是不可能成立的说法。这类内容采用制造焦虑、模糊技术细节、引导评论区私信的标准化营销套路,本质是利用用户对前沿AI的好奇心实施信息差引流,最终导向付费课程或恶意工具包。理性的做法是通过Ollama、LM Studio等正规工具部署Llama、Qwen等有据可查的开源模型,并对其能力边界保持清醒认知。
一则可疑的"免费教程"背后
近期在部分视频平台流传着诸如《GPT-6 Astra国内免费使用教程》《附Gemini3.8 Image2》这类标题的内容,宣称只需一台几GB显存的轻薄本或旧电脑,跟着画面操作三分钟,就能在本地跑起"满血"的顶级AI模型,并且逻辑推理和代码能力"完全没有缩水"。
这类内容极具诱惑力,但从技术常识和产品事实两个角度审视,其中存在大量经不起推敲的漏洞。作为读者,有必要厘清哪些是营销话术,哪些是技术现实。
名词硬伤:这些"产品"并不存在
标题中提到的"GPT-6 Astra"和"Gemini3.8 Image2",在公开信息中均无对应的正式发布产品。OpenAI 的 GPT 系列与 Google 的 Gemini 系列都有明确的官方发布节奏与命名规范,凭空出现的版本号往往是拼凑热门关键词以博取流量的手段。
把尚未发布或根本不存在的型号包装成"国内免费使用""独家教程",本质上是利用用户对前沿模型的好奇心和信息差进行引流。这类标题的第一目的通常不是分享技术,而是获取评论、私信或引导至第三方渠道。
技术层面:轻薄本跑"满血"大模型不现实
视频宣称"几GB显存的旧电脑就能无压力跑同等最火爆的产品满血AI",这与大模型的实际运行需求严重不符。
真正的旗舰级大语言模型动辄数千亿参数,即便经过量化压缩,本地部署一个能力接近云端旗舰的模型,对显存和内存的要求也远超普通轻薄本。目前个人电脑上可运行的开源模型(如各类 7B、13B 量化版本)在能力上与云端顶级闭源模型存在明显差距——这是客观的算力与参数规模决定的,绝非"营销缩水"。
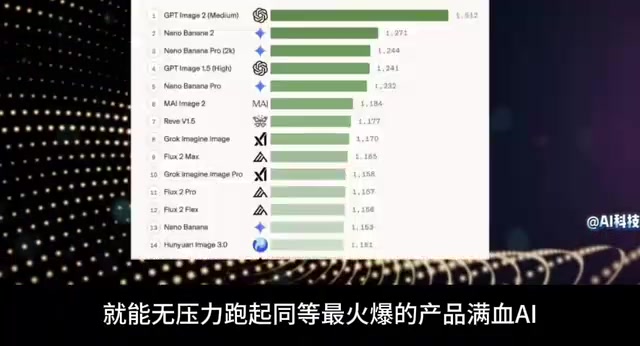
换句话说,本地小模型有其价值(隐私、离线、低延迟的特定任务),但把它等同于"满血 GPT-6"是彻头彻尾的误导。物理规律和硬件成本不会因为一句"颠覆认知"就消失。
量化压缩(Quantization)是让大模型在消费级硬件上运行的核心技术手段,其原理是将模型权重从高精度浮点数(如 FP16/BF16,每个参数占 2 字节)降低为较低精度的整数(如 INT8、INT4),从而大幅减少显存占用和计算量。以一个 70B 参数模型为例,FP16 全精度需要约 140GB 显存,而 4-bit 量化后可压缩至约 35-40GB,仍需专业级多卡配置;7B 模型经 4-bit 量化后约需 4-6GB 显存,才是普通消费级显卡勉强可以承载的范围。量化不可避免地带来精度损失,参数规模越小、压缩比越高,能力损耗越显著。因此,"几 GB 显存跑满血顶级模型"在数学上根本无法成立——它要么是极度量化、能力严重缩水的小模型,要么根本不是所声称的那个模型。
引导话术的典型套路
这类内容普遍采用高度模式化的话术结构,值得警惕:
制造焦虑与对立
开头往往先贬低"几万块的昂贵显卡",制造"你被割韭菜了"的情绪,再抛出一个"平民方案"作为解药。这种先立靶子再给答案的结构,是典型的情绪营销。
模糊技术细节
通篇强调"三分钟搞定""跟着画面一步操作""不需要复杂代码",却始终不提具体模型名称、量化方式、运行框架的真实来源。真正的技术教程会明确标注工具链和版本,而非用"整理宝级工具包"这类含糊表述带过。
引导私域转化
结尾几乎必然是"想要的在评论区留言""下期见",把用户导向评论区或私信。这一步往往是后续推销付费课程、收费"工具包",甚至骗取信息的入口。
这类内容本质上属于"信息差套利"的变体:制作者利用普通用户对大模型技术细节不熟悉的认知盲区,将已有的免费开源工具(如 Ollama + 某个量化小模型)重新包装,贴上虚构的顶级产品名称,再通过评论区或私信将流量引导至付费变现渠道。整个链路不需要任何真实技术创新,所消耗的只是用户的时间与信任。识别此类内容的快捷方法是:搜索标题中的产品名称是否有对应的官方发布公告;查看视频是否提供可验证的模型来源链接;以及判断"教程"的核心价值究竟是知识传递,还是引导行动(留言、关注、私信)。
如何理性看待本地AI部署
本地部署 AI 模型本身是一项正当且有价值的技术实践,但需要建立在真实认知之上:
- 选择开源正规模型:如 Llama、Qwen、Mistral 等有明确来源和社区支持的开源模型,通过 Ollama、LM Studio 等成熟工具部署。
- 接受能力边界:本地小模型适合隐私敏感、离线、轻量任务,不应期待它替代云端旗舰模型的综合能力。
- 警惕"免费满血"话术:任何声称能在低配设备上免费跑顶级闭源模型的说法,几乎都不成立。
- 不轻信来源不明的工具包:来路不明的"配置文件""破解权重"可能携带恶意程序或侵犯版权。
目前主流的本地部署工具链中,Ollama 是最易上手的跨平台运行框架,支持一键拉取并运行 Llama、Qwen、Mistral 等主流开源模型,自动处理量化版本选择;LM Studio 则提供图形化界面,适合不熟悉命令行的用户。国产开源模型方面,阿里的 Qwen2.5 系列在中文理解和代码任务上表现突出,7B 量化版本可在 8GB 显存设备上流畅运行,是目前本地部署性价比较高的选择之一。评估一个本地模型是否适合自己的需求,可参考 MMLU、HumanEval 等标准化基准测试分数,而非依赖"秒杀 GPT-4"这类无法验证的自我声称。
结语
对前沿 AI 的热情可以理解,但越是热门的关键词,越容易被拿来当作流量诱饵。面对"GPT-6 免费用""几GB显存跑满血AI"这类标题,保持基本的技术判断力,才能避免被收割时间、金钱乃至个人信息。真正值得投入的,是通过正规渠道了解开源模型的能力与局限,而不是追逐一个并不存在的"神话"。
相关推荐

Automattic高管在Mullenweg短暂离任期间签署互惠离职协议
Automattic公司CFO Mark Davies与法务负责人Andy Missan在Matt Mullenweg短暂离任期间相互签署离职补偿协议,包含一年薪资与额外股权归属,引发公司治理透明度关注。
H3 Singularity优化技巧:加速40%还能提升画质
Reddit社区分享的Minimax Singularity工作流优化技巧:在H3 Latent前插入RTX上采样器,实现40%加速同时提升画质,附参数取舍与12bit输出实践经验。
X上线Cashtags股票交易功能,社交与市场界限消融
X(原Twitter)宣布向美国用户开放通过Cashtags直接交易的功能,打通市场讨论与实际交易的通道。本文解析这一功能的运作逻辑、社交交易的机遇与风险,以及平台边界扩张背后的趋势。