决策模型是什么?三种类型快速解析
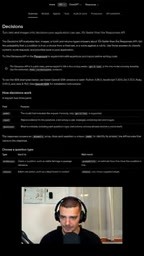
决策模型分谓词、选择、评分三类,分别回答是/否、哪一类、有多强。
文章基于一段技术讲解视频,将决策模型归纳为三种提问范式:谓词问题输出真假二元结果,适合安全检测、合规卡点等硬性规则;选择问题从预设类别中多选一,适合工单路由、意图识别;评分问题输出连续数值衡量程度,适合情感分析、风险打分与优先级排序。三类模型可组合成分层流水线:先谓词拦截明显异常,再选择归类,最后评分排序。文章强调保持模型职责单一、按问题形式选型,并指出这种拆解思维比直接调用大模型完成所有判断更可控、更易维护。
决策模型的核心价值在于用极简的方式回答简单问题,从而加速业务判断流程。根据一段技术讲解视频的梳理,决策模型对应的提问方式可归纳为三类:谓词问题(predicate)、选择问题(choice)和评分问题(score)。掌握这三类模型,就能在安全检测、意图分类、情感分析等场景中快速落地规则或轻量AI逻辑。
谓词问题:二元的“是或否”
谓词问题是最基础的决策模型,在视频中被称为“null”(可能指代某种规则语言中的空值或布尔判断)。它只输出两个结果:真或假、是或否。典型的提问包括“这个请求是否安全?”“该请求是否为正面的?”“某个条件是否成立?”这类模型适合做硬性规则卡点,例如风控拦截、合规校验。由于答案非黑即白,实现简单、响应极快,但无法表达“程度”或“类别”的细微差别。
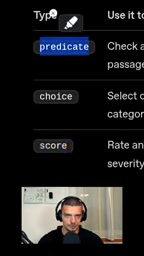
视频截图进一步强调,谓词本质上就是二元问题(binary question),不涉及中间态。在工程实践中,这类模型常被用作第一层过滤器,先快速排除明显违规或明显放行的请求,再交给更复杂的模型处理。
谓词(predicate)一词源于逻辑学与语言学,指对对象属性或关系作出断言的部分,其结果恒为真或假。在程序设计中,谓词通常表现为返回布尔值的函数,例如 is_safe(request)。工程上常见的规则引擎(如 Drools、JSON Logic)和策略语言(如 OPA/Rego)都以谓词为核心构件:每条规则即一个条件表达式,匹配则触发动作。将业务判断抽象为谓词,可直接映射到这些引擎的求值流程,实现毫秒级过滤,且规则可版本化、可审计,这正是其在风控与合规卡点中广泛使用的原因。
选择问题:分类的“是哪一种”
选择问题要求模型从预设的类别中挑出一个答案。例如“这是一张账单问题、技术问题,还是配送问题?”视频中将这种分类式提问称为choice。与谓词不同,选择问题不限于真假,而是多选一的归类任务。它适合客服工单路由、内容标签化、意图识别等场景。
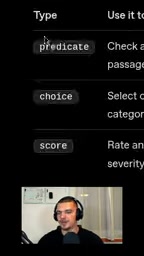
实现选择模型时,类别集合需要事先定义清楚,否则模型无法给出有效答案。视频中提到的示例覆盖了常见的业务分流需求,说明这类模型在运营自动化中非常实用。需要注意的是,选择问题默认每个样本只属于一个类别,如果存在多标签情况,则需要拆分为多个谓词问题或引入更复杂的结构。
选择问题在机器学习中对应单标签多分类任务(multi-class classification),其输出空间是互斥的类别集合。常见实现包括逻辑回归、朴素贝叶斯、梯度提升树以及基于嵌入的最近邻分类器;大模型场景下则通过提示词约束输出枚举值。关键工程约束是类别体系必须封闭且完备——若出现训练集未覆盖的新类别,模型只能强行归入已知类,导致误路由。因此实际系统常设置“其他/未知”兜底类,并配合置信度阈值,低于阈值时转人工处理。多标签场景(一条样本可同时属于多个类别)需改用 sigmoid 多输出或拆分为多个独立二分类器。
评分问题:程度的“有多强”
评分问题输出一个数值,用来衡量某种属性的强度。视频给出的例子包括“这条消息的正面程度有多高?”“这个请求的危险程度有多大?”评分模型适合情感分析、风险打分、优先级排序等需要连续值的场景。与谓词和选择相比,评分模型能保留更多信息,但也更容易受到阈值设定的影响——多少分算“危险”往往需要结合业务经验来定。
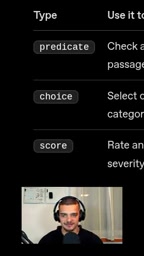
三类模型并非互斥。实际系统里常见组合用法:先用谓词模型拦截明显不安全的请求,再用选择模型归类业务类型,最后用评分模型对剩余请求做优先级排序。视频作者强调这些模型的设计初衷是“简单问题快速回答”,因此不要指望单一模型解决复杂推理;保持模型职责单一,反而更容易维护和解释。
评分问题对应回归任务(regression)或有序分类(ordinal classification)。情感分析中常用 -1 到 1 的连续分值或 1-5 星等级;风险评分则常映射为 0-100 的风险分。与分类不同,评分模型输出的是序数或连续值,因此评估指标侧重 MAE、RMSE 或 Spearman 相关系数,而非准确率。阈值设定是落地难点:通常基于业务成本曲线(如误拦与漏放的代价比)选取最优点,而非简单取中位数。此外,评分结果往往需要校准(calibration),使分数可解释为概率或稳定分位,便于跨模型、跨时间比较。
如何选择适合的决策模型
判断该用哪类模型,关键看业务问题本身的形式。如果答案只有两个且边界清晰,优先用谓词模型;如果需要从有限类别中归类,用选择模型;如果需要量化程度或排序,用评分模型。视频没有展开具体实现技术,但从描述看,这些模型可以对应规则引擎、传统机器学习分类器或轻量级AI接口,选型时需权衡准确率、延迟和可解释性。
对于AI应用开发者而言,理解这三种提问范式有助于把模糊的业务需求拆解成可执行的模型任务。例如“判断用户评论是否负面”可以拆成谓词问题(是否负面)加评分问题(负面程度),分别服务于不同的下游动作。这种拆解思维比直接调用一个大模型完成所有判断更可控,也更容易定位问题。
总体来看,决策模型的概念并不复杂,但分类清晰、落地性强。视频内容虽然简短,却点出了规则型AI与分类型AI的共同基础:先想清楚你要问的是哪一种问题,再选择合适的模型形态。
相关推荐
达芬奇如何证明太阳是热的?一段被忽视的科学史
达芬奇如何用凹面镜实验推翻亚里士多德的冷太阳理论?本文梳理这段被忽视的科学史,揭示科学思维在十五世纪的萌芽,以及达芬奇对太阳发热和生命本质的冷峻观察。
SharpLogic:用k-CNF为LangGraph路由图做形式化查错
SharpLogic开源项目将LangGraph风格的多智能体路由与重试图映射为k-CNF,用Rust内核统计死锁与失败路径(#F计数),提供Python AgentGuard钩子与CLI,在发布前做形式化门禁检查。本文分析其原理、与评测的互补关系及社区关注的建模成本问题。
PPO训练Franka机械臂抓取放置:一个强化学习入门项目
一个用PPO算法在PyBullet中训练Franka Panda机械臂完成抓取放置任务的强化学习项目,涵盖技术栈选型、任务设计难点与未来文本/语音指令交互计划,适合入门者参考。