K-prop:用时间核反向传播实现高效在线学习

K-prop通过传播时间核增益大幅降低RTRL在线训练RNN的计算与内存成本,性能媲美BPTT。
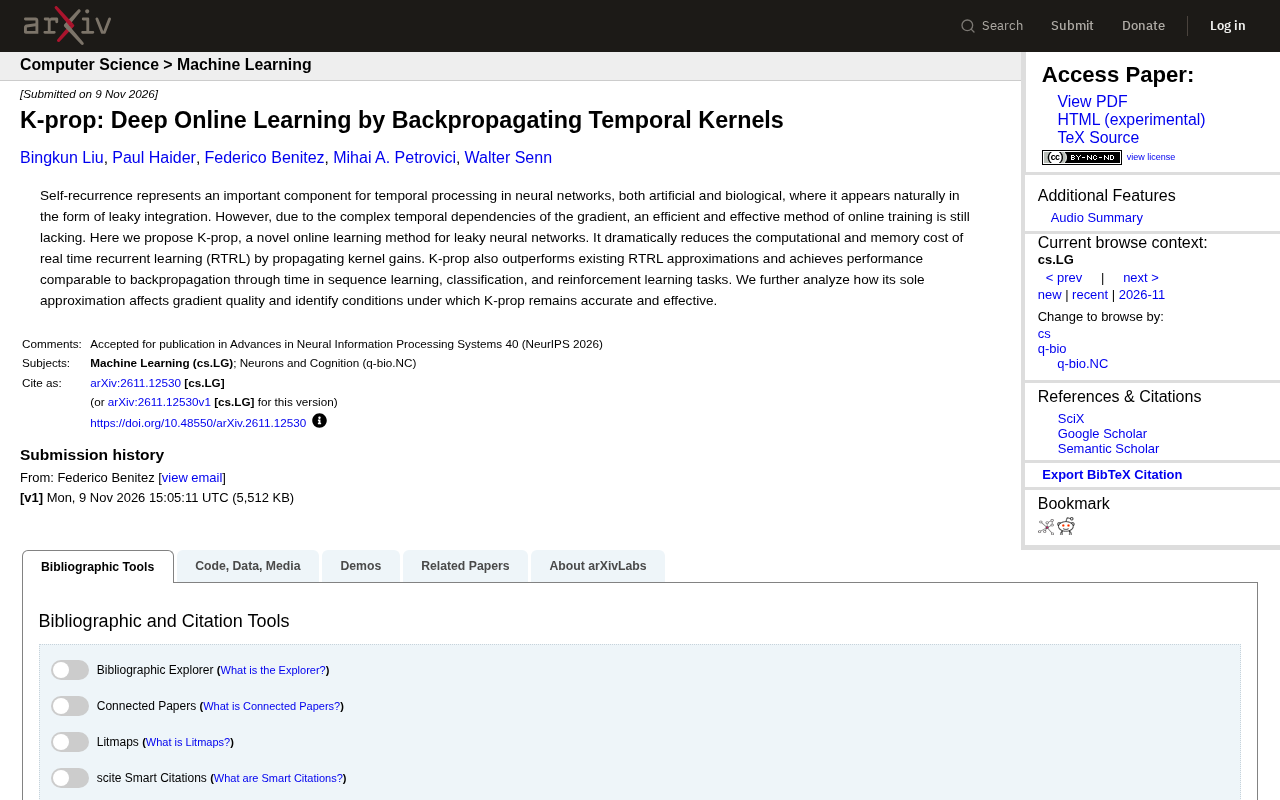
K-prop是一种新的RNN在线训练方法,旨在解决实时循环学习(RTRL)计算和内存开销过大的问题。其核心创新在于用时间核增益的传播替代RTRL中完整的雅可比矩阵传播,从而将每步开销大幅降低。K-prop仅引入一个结构化近似,论文系统分析了该近似对梯度质量的影响并给出了保持准确有效的条件。在序列学习、分类和强化学习三类任务上,K-prop优于现有RTRL近似方法,性能与BPTT相当。这为漏积分神经网络的在线训练提供了兼顾效率与性能的新范式,适用于流式数据处理和实时控制等场景。
循环神经网络(RNN)的在线训练一直面临计算和内存瓶颈——实时循环学习(RTRL)虽然支持在线更新,但代价高昂。最近一篇论文提出 K-prop,通过反向传播时间核(temporal kernels)来大幅降低 RTRL 的开销,并在序列学习、分类和强化学习任务中达到与 BPTT 相当的性能。
为什么在线学习RNN这么难?
自递归是神经网络处理时间信息的关键机制,在生物和人工系统中都以“漏积分”(leaky integration)的形式自然出现。然而,由于梯度对时间步的复杂依赖,在线训练一直缺乏高效且有效的方法。
标准的随时间反向传播(BPTT)需要展开整个序列,无法在线更新;而实时循环学习(RTRL)虽然可以逐时间步更新,但其计算和内存成本随网络规模急剧增长。此前已有多种RTRL近似方法,但往往在性能上做出妥协。
BPTT(随时间反向传播) 是训练RNN的标准方法,它将网络按时间步展开成一个深层前馈网络,然后沿时间轴反向传播梯度。其核心限制在于必须等待整个序列处理完毕才能计算梯度并更新参数,因此无法用于流式数据或在线场景。此外,展开后的计算图长度等于序列长度,长序列会带来严重的内存占用和梯度消失/爆炸问题。
RTRL(实时循环学习) 则从另一个方向解决梯度计算:它在每个时间步维护一个“敏感度矩阵”(即损失对参数的偏导数),通过递归方式逐时间步更新。理论上RTRL无需展开序列即可实现在线学习,但其敏感度矩阵的规模为参数数量乘以隐藏状态维度,计算复杂度约为O(n^4)(n为隐藏单元数),内存复杂度为O(n^3),随网络规模急剧膨胀,因此长期以来只适用于极小规模的RNN。
K-prop的核心思路:传播核增益
K-prop的关键创新在于用“核增益”(kernel gains)的传播来替代RTRL中完整的雅可比矩阵传播。具体来说,它只传播时间核的增益,从而显著降低计算和内存开销。
论文指出,K-prop“通过传播核增益,大幅降低了实时循环学习(RTRL)的计算和内存成本”。与现有的RTRL近似方法相比,K-prop表现更优,并且在序列学习、分类和强化学习任务中,性能可与BPTT相媲美。
唯一近似的代价与边界
K-prop只引入了一个近似:在传播核增益时对某些项做了简化。论文进一步分析了这个近似如何影响梯度质量,并确定了K-prop保持准确有效的条件。这意味着实践者可以根据任务特性判断是否适用K-prop,而不是盲目信任。
时间核(temporal kernel) 在RNN的梯度分析中描述的是隐藏状态对历史输入的依赖关系。具体而言,RNN的隐藏状态在时间步t对时间步k输入的雅可比矩阵可以分解为一系列时间核的乘积。RTRL需要显式传播完整的雅可比矩阵(即所有参数对隐藏状态的偏导),而K-prop观察到梯度计算中真正关键的是这些时间核的“增益”信息——即核沿时间方向的缩放因子。通过只传播这些增益(而非完整矩阵),K-prop将每步的计算和内存开销从与参数数量平方相关的量级降低到与参数数量线性相关的量级。这一思路借鉴了前向模式自动微分的思想,但通过结构化近似避免了其高昂成本。
K-prop的近似本质上是在传播核增益时忽略了某些高阶交叉项。在RNN的精确梯度中,参数对隐藏状态的影响会通过多条时间路径传播,这些路径的交叉项在完整计算中需要显式求和。K-prop将这些交叉项简化为独立的增益传播,从而避免了矩阵级别的组合爆炸。这一近似在网络激活函数饱和程度较低、时间依赖尺度较短时误差较小;当序列依赖跨度极长或网络处于高度非线性区域时,近似误差会累积。论文通过理论分析给出了误差上界与适用条件,帮助实践者判断在特定任务中是否可以采用K-prop替代BPTT。
实验表现:对标BPTT
论文在三类任务上评估了K-prop:序列学习、分类和强化学习。结果显示,K-prop不仅优于现有的RTRL近似方法,而且在这些任务上达到了与BPTT相当的性能。这对于需要在线学习的场景(如实时控制、流式预测)很关键。
与现有方法的对比
传统的RTRL精确计算梯度但成本过高;近似方法如截断RTRL或随机近似则牺牲了梯度质量。K-prop在两者之间找到了平衡点:通过传播核增益,它保留了足够的梯度信息,同时将成本降到可接受的范围。
截断RTRL 通过只保留最近若干时间步的敏感度信息来降低RTRL成本,但截断窗口之外的历史依赖被完全丢弃,导致梯度偏差随依赖跨度增大而加剧。随机近似方法(如基于采样的雅可比估计)则以无偏但高方差的方式降低计算量,需要额外的方差缩减技巧。K-prop与这些方法的本质区别在于:它不是通过丢弃或采样信息来降成本,而是通过解析地识别梯度计算中冗余的结构(完整雅可比矩阵中的低效信息)并只传播必要的增益分量。因此K-prop在保持梯度质量方面优于截断类方法,在计算确定性方面优于随机类方法,形成了独特的折中位置。
对在线学习实践的意义
K-prop的出现为在线训练漏积分神经网络提供了一个有前景的方向。它不需要展开整个序列,因此适合流式数据和实时应用。论文对近似影响的系统分析也为后续研究提供了理论基础。
不过,K-prop目前仍处于研究阶段,其在实际大规模任务上的表现、与不同网络架构的兼容性等问题仍需进一步验证。但无论如何,它展示了通过时间核反向传播来实现在线学习的一种新范式。
相关推荐
Starlink Mini 2 发布:便携卫星上网再进化
Starlink Mini 2 在 Hacker News 引发热议,帖子获 285 点、291 条评论。本文梳理便携卫星终端的迭代方向、社区讨论焦点及实际使用场景。
PewDiePie自搜趣谈:退休、自研AI模型Ajax与Linux日常
PewDiePie发布自搜视频,回应退休传闻,透露自研AI模型Ajax已达60 tokens/s、仍处BF16训练阶段,并分享Arch Linux日常、OpenAI封禁经历与对YouTube生态的疲惫感。
PewDiePie自曝失败:两年喂乌鸦计划为何翻车?
PewDiePie分享两年失败经历:试图与日本乌鸦交朋友,从喂花生到拯救倒吊乌鸦,最终被一位日本爸爸“抢走”荣耀。视频展现了与野生动物互动的真实挑战,以及创作者坦诚失败的一面。