开源AI视频换脸能做到以假乱真吗?现状与工具解析

Reddit换脸视频引发讨论:开源工具可接近但难复现商业级AI换脸效果,技术逼真化同步放大伦理风险。
一位Reddit用户展示的AI换脸视频几乎以假乱真——将《黑袍纠察队》角色「祖国人」替换入真实录像,仅在笔的遮挡处出现穿帮——并由此引发关于开源方案能力边界的讨论。文章指出,基于真实素材的局部替换之所以逼真,在于光照与背景均来自真实拍摄,核心难点在于帧间时序一致性。开源生态已有FaceFusion、SimSwap等换脸工具和AnimateDiff、Stable Video Diffusion等视频生成方案,但在精确可控的主体替换上仍与商业方案存在差距,后者依赖更大算力与大量手工调优。遮挡物与主体的复杂交互是当前AI编辑的技术短板,也是识别伪造内容的实用线索。文章最终指出,换脸技术的逼真化在降低创意门槛的同时,也放大了虚假信息与肖像权侵犯风险,「眼见不一定为实」的警惕意识愈发必要。
一个Reddit提问背后的真实焦虑
近日,一位Reddit用户发布了一段令人印象深刻的视频编辑作品,并抛出了一个直击当下AI视频生成核心的问题:有没有开源模型能实现这种级别的编辑效果?
据这位用户描述,视频素材取自一段真实录像,创作者将剧集《黑袍纠察队》中的角色「祖国人」(Homelander)替换到了原视频人物身上。用他的话来说,「这种细节简直疯狂,如果不是那个笔的穿帮,基本上跟真的一模一样了」。
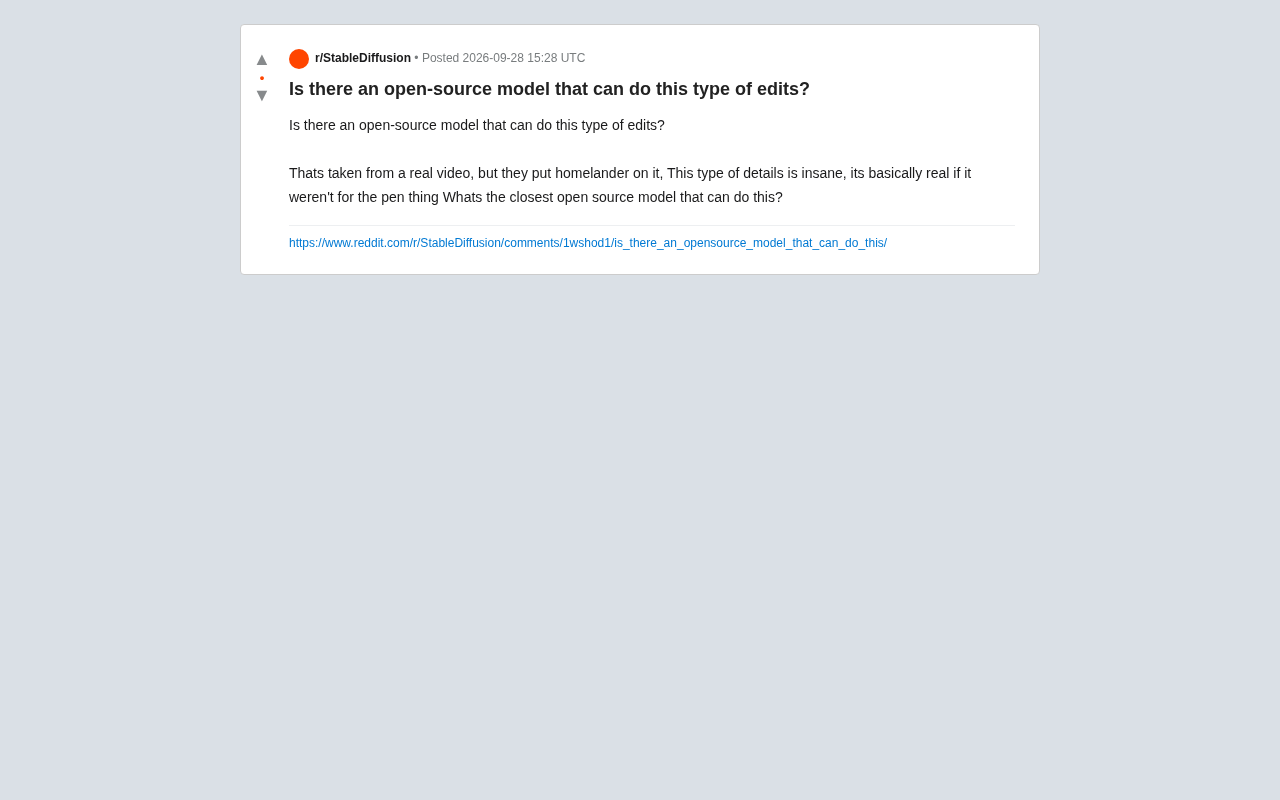
这个提问看似简单,实则触及了当前生成式AI领域最受关注也最具争议的话题之一——面部替换与视频编辑技术,究竟发展到了什么程度?开源社区能否复现商业级效果?
为什么这类编辑效果「以假乱真」
从用户的描述可以拆解出几个关键技术要素。首先是基于真实视频的编辑,而非从零生成整段视频。这种「以真实素材为底、局部替换主体」的方式,本身就比纯文本生成视频更容易达到逼真效果,因为光照、运动轨迹、背景环境都来自真实拍摄。
其次是时序一致性。视频换脸最难的部分不在于单帧画面,而在于连续帧之间面部表情、头部转动、光影变化的稳定性。用户特别提到「细节疯狂」,说明这段作品在动态一致性上表现优异,没有出现常见的闪烁、边缘抖动或身份漂移问题。
值得关注的是那个被用户点出的「笔的穿帮」——这恰恰说明当前技术的短板:AI在处理遮挡物与被编辑主体的交互时仍会出错。当物体(如笔)经过面部或与主体产生复杂遮挡关系时,模型容易露出破绽。这是识别AI编辑内容的一个实用线索。
时序一致性在技术实现层面通常依赖两种策略:一是在推理时对相邻帧共享注意力权重(如 TokenFlow、Video-P2P 等方法),使模型在生成每一帧时都能「看到」前后帧的上下文;二是在后处理阶段使用光流估计(Optical Flow)将前一帧的像素信息按运动方向传播到当前帧,从而抑制帧间差异。「身份漂移」(Identity Drift)是换脸视频中常见的另一类瑕疵:当视频时长较长或头部转角较大时,替换后的面部身份特征会逐渐偏离参考人脸,这本质上是模型的特征空间在时间轴上累积误差的结果。高质量商业方案通常通过更大的训练数据规模和专门的时序损失函数来缓解这一问题,这也是开源方案难以在短期内完全追平的核心差距之一。
开源社区的现有方案
针对这类需求,开源生态确实积累了一批可用工具,尽管与顶级商业方案仍有差距。
面部替换类
以 Roop、SimSwap、FaceFusion 为代表的换脸工具,专注于将一张目标人脸迁移到视频主体上。它们对硬件要求相对友好,社区活跃度高,但在极端角度、复杂光照下的表现有限,通常需要后期修补。
Roop 的核心原理是基于 InsightFace 人脸检测与 GFPGAN/CodeFormer 超分辨率增强的流水线,能在单张参考照片的情况下完成换脸,无需训练。SimSwap 则引入了「身份注入模块」(Identity Injection Module),在特征层面将目标人脸的身份信息融入生成过程,对姿态变化的鲁棒性更强。FaceFusion 是目前社区维护最积极的整合方案,将检测、对齐、替换、增强等步骤统一到单一界面,支持图片和视频批量处理,但其传播与使用在多个地区涉及肖像权与深度伪造相关法规,使用者需注意合规边界。这三类工具均属于「图像级换脸」而非「视频原生生成」,因此在帧间一致性上通常需要额外的时间序列平滑或后处理才能减少闪烁。
视频生成与编辑类
更前沿的方向是基于扩散模型的视频编辑,例如 Stable Video Diffusion 及其衍生生态、AnimateDiff 等。这些模型能实现更自然的动态生成,但在「精确保留原视频结构、仅替换特定主体」这一具体任务上,可控性仍是难题。
AnimateDiff 的设计思路是在现有图像扩散模型(如 Stable Diffusion 1.5)中插入一个可插拔的「运动模块」(Motion Module),该模块通过在时间维度上施加注意力机制来学习帧间运动规律,从而让原本只能生成单帧图像的模型获得生成连贯视频的能力,且不需要重新训练整个基础模型。Stable Video Diffusion(SVD) 则是 Stability AI 基于图像条件的视频扩散模型,以单帧图像为起点生成短视频片段,在相机运动一致性上表现突出。然而,这两类模型的根本设计目标是「生成」而非「精确编辑」——它们并不原生支持「锁定背景、仅替换前景人物」的受控编辑,若要用于换脸场景,通常需要结合 ControlNet、深度图或光流约束等额外条件注入机制才能提升可控性。
现实差距
必须承认,Reddit用户所展示的那种「几乎无法分辨」的效果,往往依赖商业闭源工具、大量算力,以及创作者大量的手工调优。开源方案能接近,但要完全复现顶级效果,通常需要组合多个工具并投入可观的调试时间。
技术进步背后的双刃剑
这条帖子在社区引发讨论,也折射出一个更深层的议题。当换脸技术逼真到「只有一个笔的破绽」时,其被滥用于虚假信息、伪造证据、侵犯肖像权的风险也在同步放大。
用户口中的「疯狂细节」是技术魅力,也是社会隐忧。识别AI编辑内容的能力——比如留意遮挡穿帮、边缘瑕疵、不自然的物理交互——正变得越来越重要。
对于创作者而言,开源工具降低了创意表达的门槛;但对整个社会而言,如何在技术开放与伦理约束之间取得平衡,是比「哪个模型最强」更值得思考的问题。
写在最后
回到最初的提问:有没有开源模型能做到这种编辑?答案是——能接近,但难以完全复现。开源生态提供了FaceFusion、SimSwap、AnimateDiff等一系列工具作为起点,配合足够的算力和调优,可以产出相当逼真的结果,只是与顶级商业方案之间仍存在一道「笔的穿帮」般的细微鸿沟。
这道鸿沟正在快速缩小。对技术爱好者来说,这是激动人心的时刻;对内容消费者来说,或许该保持一份「眼见不一定为实」的警惕了。
相关推荐

WorkBuddy全流程教程:从零搭建AI办公自动化智能体
WorkBuddy 全流程教程精讲:从下载安装、三种工作模式到多模态绘本视频实战,再到专家团搭建智能体与工作流配置,帮你用低成本 AI Agent 实现办公自动化。

WorkBuddy智能体全攻略:7天从入门到自动化实战
基于B站256集WorkBuddy全套精讲课程,系统拆解腾讯AI办公工作台的核心能力:Agent原理、Skill封装、连接器跨平台、定时自动化、知识库与零代码开发,附学习路径建议。

8个AI账号翻车7个:我用AI干活的真实复盘
B站8个AI运营账号仅1个跑通。本文拆解"演AI"与"用AI干活"的本质区别,分析5条视频217万播放背后的产能控制、评论区运营和交付节奏策略。