开源AI与开放模型学习清单:入门到进阶的资源指南
一份开源AI阅读清单的解读:厘清开放权重与真正开源的边界,提供系统化学习路径。
文章围绕近期在 Hacker News 上引发关注的「开源AI与开放模型阅读清单」展开,核心价值在于厘清两个常被混淆的概念:「开放模型」仅指权重可下载,而「开源AI」要求同时公开训练数据、代码和完整流程,两者在可审计性和合规适用性上有本质差距。许可证是选型中容易被忽视的关键维度,不同协议对商用、修改和再分发的限制差异显著。文章还梳理了成熟阅读清单通常覆盖的四大维度——基础理论、代表模型、工程部署和社区治理——并建议读者根据自身目标(原理理解、动手部署或行业趋势)有针对性地使用清单,将其作为可持续回溯的参考索引,而非一次性通读的材料。
开源AI正在重塑整个人工智能生态。从早期封闭的商业模型主导,到如今开放权重模型层出不穷,开发者和研究者对系统性学习资源的需求越来越迫切。近期在 Hacker News 上出现的一份「开源AI与开放模型阅读清单」引发了社区关注,它试图为想要深入这一领域的人提供一条清晰的学习路径。
为什么需要一份开源AI阅读清单
开源AI领域信息高度分散。论文发布在 arXiv,模型权重托管在 Hugging Face,工程实践散落在各类博客和 GitHub 仓库,而真正有价值的讨论往往埋没在社区论坛中。对于初学者而言,缺乏一个结构化的入口,很容易在海量资料中迷失方向。
一份精心整理的阅读清单,本质上是在做「信息降噪」的工作。它把最具代表性的论文、最实用的工具文档和最有洞见的分析文章聚合在一起,让学习者能够按图索骥,而不是在搜索引擎里反复试错。这也是这类资源在技术社区持续受到欢迎的原因。
开放模型与开源AI的区别
很多人容易混淆「开源AI」和「开放模型」这两个概念,但它们在实践中存在重要差异。
开放权重不等于完全开源
所谓「开放模型」(Open Models),通常指模型的权重可以自由下载和使用,比如 Meta 的 Llama 系列、Mistral 的多个版本等。但开放权重并不意味着完全开源——很多此类模型并未公开完整的训练数据、训练代码和详细的训练流程。
真正意义上的「开源AI」要求更高:不仅要开放模型权重,还应公开训练数据来源、数据处理方法、训练脚本以及可复现的完整技术细节。这种区别直接影响到模型的可审计性、可复现性以及在合规场景下的适用性。
开源软件运动的鼻祖——自由软件基金会(FSF)和开源促进会(OSI)——长期以来对「开源」有着严格定义:源代码必须可自由获取、修改和再分发。当这套标准被迁移到AI领域时,"源代码"的内涵急剧扩展。训练一个大语言模型所需的要素至少包括:模型架构代码、训练数据集、数据清洗与预处理脚本、训练超参数与配置、以及最终的模型权重。仅公开其中一项(权重)就声称「开源」,在学术和法律层面均存在争议。OSI 已于2024年正式发布《开源AI定义》(OSAID v1.0),明确要求开源AI系统必须提供足够让他人复现训练的数据信息,这一标准使得 Llama 3、Gemma 等知名「开放模型」并不符合严格的开源定义。
许可证是关键变量
阅读这类清单时,一个容易被忽视但至关重要的维度是许可证(License)。不同的开放模型采用截然不同的授权条款,有的允许商业使用,有的仅限研究用途,有的则对使用者规模设置了限制。理解这些差异,对于任何计划将开放模型投入生产环境的团队都是必修课。
当前开放模型的许可证生态极为复杂,几种常见类型值得重点了解。Llama 系列自定义协议:Meta 为 Llama 2/3 设计了专属许可证,月活用户超过7亿的产品需要单独向 Meta 申请授权,且禁止将模型输出用于训练其他大语言模型。Apache 2.0:是最宽松的许可证之一,允许商用、修改和分发,Mistral 7B、Falcon 等模型采用此协议。CC-BY 系列:常见于训练数据集,不同子类(BY、SA、NC、ND)组合出截然不同的使用限制,NC(非商业)版本在生产环境中无法使用。RAIL(负责任AI许可证):新兴的AI专用协议,在开放使用的同时附加了禁止特定有害用途的行为条款。合规团队在评估开放模型时,需逐条核对许可证文本,而非仅凭「开源」标签做决策。
学习清单通常覆盖哪些内容
一份成熟的开源AI阅读清单一般会围绕几个核心维度展开。
基础理论与关键论文:涵盖 Transformer 架构、预训练与微调方法、RLHF(基于人类反馈的强化学习)等奠基性研究。这些是理解现代大模型运作原理的地基。
代表性开放模型:介绍主流的开放权重模型家族及其技术特点,帮助读者建立对当前生态版图的整体认知。
工程实践与部署:包括模型量化、推理优化、本地部署方案等实操内容。对于希望把模型真正跑起来的开发者,这部分往往最具价值。
社区与治理讨论:涉及开源AI的伦理、安全、许可证争议等话题。随着开放模型能力越来越强,这些讨论的重要性也在同步上升。
RLHF(Reinforcement Learning from Human Feedback,基于人类反馈的强化学习)是现代对话式AI模型的核心对齐技术,由 OpenAI 在 InstructGPT 论文(2022)中系统性阐述。其基本流程分三步:首先用监督学习微调基础模型(SFT),让模型学会遵循指令;其次训练一个奖励模型(Reward Model),由人类标注者对模型输出进行偏好排序,让奖励模型学习「什么样的回答更好」;最后用近端策略优化(PPO)算法以奖励模型为信号,持续更新语言模型的参数。RLHF 的主要挑战在于人工标注成本高昂、奖励模型可能被「欺骗」(reward hacking),以及流程复杂难以复现。因此社区涌现出多种简化替代方案,包括 DPO(直接偏好优化)、RLAIF(用AI反馈替代人类反馈)等,这些方法在开源训练框架(如 TRL、OpenRLHF)中均有实现。
如何高效使用这类资源
面对一份庞大的阅读清单,盲目从头读到尾并非最佳策略。更有效的方式是先明确自己的目标——是想理解原理、动手部署,还是关注行业趋势——然后有针对性地选取相关章节。
对于工程导向的读者,建议从工具文档和部署实践入手,边做边学;对于研究导向的读者,则可以从经典论文切入,逐步建立理论框架。清单的价值不在于「读完」,而在于成为一个可以随时回溯的参考索引。
值得提醒的是,AI领域迭代极快,任何静态清单都会面临过时的风险。因此在使用时应结合最新的社区动态,把清单当作起点而非终点。
结语
这份在 Hacker News 上获得关注的开源AI阅读清单,反映出社区对系统化学习资源的真实需求。开源AI的魅力恰恰在于其开放性——任何人都可以站在前人的肩膀上继续探索。对于想要进入这一领域的人来说,找到一个可靠的起点,往往比盲目积累更为重要。
相关推荐
JPEG XL之争:技术领先为何难敌生态现实
JPEG XL之争:技术领先为何难敌生态现实
JPEG XL技术领先却面临采用困境,本文剖析其与AVIF的路线之争、浏览器支持博弈及生态惯性,解读为何最优图像格式未必能成为Web主流。
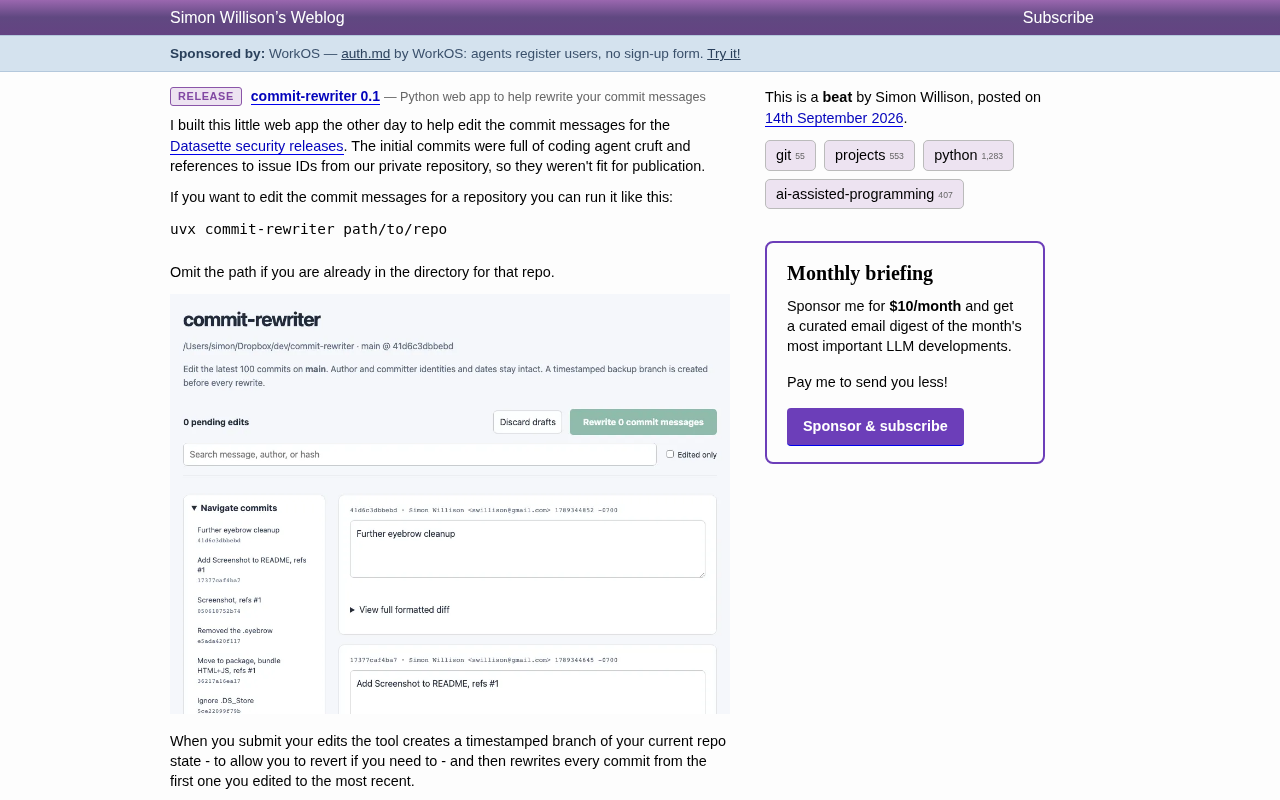
commit-rewriter 0.1:批量重写 Git 提交信息的开源工具
commit-rewriter 0.1 是 Simon Willison 开源的 Git 提交信息批量重写 Web 工具,通过 uvx 一键运行,可清理 AI coding agent 生成的冗余内容和私有引用,并自动创建时间戳备份分支支持回退。
shot-scraper 1.12 新增 WebP 支持:截图体积大幅缩小
shot-scraper 1.12 版本新增 WebP 截图支持,通过 --quality 参数灵活控制画质,相比 JPEG 和 PNG 可显著减小文件体积,适合自动化截图工作流。