开源本地决策模型:比云端API快近20倍
Laya是专注本地高频决策的轻量开源模型,速度比云端API快约20倍,延迟仅9毫秒。
Laya是一款开源本地决策模型,针对云端API高延迟、高成本、数据隐私风险等痛点而设计。与通用大语言模型不同,它专注于分类、优先级判断等结构化决策任务,而非生成长篇文本,因此能在本地以9毫秒延迟、每秒86次的速度完成推理,比云端方案快近20倍。数据全程不离本机,兼顾隐私合规与响应速度。部署极为简便,pip一条命令即可安装,采用MIT协议完全免费,并支持对接主流调用链路。Laya的出现代表了一种AI落地新思路:将高频、模式固定的"判断"任务从云端大模型中剥离,交由本地专用模型处理,复杂生成任务仍保留给云端,各取所长、降本增效。
云端AI API的热度居高不下,但真正能用上的人并不多——申请、排队、按token计费,每一步操作都要经历一次网络往返。对于需要高频、低延迟决策的场景来说,这套流程的成本和延迟都难以接受。一款名为Laya的开源本地决策模型试图给出另一种答案。
云端API的隐性成本
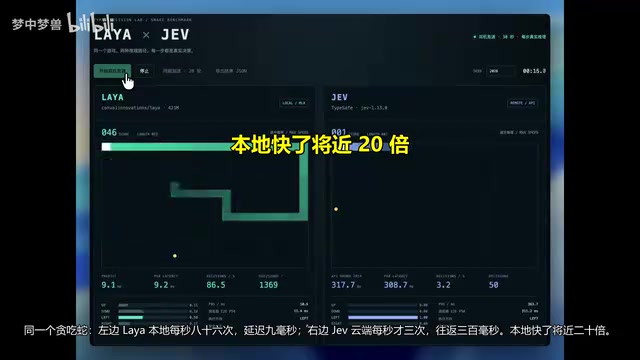
云端推理最直观的痛点是延迟。据B站UP主的实测演示,同一个贪吃蛇任务中,本地方案每秒可完成86次决策,延迟仅9毫秒;而依赖云端API的方案每秒只能跑3次,单次往返高达300毫秒。这意味着本地推理的速度几乎是云端的20倍。
这种差距在需要连续、密集决策的应用里会被急剧放大。云端方案每一步都要等待网络往返,加上按token收费的计价方式,长期运行的成本和不确定性都很高。对于实时性要求苛刻的任务,300毫秒的往返延迟基本宣告了云端推理的不可用。
Laya:只做判断,不生成文本
Laya的定位很清晰——它是一个专注于"判断"而非"生成"的本地决策模型。与通用大语言模型不同,它不负责生成长篇文本,而是聚焦于快速给出结构化的决策结果。这种功能上的收窄,正是它能够在本地高速运行的关键。
演示中,作者将一段工单文本交给Laya,一次性提出三个问题:应该归到哪个类别、紧急程度如何、客户会不会流失。Laya在本地即时给出了带置信度的答案。整个过程数据不出本机,既保证了响应速度,也规避了敏感数据上传云端的隐私风险。
从技术架构角度看,Laya这类"判断型"模型与通用大语言模型(LLM)的根本区别在于输出空间的设计。通用LLM的输出是开放式的token序列,每次推理需要自回归地逐token生成,计算量随输出长度线性增长。而决策模型的输出是封闭的——类别标签、置信度分数、枚举值等结构化结果,本质上是一次前向传播的分类或回归任务,不存在自回归的迭代开销。这使得模型参数量可以大幅压缩,同时推理延迟保持稳定可预测,不受"输出多少字"的影响。置信度(confidence score)是其输出的重要组成部分,它反映模型对当前判断的把握程度,可供下游系统决定是否需要人工复核或升级到更强的模型处理。
部署门槛极低
对开发者而言,Laya的另一大吸引力是部署简单。它支持通过pip一条命令自动完成安装,无需复杂的环境配置,跑起来同样只需一条命令。这种"开箱即用"的体验降低了本地部署模型的技术门槛。
此外,Laya采用MIT开源协议,完全免费,并且可以对接Cloud、Core等外部调用链路。这意味着它既能作为独立的本地决策组件,也能嵌入到更大的工作流中,作为整个系统里负责快速判断的一环。
MIT开源协议是软件领域最宽松的许可证之一,允许用户自由使用、修改、分发,甚至集成到商业产品中,唯一的要求是保留原始版权声明。这对企业用户尤为重要——意味着无需支付授权费,也不必担心未来因许可证变更(如近年部分开源项目从宽松协议转向限制性协议的情况)而影响生产环境的合规性。Cloud、Core等调用链路的支持则暗示Laya设计上兼容主流的AI编排框架,可作为工作流中的一个标准化节点,与其他组件通过统一接口协作,而不是一个孤立的独立工具。
本地决策模型的价值场景
Laya这类工具的出现,反映了AI应用落地过程中的一个趋势:并非所有任务都需要动用重量级的云端大模型。对于分类、优先级判断、风险预警这类高频且模式相对固定的决策任务,一个轻量、专用的本地模型往往更高效、更经济,也更安全。
工单分类、客户流失预警这类企业内部场景,恰恰对数据隐私和响应速度都有较高要求。本地部署既能满足数据合规,又能做到毫秒级响应,比调用云端API更符合实际需求。当然,本地模型的能力边界也很明确——它擅长判断而非生成,复杂的内容创作和推理仍然需要更大的模型来承担。
对于正在评估AI落地方案的团队来说,Laya提供了一个值得参考的思路:把"判断"和"生成"拆开,用本地专用模型处理高频决策,用云端大模型处理复杂生成,各取所长。
注:本文基于单一来源的演示内容整理,实际性能数据以官方文档和自行测试为准。
相关推荐

Gemini 4 Neon评测:跑分比肩Carbon,API定价与额度解析
Google Gemini 4 Neon正式上线,跑分紧咬Carbon,API定价3/15为Hydrogen两倍。本文汇总B站UP主实测:Neon可平替90% Carbon场景,AntiGravity中额度消耗仅为Carbon三分之一,并解析订阅渠道限制与2API封号风险。

Gemini 4 Helium或将至?Google订阅限制松绑信号
Google团队成员预告发布将继续,社区推测Gemini 4 Helium(Flash Lite)或成下一款模型;订阅封禁争议获回应,产品负责人以「Soon」暗示可能开放限制。本文梳理Gemini动向、OpenAI Coding Agent与风险管理、豆包实时音视频API及算力商业动态。

AI辅助React开发实战:视频应用优化与错误处理
14年经验开发者演示如何用AI辅助优化React视频应用:通过ImageKit将视频从80MB压缩至5MB(约94%),并实现可靠的错误处理与重试机制。包含与AI协作的规划、代码理解和验证方法。