开源大模型榜首之争:两榜单数据深度审计

两大榜单虽同列 MiMo-V2.6-Pro 开源第一,但统计证据薄弱、排序漂移、开源标签矛盾,引用前需五步审计。
文章审计了 BenchLM 与 Artificial Analysis 两份榜单在 10 月 19 日关于开源权重模型的排名数据。虽然两者都将 MiMo-V2.6-Pro 列为第一,但 BenchLM 将该行标记为 Estimated,条件区间宽达 19.45 分,且前九名区间全部重叠,排名置信度并未确立。九个匹配模型的 Kendall's tau 仅 0.61,中间段排名不稳定,DeepSeek V4.1 Flash 1017 从第六升至第三。更严重的是开源标签分歧:Kimi K3 在 Hugging Face 上公开却被 BenchLM 排除,Qwen3.8 Max 被两个榜单分别标记为开源和闭源,MiMo-V2.6-Pro 的检查点对应关系不明。文章还指出榜单间一致性可能因共享外部指数而存在循环验证,并给出引用排名前的五步审计法。
榜首共识下的统计迷雾
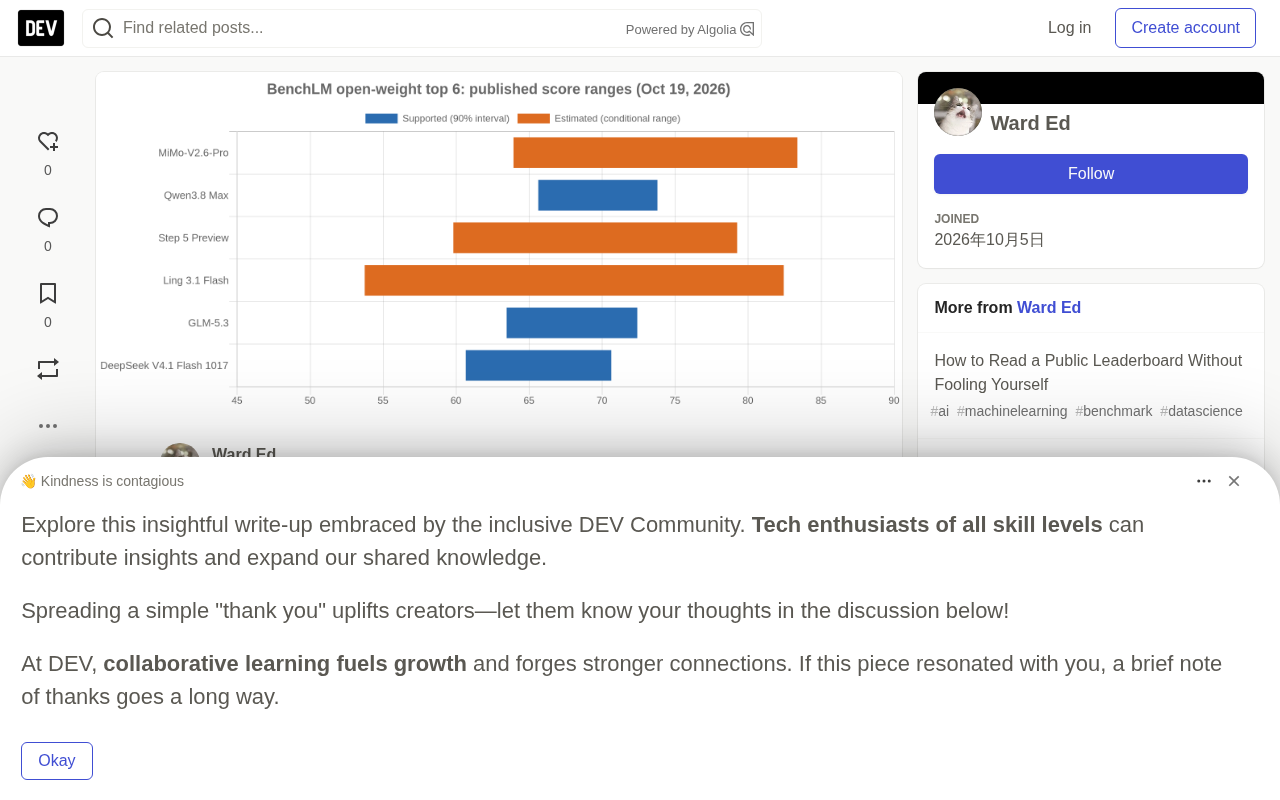
当两个主流榜单都将 MiMo-V2.6-Pro 列为开源权重模型第一时,这个结论看起来板上钉钉。但逐行审计后,情况远没有这么简单。BenchLM 和 Artificial Analysis 在 10 月 19 日的数据均显示 MiMo-V2.6-Pro 居首,前者给出 73.7 分,后者给出 46.3 的智能指数。问题藏在细节里:BenchLM 将这一行标记为Estimated(估算),并给出了 63.92 到 83.37 的条件区间。这个区间的宽度达到 19.45 分,而同一张表中标记为 Supported 的行,区间宽度仅为 8.2 到 10.0 分。
更关键的是,排名前九的模型区间全部相互重叠。36 对区间无一例外,即便加入第十行,45 对区间也全部重叠。BenchLM 自己也在页面上写明,MiMo-V2.6-Pro“拥有更高的点估计”,但“条件区间并不能确立排名置信度”。
因此,更准确的表述是:在证据薄弱的前提下,MiMo-V2.6-Pro 拥有开源权重行中最高的点估计值。这比“最佳开源模型”弱得多,但却是页面数据唯一支持的结论。需要留意,条件区间与 90% 置信区间采用不同的构造方式,直接比较二者宽度并不完全对等。
条件区间与置信区间的区别:条件区间(conditional interval)通常是在给定模型已被选为“头部候选”或给定某种筛选条件后构造的区间,它不覆盖“该模型是否真的优于其他模型”这一不确定性来源。而 90% 置信区间(confidence interval)试图覆盖参数的真值,其构造考虑了抽样分布。两者宽度不可直接比较:条件区间往往更窄,因为它忽略了模型选择带来的多重比较问题。在榜单场景中,即使两个模型的条件区间重叠,也不意味着它们没有显著差异;反之,条件区间不重叠也不直接等于排名置信度高。审计时应关注区间是否针对“排名”这一目标构造,而非仅针对“分数”构造。
第一名之后,排序开始漂移
将 BenchLM 开源前十行与 Artificial Analysis 按模型名称匹配,九个模型成功对应(“dots3-note Preview”在后者数据中缺失)。仅对这九个模型分别排名后,Kendall's tau 为 0.61,一致对 29 个,不一致对 7 个。这意味着整体趋势相似,但中间段并不稳定。
最典型的例子是 DeepSeek广告 V4.1 Flash 1017,它在 BenchLM 上排第六,在 Artificial Analysis 上跃升至第三。如果以“前五”为筛选线,Ling 3.1 Flash 在 BenchLM 上入围,在 Artificial Analysis 上落选;DeepSeek V4.1 Flash 1017 则相反。
Artificial Analysis 自身的头部也相当紧凑:开源权重前五名的指数分别为 46.3、45.1、44.8、43.7 和 43.6,相邻差距仅 1.2、0.3、1.0 和 0.1 个指数点,整个前五跨度不过 2.7 分。页面每行只显示一个数字,无法判断 0.1 的差距是否真实存在。
开源标签的分歧比排名更大
比排序噪声更值得关注的是成员资格问题。“开源权重”是每个聚合平台自行标注的标签,而这些标签彼此矛盾。
Kimi K3 的缺席。在 BenchLM 上,Kimi K3 得分 69.92,总排名第 18(共 226 个模型),但在开源列表中不见踪影,原因是其权重访问被标记为“待定”,且“尚无经过验证的权重发布”。按点估计,它本应排在开源列表第二,略高于 Qwen3.8 Max 的 69.7。然而在 Hugging Face Hub 上,moonshotai/Kimi-K3 仓库公开且未设门槛,包含 96 个 safetensors 分片,采用名为 kimi-k3 的自定义许可证,下载量超过 100 万次。Artificial Analysis 则将同一模型标记为 isOpenWeights: true,智能指数 43.6。
Qwen3.8 Max 的矛盾。BenchLM 将其列为开源权重第二,但 Artificial Analysis 将其标记为 isOpenWeights: false。在 Hub API 上匿名请求 Qwen/Qwen3.8-Max 和 Qwen/Qwen3.8-Max-0902 均返回 HTTP 401(Hub 对不存在的仓库也返回此码),无法确认仓库存在。两个榜单可能指向不同快照,这本身就是问题:没有检查点标识符的相同显示名称,不是稳定的键。
MiMo-V2.6-Pro 的检查点疑云。Hub 上存在 XiaomiMiMo/MiMo-V2.6-Pro-RL(MIT 许可证,公开,132 个 safetensors 文件),但名为 MiMo-V2.6-Pro 的仓库无法匿名解析。被评测的行是否对应 -RL 检查点,两个榜单页面均未说明。
Hub API 的 401 响应:Hugging Face Hub 对匿名请求不存在的仓库、私有仓库或需要认证的仓库统一返回 HTTP 401(Unauthorized),而非 404(Not Found)。这种设计避免泄露私有仓库是否存在,但也意味着仅凭 401 无法区分“仓库不存在”与“仓库存在但需权限”。要确认仓库存在性,需使用带 token 的认证请求,或通过 Hub 的搜索/模型列表接口交叉验证。文中 Qwen/Qwen3.8-Max 返回 401 只能说明匿名无法解析,不能直接推断仓库不存在;同理,MiMo-V2.6-Pro 无法匿名解析也不等于其权重未发布。审计时应区分“匿名不可见”与“确认不存在”。
独立证据还是循环验证?
BenchLM 的方法论页面提到,BenchAlign 在组合前会“校准基准协议、人类偏好信号和外部综合指数”。如果这些外部综合指数中包含了另一个榜单,那么两者的一致性就带有循环成分,tau 值 0.61 会高估独立确认的程度。页面并未列出外部指数的具体名称,因此无法判断。
一个无法分解的一致性,其证据强度弱于一个可以解释的分歧。两个榜单的输入类型也不同:Artificial Analysis 发布一个基于固定评估集的指数;BenchLM 追踪 640 个基准,在六个支柱上对子集评分,将厂商自报数字排除在排名之外,并用学习估计填补空缺。不同的输入产生相似的输出,这有些令人安心;但不同的输入产生不同的开源标签,则是需要自行核查标签的信号。
Kendall's tau 与秩相关:Kendall's tau 衡量两个排名之间的一致性,取值从 -1(完全相反)到 1(完全一致),0 表示无关。其计算基于“一致对”与“不一致对”:若两个榜单中模型 A 都排在 B 前,则为一致对;若一个榜单 A 在前、另一个 B 在前,则为不一致对。tau = (一致对 - 不一致对) / 总对数。样本量小时,tau 的抽样波动很大:九个模型共有 36 对,tau=0.61 的标准误约为 0.12,95% 置信区间大致为 0.37 到 0.85,因此“中等偏强一致”的结论并不精确。此外,tau 只反映整体单调关联,对头部或中间段的局部换位不敏感,需结合具体移动行解读。
引用排名前的五步审计法
- 阅读证据标签。标记为“Estimated”或“条件区间”意味着排名依赖薄弱证据,不要在此基础上写“最佳”。
- 比较区间而非点值。对头部行运行区间重叠检查,如果全部重叠,应表述为“无可分辨差异”。
- 解析检查点。找到该行指向的确切 Hub 仓库或 API 模型 ID。“Max”或“Pro”等显示名称无法标识检查点。
- 验证开源标签。确认权重文件存在、仓库是否设门槛、许可证实际允许什么。自定义许可证不等同于 MIT 或 Apache-2.0。
- 交叉核对另一个来源。计算秩相关,然后查看具体分歧,因为移动的行才是有意思的行。
本次审计的局限
- 这是 10 月 19 日的单次快照,两个页面持续更新。
- Artificial Analysis 的数值来自其排行榜页面内嵌的行数据,而非文档化 API,解析该 JSON 较为脆弱,页面上也未看到指数版本号。
- 站点间的名称匹配是手动完成的,BenchLM 十行中匹配了九行,表中的排名是这九行内部的位次,而非完整列表上的排名。
- 九个样本对于秩相关而言偏小,tau=0.61 应视为粗略指标。
- 未亲自运行任何模型,所有分数均为聚合平台公布值。
常见问题
2026 年 10 月最佳开源权重模型是什么? 取决于榜单和“开源”的定义。MiMo-V2.6-Pro 在两个榜单上均拥有最高点估计(BenchLM 73.7,Artificial Analysis 46.3),但 BenchLM 将该行标记为 Estimated,区间宽达 19.45 分,因此其对后续行的领先在统计上并未确立。
为什么 Kimi K3 不在 BenchLM 的开源列表中? BenchLM 记录其权重访问为待定,并表示没有经过验证的权重发布,尽管 Hugging Face 仓库是公开的。Artificial Analysis 则将同一模型标记为开源权重。
榜单行上的“Estimated”是什么意思? 在 BenchLM 上,它意味着该行依赖的证据比“Supported”行更薄弱,后者满足该站点的独立证据规则。Estimated 行显示的区间是条件区间,BenchLM 声明其不能确立排名置信度。
如何检查一个模型是否真的开源权重?
在 Hugging Face Hub 上解析其确切仓库,确认权重文件存在且仓库未设门槛,并阅读许可证文本。上文中的 hub_status 函数可自动化前三项检查。
相关推荐

WorkBuddy保姆级教程:半小时跑通自动化工作流
WorkBuddy 自动化工作流保姆级拆解:为什么大多数人只把它用成聊天软件,27 个支点课程与 12 个模板如何帮助新手半小时跑通落地实操,附使用边界提醒。

Codex云端模式详解:环境配置与适用场景
本文详细解析Codex云端模式的工作原理、环境配置步骤及适用场景,包括如何创建环境、连接GitHub仓库、设置定时任务,并对比云端与本地模式的差异,帮助开发者高效利用Codex。

Claude Code免费使用真相:三条路与一个骗局
Claude Code 免费使用是否可行?本文拆解 Pro、Max 的真实成本(含汇率与税费)、社区免费方案的技术原理与隐私代价,以及假安装包、钓鱼页面等安全陷阱,并给出访客通行证、开源贡献者计划和本地模型三条合法免费路径。