开源大模型格局:谁在主导权力天平

开源大模型正从能力、生态与许可协议三个维度重塑AI权力格局
本文系统梳理了开源大模型与闭源商业模型之间的力量消长。以Llama、Mistral为代表的开源模型在基准测试能力和私有化部署自由度上快速追赶,促使"权力天平"向开源一侧倾斜。文章将开源生态的"权力"拆解为三个层次:模型性能的领先地位、工具链与社区生态的掌控力、以及许可协议的话语权。同时,文章揭示了"开放权重"与"完全开源"之间的本质区别——多数主流模型仅开放权重而未公开训练数据与完整流程,这种"半开放"状态正引发社区关于透明度与信任的深层争论。对企业而言,开源与闭源的选择本质是成本、可控性与能力上限的动态权衡。
开源模型的权力天平正在重塑
开源大模型(Open Models)已经从边缘的实验项目,成长为足以与闭源商业模型抗衡的技术力量。围绕"当前开源模型的权力平衡"这一话题,技术社区正在展开激烈讨论——究竟是哪些机构、哪些技术路线,正在主导这场开放生态的博弈。
需要说明的是,本文所依据的原始素材信息量有限,仅有一个标题级别的讨论线索。因此以下内容更多是围绕该议题的行业观察与背景梳理,而非对某份具体报告的深度复述。
开源与闭源的力量对比
过去几年,闭源模型凭借强大的算力投入和数据壁垒,长期占据能力榜单前列。但开源阵营的追赶速度超出许多人的预期。以 Meta 的 Llama 系列、Mistral、以及来自中国的多个开源模型为代表,开源模型在多项基准测试上不断缩小与顶级闭源模型的差距。
这种追赶不仅体现在模型能力上,更体现在部署自由度上。企业可以在本地私有化部署开源模型,规避数据外流风险、降低长期调用成本,这是许多受监管行业选择开源方案的核心动因。权力天平之所以"重新平衡",正是因为开源方在"可控性"这一维度上拥有天然优势。
谁在定义开源模型的话语权
开源模型格局中的"权力"并非单一维度。它至少包含三层博弈:
模型能力的领先者
谁能持续发布性能最强、参数效率最高的开源权重,谁就掌握了技术话语权。这一层的竞争最为直观,也最容易被基准测试量化。
衡量开源模型能力的基准测试体系本身也值得关注。常见的评测集包括 MMLU(大规模多任务语言理解)、HumanEval(代码生成)、MT-Bench(多轮对话质量)等。这些基准并非中立工具——评测集的选择、权重设计,乃至"刷榜"现象,都在一定程度上影响着公众对"谁领先"的认知。部分研究者指出,某些模型在公开基准上表现亮眼,但在真实业务场景中的泛化能力并不突出。因此,技术话语权的争夺不仅是模型本身的竞争,也包括对评测标准制定权的争夺——谁定义了"好"的标准,谁就在一定程度上掌握了叙事权。
生态与工具链的掌控者
真正的护城河往往不在模型本身,而在围绕它构建的生态。推理框架、微调工具、量化方案、部署平台,谁的工具链更完善、社区更活跃,谁就能沉淀更多开发者。一个被广泛集成的模型,即便能力略逊,也可能因为生态惯性而占据主导。
许可协议的制定者
"开源"本身存在灰度。部分所谓开源模型附带商业使用限制或数据条款,这让"开放"的定义成为一场话语权争夺。许可协议的宽松程度,直接决定了模型能被多大范围地采用和二次开发。
主流开源模型的许可协议差异显著,直接影响商业落地的可行性。Meta 的 Llama 系列采用定制的 Llama Community License,允许商业使用但对月活超过 7 亿的大型平台设有额外限制;Mistral 的部分模型采用 Apache 2.0,限制最少,被认为是最接近"真正开源"的商业许可;而一些模型则引入"不得用于竞争性产品"等条款,实质上是将"开源"作为市场扩张手段而非社区建设目的。开发者和企业在选型时,需仔细核对许可协议与自身商业模式的兼容性,避免在产品规模化后陷入法律风险。
开放的边界之争
围绕"什么才算真正开源"的争论从未停止。开放权重(open weights)与完全开源(含训练数据、训练代码、完整复现路径)之间存在显著差异。多数主流"开源"模型只开放了权重,并未公开训练数据与完整流程。
这种半开放状态引发了社区的分歧:一方认为开放权重已经足以推动创新与落地;另一方则强调,缺乏可复现性的"开源"本质上仍是一种受控发布,无法真正实现透明与信任。这场边界之争,实际上决定了未来开源生态的健康程度。
开源软件领域的成熟组织 OSI(开源促进会)已于 2024 年正式发布针对 AI 的开源定义(Open Source AI Definition),要求真正意义上的开源 AI 系统必须公开足以复现模型的所有必要组件,包括训练数据的获取方式或数据本身、训练与微调代码、模型权重及推理代码。按此标准,绝大多数当前市场上被称为"开源"的主流模型——包括 Llama 系列——实际上并不符合完整定义,只能被归类为"开放权重模型"(open-weight models)。这一定义的出台,为社区争论提供了更明确的参照系,但也引发了关于"标准是否过于严苛、是否会阻碍实际创新"的新一轮讨论。
对开发者与企业的现实意义
对于开发者而言,开源模型意味着更低的入门门槛和更高的定制自由度。可以基于开源权重进行领域微调、私有部署,构建差异化应用而不必受制于单一供应商。
对企业来说,选择开源还是闭源,本质是一道关于成本、可控性与能力上限的权衡题。数据敏感、合规要求高的场景倾向开源;追求极致能力、愿意接受供应商锁定的场景则可能继续依赖闭源 API。随着开源模型能力持续逼近第一梯队,这道选择题的答案正在向开源一侧倾斜。
结语
开源模型的权力平衡是一个动态演化的过程,没有永久的赢家。技术领先者可能被后来者超越,生态掌控者需要持续投入维护,而许可协议的博弈仍将继续。对于关注 AI 技术走向的从业者而言,与其押注某一个具体模型,不如持续跟踪整个开放生态的力量流动。
(提示:本文基于社区讨论议题撰写,具体数据与排名请以各权威基准测试及官方发布为准。)
相关推荐
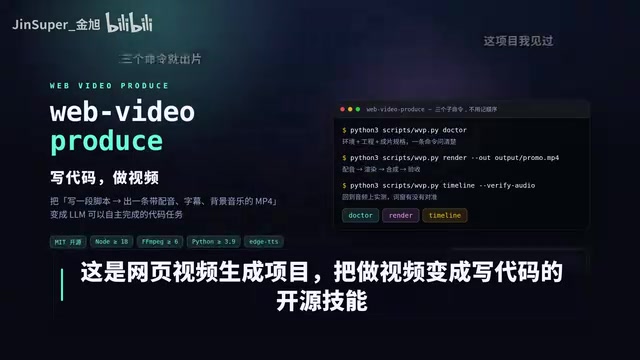
写代码就能出片:Code-to-Video开源项目全解析
web-video-produce 是一个 Code-to-Video 开源项目,用 React 和 Remotion 把做视频变成写代码:分段脚本自动生成配音、字幕、时间轴,支持 Canvas 图表、Three.js 三维、14种中文音色及自动音频验收。

LightOn OCR-3 上线 OpenDocRouter:开源 OCR 的性价比新标杆
LightOn OCR-3 现已上线 OpenDocRouter,定价每百万输入 token $0.28、输出 $1.40,约 $3.19/千页。ParseBench 测试显示其位于开源 OCR 帕累托前沿,性能接近 Gemini 3.8 flash low 且价格低约 45%。

LegalOn 如何将 Codex 成本砍半:模型分级与预算管控实战
法律科技公司 LegalOn 通过按任务匹配 Astra、Sol、Luna 等不同模型并战略性管理预算,在保持开发速度的同时将 Codex 每日成本削减约 65%。本文解析其模型分级与预算管控的实战经验。