开源复刻DLSS 5:OpenDLSS NR让RTX40系甚至浏览器都能跑
开发者开源复刻DLSS 5神经渲染网络,达到逐字节精度但距游戏实装仍有两道门槛
开发者MAAN以Vulkan重写并开源了英伟达DLSS 5的神经渲染网络,项目名为OpenDLSS NR,采用MIT协议。复刻精度极高:71个区块、FP8激活、141MB权重,不仅最终画面与原版一致,75处区块边界的中间输出也达到逐字节对齐,真正还原了原始计算逻辑而非近似替代。RTX 4070 SUPER实测1080P仅需7.8毫秒/帧,证明40系显卡运行该网络在理论上可行。项目还提供WebGPU浏览器版,AMD/Intel显卡也能运行,虽慢约27倍,但极大降低了研究门槛。然而落地仍面临两道坎:权重须从英伟达闭源运行时自行提取,游戏集成也需社区另行开发MOD,短期内普通玩家难以直接受益。
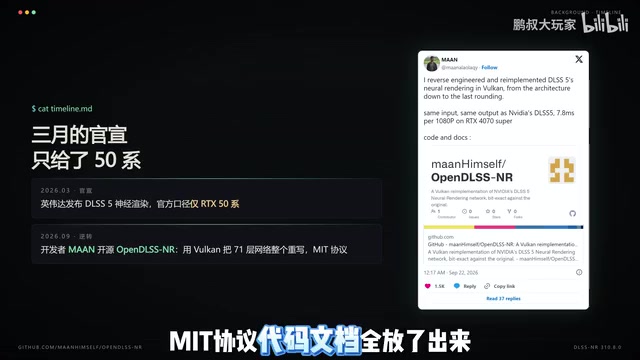
英伟达今年3月官宣DLSS 5时,把它锁定在了RTX 50系显卡上,老卡用户只能干瞪眼。没想到剧情出现反转——开发者MAAN用Vulkan把DLSS 5的神经渲染网络整个重写并开源,项目名为OpenDLSS NR,采用MIT协议,代码与文档全部公开。据B站UP主彭叔大玩家的分析,这个项目的复刻精度和跨平台能力都超出了常规预期。
复刻到了什么程度
衡量一个逆向复刻项目是否靠谱,关键不在于"能跑",而在于能否和原版的每一个中间环节对齐。这正是OpenDLSS NR最硬核的地方。
整个网络包含71个区块,使用FP8激活,全部权重约141MB。MAAN不是简单地把网络跑起来,而是从架构到舍入误差全部对齐:喂进去同样的输入,最终画面一致;更进一步,75个区块边界处的中间输出也做到了逐字节一致。
画面一致可以靠训练凑近似,但中间结果逐字节对上,意味着复刻者真正还原了原始网络的计算逻辑,而不是"看起来差不多"的替代品。这种位级一致性(bit-exact)的校验,才是这个项目真正的技术难度所在。
FP8(8位浮点数)是英伟达在Hopper和Ada Lovelace架构(即40/50系)引入的低精度数据格式,相比传统FP32和FP16,它在保持可接受精度的前提下大幅降低显存占用和计算带宽需求,专门为深度学习推理加速设计。DLSS 5采用FP8激活意味着每个神经元的中间计算值都以8位浮点形式存储和传递,这对硬件提出了特定要求——Ada架构的Tensor Core原生支持FP8运算,而老一代显卡缺乏这一硬件单元,只能模拟执行,性能会大打折扣。OpenDLSS NR在Vulkan层面实现了相同的FP8计算路径,这也正是它在原生模式下仍然依赖特定硬件的根本原因。
性能表现:71层网络还能看
复刻得再精准,性能跑不动也是空谈。目前的数据来自开发者自测,用的是RTX 4070 SUPER这张40系甜品卡。
在1080P分辨率下,一帧只需要7.8毫秒,折合约128帧的帧预算;2K分辨率为12.6毫秒;4K则是29.3毫秒。对于一个71层的神经网络来说,这样的开销已经进入可用区间。
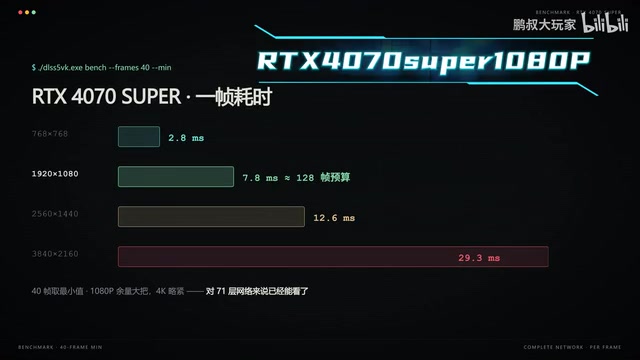
需要强调的是,这些数字是开发者自证的结果,并非第三方独立测评,实际落地到不同硬件和场景时可能有出入。但从数量级来看,40系显卡运行DLSS 5的神经渲染网络,至少在理论上不再是不可能的事。
浏览器版:跨平台的意外惊喜
更有意思的是,这个项目还做了一个浏览器版本。同样的网络,用WebGPU就能跑起来,完全不依赖TensorRT。
代价是速度慢了约27倍,但换来的是AMD、Intel显卡理论上都能运行——这是英伟达官方闭源方案永远给不了的跨平台能力。对研究者和想了解神经渲染内部机制的人来说,浏览器里就能跑一遍完整网络,门槛被大大拉低。
WebGPU是W3C制定的新一代Web图形与计算API,于2023年在主流浏览器中正式落地。与WebGL不同,WebGPU原生支持通用GPU计算(compute shader),能够将显卡的并行计算能力暴露给网页应用,而无需绑定特定厂商的驱动层(如CUDA或Metal)。将神经网络推理移植到WebGPU意味着只要浏览器支持该API,任何品牌的现代显卡——包括AMD的RDNA架构和Intel的Xe架构——都能参与计算。27倍的速度差距主要来自两方面:一是浏览器沙箱和JavaScript/WASM的调用开销,二是WebGPU的计算着色器无法像TensorRT那样针对特定GPU微架构做深度优化。对于需要理解DLSS神经渲染计算流程的研究者来说,这种可交互的浏览器环境提供了前所未有的透明度。
安装与上手:三步走
对动手能力强的用户,项目提供了相对清晰的安装流程,照着文档走三步即可。
第一步,运行脚本下载工具链;第二步,编译出主程序,自带跑分和位一致性校验功能;第三步,编译出演示渲染器,就能直接观察神经渲染的效果。
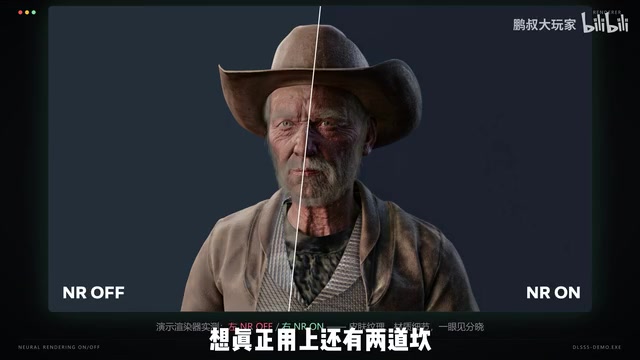
演示里神经渲染的开关对比非常直观:左边关闭、右边打开,皮肤纹理和材质细节一眼就能看出差别。这种所见即所得的对比,让神经渲染带来的画质提升不再是抽象概念。
两道坎:离装进游戏还很远
尽管技术层面已经相当惊艳,但想真正在游戏里用上,还隔着两道实实在在的坎。
第一道是权重问题。这些网络权重需要从英伟达的闭源运行时里自己提取,这是整个流程中门槛最高的一步,普通玩家很难独立完成。
第二道是游戏适配。目前项目并没有做任何游戏集成,要真正用到游戏里,得等社区把它做成MOD。这需要时间,也需要社区投入。
此外还有一道硬性门槛:硬件。原生版本依然需要特定硬件支持,AMD显卡跑不了原生版,只能通过速度慢得多的浏览器版曲线救国。
TensorRT是英伟达官方的深度学习推理优化库,DLSS的权重文件以加密或私有格式打包在驱动程序或游戏目录中,并非标准的ONNX或PyTorch格式,无法直接导出。"从闭源运行时提取"通常意味着需要在运行时内存中截获模型权重——这涉及驱动层hook、内存dump等技术手段,在某些司法管辖区可能触及逆向工程相关法律条款,也是项目本身法律风险的主要来源。MIT协议保护的是MAAN自行编写的代码,但并不能豁免用户在提取英伟达专有权重时面临的潜在问题。这也解释了为何项目选择开源架构和计算逻辑,却无法直接打包权重一并分发。
这件事的意义
把闭源网络逐字节还原并开源,最直接的受益者是研究者和MOD社区。它让原本黑箱的DLSS 5内部结构变得可研究、可复现,也为跨平台神经渲染探索提供了参考实现。
但要清醒看到,"复刻完成"和"装进游戏"之间还差着权重提取和游戏适配两大步。对手握RTX 40系的玩家来说,眼下真正能做的,无非是等英伟达官方放开支持,或者盯着社区把MOD做出来。无论哪条路,OpenDLSS NR都已经证明了一件事:闭源的技术壁垒,并非牢不可破。
相关推荐
走进Anthropic分子生物学实验室:Claude如何成为科研协作者
Anthropic公开其分子生物学实验室,展示Claude如何作为科研协作者辅助蛋白质研究。本文解读AI在充满不确定性的生物学中扮演的角色,以及AI for Science趋势下的理性期待。
AI数据中心为何如此耗电?从GPU发热到核电站的能源困局
AI数据中心为何如此耗电?本文解析服务器机房运作、GPU散热难题、集成光子学节能方案,以及到2028年美国数据中心用电或相当于八个纽约市的能源困局与破局思路。
规范驱动开发:用Spec管住AI编程助手的失控
DeepLearning.AI与JetBrains合作的规范驱动开发(SDD)课程详解:如何用宪法与功能开发循环掌控AI编程助手,消除上下文衰减、降低认知债,覆盖绿地与棕地项目,并用技能、SpecKit、ACP等标准自动化工作流。