开源决策模型Laya:4.2亿参数本地跑,33毫秒出结果

Laya是专注判断的开源小模型,本地33毫秒、零费用,专为Agent高频决策场景设计。
Laya是一个刚刚开源的轻量判断模型,英文版4.21亿参数,多语言版3.22亿参数,Apache 2.0协议可商用。它彻底放弃了文本生成能力,只做三类判断:从选项中选一个(Trace)、给状态打分(Score)、回答是非题(Yes/No)。依靠非自回归架构,单次推理在T4显卡上仅需33毫秒,批量处理可压到7.2毫秒每道,本地运行零费用。英文任务表现尚可(SNLI 0.86),多语言场景较弱,但微调后可翻倍提升。它的定位是微调基座而非成品,最适合塞进Agent判断层,让大模型专注生成、小模型负责高频取舍决策,在数据不能出网或调用成本敏感的场景中尤具价值。
一个只做判断、不生成文本的小模型
在Agent系统里,充斥着大量“要不要”“选哪个”的判断题。传统做法是把这些问题丢给云端大模型,但代价不小:上下文要出网,往返加排队动辄几百毫秒,还得按token付费。可现实是,多数判断只需要一个选项、一个分数、或一个是否结论——用大模型来干这活儿,属于杀鸡用牛刀。
刚刚开源的Laya给出了另一条路。它的定位极其克制:不聊天、不生成文本,只负责判断。给它一段状态描述,跑一次前向传播,直接吐出结构化结果。英文版4.21亿参数,多语言版3.22亿参数,上下文最高8192,全部采用Apache 2.0协议,可以直接塞进你自己的机器。
四个数字看清它的速度
Laya最吸引人的地方在于性能账。在单张T4显卡上,它单次推理仅需33毫秒,批量处理时可压到每道7.2毫秒,约合每秒86题,调用成本为0元——因为模型就跑在你本地。
为什么这么快?关键在于它是非自回归的。大模型生成文本时一个词一个词往外吐,而Laya只跑一次前向传播:输入状态、声明问题、拿到字段,没有采样和解码环节。这种设计牺牲了通用性,换来了确定性和速度。
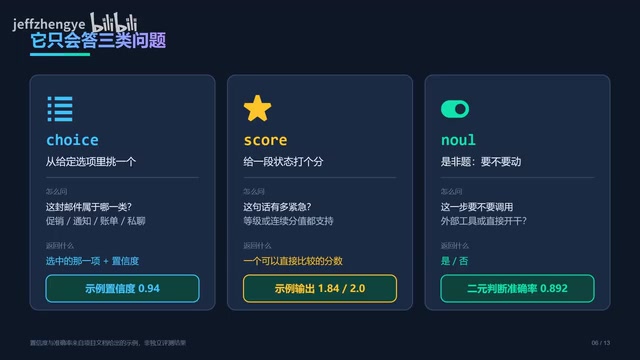
它只会答三类题:
- Trace:从多个选项里挑一个
- Score:给某个状态打分(如输出1.84)
- Yes/No:二元是非判断,准确率0.892
非自回归(Non-autoregressive)架构与传统自回归模型的核心区别在于生成方式。GPT等自回归模型在生成每个token时都依赖前面所有已生成的token,必须串行地一步步向前推进,因此生成100个词就需要100次前向传播。非自回归模型则打破了这种串行依赖——Laya的任务本身不需要生成序列,只需要输出一个分类标签或一个分数,天然适合"一次前向传播出结果"的架构。这种设计的代价是牺牲了序列生成能力,但对于判断类任务而言,这个代价完全可以接受。T4显卡是NVIDIA面向推理场景的数据中心GPU,单卡16GB显存,性价比较高,是许多中小规模部署的常用选择,以它为基准测试意味着Laya在较普通的硬件配置上即可达到上述性能。
三条路线的成本对比
把决策这一环拆开看,可以对比三种方案。云端API方案要出网、要付费、要排队;JAF(另一个判断框架)快一些,但仍是在线服务;而Laya在本地运行,33毫秒完成,零费用,开源可商用。
代价当然存在——部署、显存、微调,全都得自己扛。这不是一个开箱即用的成品,而是一个需要你投入工程成本的基座。
准确率:英文尚可,多语言吃力
性能表现要分两半来看。英文任务上,Laya表现不错,SNLI数据集达到0.86。但多语言场景明显吃力:在覆盖13种语言的MASSIVE数据集上只有0.45,Banking77也只有0.425,而同任务JAF能报到0.87。

好消息是微调空间很大。经过微调,MASSIVE可以从0.45提升到0.85,另一项任务能从0.362提到0.766——几乎翻倍。这也印证了官方的定位:Laya是一个微调基座,不是成品模型。
文中提到的几个基准数据集各有侧重:SNLI(Stanford Natural Language Inference)是自然语言推理的经典英文数据集,任务是判断两句话之间是蕴含、矛盾还是中性关系,难度中等,0.86的分数处于可用水平。MASSIVE是亚马逊发布的多语言意图识别数据集,覆盖51种语言共18个领域、60个意图类别,难度更高,尤其对非英语训练数据匮乏的模型极具挑战。Banking77专注金融客服场景,包含77个细粒度意图类别,分类粒度细,对模型的语义理解能力要求更高。Laya在后两者上的低分(0.45和0.425)主要反映出其预训练数据以英文为主的局限,而非架构本身的瓶颈,这也是微调后能大幅提升的原因。
推荐用法:给Agent加一层判断器
最合适的用法,是把Laya塞进Agent的判断层。让贵的大模型负责生成,Laya负责每一步的取舍——每秒几十次的高频判断、代码是否执行、路径如何选择,都交给它。真正低置信度的情况,再复合回人工或大模型。一句话概括:贵的生成,便宜的判断。
上手只需三步:pip安装,选好checkpoint和设备后预热常驻,然后调用predict把三类问题一起传进去,返回value和confidence,直接建你的评估流程。
在Agent系统架构中,将"生成"与"判断"解耦是一种正在被广泛实践的设计模式。典型的Agent流程包括感知、规划、执行三个环节,每个环节都充斥着大量路由决策:下一步该调用哪个工具?当前输出质量是否达标?用户意图属于哪个分支?这些问题过去统一由主模型(通常是GPT-4级别的大模型)承担,造成推理成本集中、延迟难以优化。引入专用判断器后,大模型只在真正需要生成内容时被调用,高频的分支判断则下沉到本地小模型。这种分工在延迟敏感型应用(如实时对话机器人、自动化流水线)中尤为关键,也符合"用合适的工具做合适的事"的工程原则。checkpoint预热常驻内存的做法进一步消除了每次调用的模型加载开销,是生产部署时的标准实践。
五盆冷水:这些坑得先知道
作者很坦诚地泼了五盆冷水,避免大家产生不切实际的期待。

- 会分类,不会排序:优先级排序8道题只能对4道
- 非拉丁文字基本读不了:多语言能力有明显短板
- 错了还很自信:出现过0分却给出0.952置信度的情况
- 微调前后差一倍:不微调直接用,效果大打折扣
- 长文和多选项会发飘:约4000 token的长文、超过20个选项时表现不稳

所以它适合这些场景:数据不能出网、判断频率高、手头有标注数据、想给Agent加一层判断器。而不适合:需要解释性、只做粗分类、想开箱即用替代人工、指望它写东西。
记住三件事
关于Laya,有三点值得记住:它只做判断不生成文本;33毫秒、零费用、Apache 2.0协议;它是微调基座而非成品。
在Agent架构日益复杂的今天,把判断和生成解耦、用小模型处理高频决策,是一条务实的降本路径。它不追求万能,只在“给答案”这一件事上做到快和省。
最后留个问题给你:你手上哪一环,最需要一个只给答案的判断器?
相关推荐

顶尖企业用好AI的秘诀:从实验走向成熟管理层
基于KPMG第三季度AI Pulse调查,解析用好AI的顶尖企业与实验阶段企业的关键差距:模型路由、数据主权、AI管理层、成本与价值管理,以及从效率到机会的用途转变。

付费用户因"网络滥用"遭ChatGPT封号:1分钟秒拒的申诉机制引众怒
一名付费ChatGPT用户因"网络滥用"被无预警封号,三次申诉均在一分钟内被机器人驳回,全程无人工审核。本文梳理事件经过、可能的误判原因,并剖析AI平台自动化治理的申诉困境与开发者应对建议。

OpenSOP:用Git管理多语音Agent提示词的开源方案
OpenSOP 是一个开源工具,用 Git、YAML 和 Markdown 管理多个AI语音Agent的提示词,解决提示词重复、漂移和手动同步难题,支持改动影响预览和一键回滚。