开源决策模型Laya实测:本地运行30毫秒完成分类决策

开源分类决策模型Laya可在Mac本地以毫秒级速度完成结构化决策,是闭源Jev的开源替代方案。
Laya是一款开源、可本地运行的System E分类决策模型,与闭源的Jev属于同一范式——专为结构化分类而非文本生成设计,单次决策耗时低至30-40毫秒。Jev发布后数天内,Laya即作为开放权重替代品出现,支持M系列Mac本地运行,无需依赖云端API。视频作者借助Claude Code将基于Jev API的开源演示一次性移植至Laya,实现了贪吃蛇实时决策、浏览器自动订票等场景的完全本地运行。API层面,模型接受state和question两个JSON输入,返回带置信度的离散分类结果,邮件分类等复合任务可在39毫秒内完成。作者援引卡尼曼的System 1/System 2框架解释该类模型的定位:相较于大语言模型偏向慢速推理,分类模型更接近快速直觉判断,适用于计算机自动化操作、意图识别等对延迟敏感的场景。Laya目前仍是极早期版本,精度略逊于Jev,相关性能数据有待第三方验证。
System E模型崛起:Laya对标Jev的开源尝试
一个AI在本地机器上玩贪吃蛇,每秒做出近30次决策,单次决策耗时不到30毫秒——这不是普通大语言模型能达到的速度。视频作者展示的正是一款名为Laya的新型分类决策模型,它在纯本地环境下运行,蛇身长度突破140依然从未失误,总能找到吃分的正确方向。
这类模型属于所谓的"System E"(系统式)模型,专为结构化决策与分类设计。它和近期席卷机器学习圈的Jev模型属于同一系统范式。与传统大语言模型"你问它答、输出文本"的方式不同,这类模型面向的是分类任务:给它一个带有不同类别的问题,它在亚毫秒级返回一个决策结果。
需要说明的是,视频原文对模型命名存在口误(Layer/Laya、Jeff/Jev等),且部分技术表述较为宽泛,读者应以官方文档为准。本文基于该视频单一来源整理,相关性能数据未经第三方验证。
Jev引发的应用浪潮:从超级马里奥到7秒订机票
自TypeSafe AI发布Jev以来,围绕它的实验层出不穷。视频列举了几个典型案例:
有人用它实时玩《超级马里奥兄弟》,可以清楚看到模型飞速做出"跳跃、向左、前进、暂停"等操作直至通关,凭借的正是极低的决策延迟。
在营销场景中,有人把700条销售线索喂给Jev,让它分类哪些会回复、什么是对该用户的完美信息、如何触达。
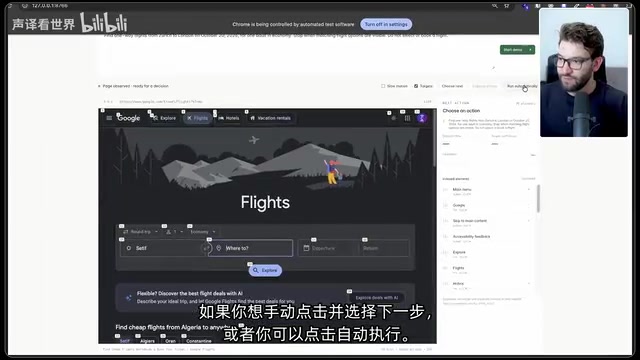
最具冲击力的是自动订票案例:Browser Use的开发者将Browser Use与Jev结合,让AI打开Google Flights、选择日期、筛选最便宜航班,整个流程仅耗时约7秒,成本约0.0039美元。这种"急速且极度廉价"的效果,正是System E模型的价值所在。
从闭源API到开源本地:Laya的核心意义
Jev本身是闭源模型,通过托管API提供服务,虽然价格便宜到几乎无感,但仍需依赖云端。Laya的出现改变了这一点——它是开源、开放权重的模型,可直接下载在本地运行。
视频提到,Laya在Jev发布后仅两到四天内就推出,能在M1 Max、M2、M3、M4等各代MacBook Pro或Mac上流畅运行。作者的做法很直接:拿来一个基于Jev API构建的开源演示项目"Jev Ultra Fast"(由Buzzerbase的Gregor构建),让Claude Code将其移植为使用Laya。
结果令作者印象深刻——Claude Code几乎一次性完成了在Jev和Laya之间切换的集成工作,得到一个完全本地、免费、不依赖任何API付费的演示。除了Laya,视频还提到另一个类似家族Cave,基于Qwen构建,提供90亿、40亿、8亿参数等多个规格,同样开源可本地运行。
"开放权重"(open weights)与"开源"(open source)是两个容易混用但含义不同的概念。开放权重指模型的参数文件可以公开下载并在本地推理,但训练代码、数据集、微调流程不一定公开;真正的开源则要求上述全部内容按照开源许可证发布,允许他人复现训练过程并进行二次开发。Meta的LLaMA系列是典型的"开放权重但非完全开源"案例。对于普通用户和应用开发者,两者的区别在实践中影响不大——能下载权重、在本地推理已经足以实现隐私保护和零API成本;但对于研究者或希望针对特定领域进行深度定制的团队,训练数据和流程的透明度至关重要。视频中对Laya的"开源"描述未明确区分这两个层面,读者在实际使用前应查阅其发布页面的具体许可证条款。
实测演示:浏览器自动化与文档识别
移植后的演示以订票为例:提示词要求"查找从苏黎世到伦敦的单程经济舱航班,仅展示匹配选项、不实际预订"。点击开始后,Laya配合Browser Use自动打开新标签页,依次选中出发地、目的地、打开日期选择器选定日期、切换为单程、点击提交查看所有航班,全程快到人眼难以跟上。

另一个演示中,提示词要求打开"关于用有限选择控制浏览器智能体"的文章,模型能推断出目标页面并自动点击打开,展现出较强的指令遵循与分类能力。作者坦言,Laya目前在精度上略逊于Jev,但作为发布仅几天的第一版,已是相当出色的起点。
API长什么样:一次分类决策的JSON输出
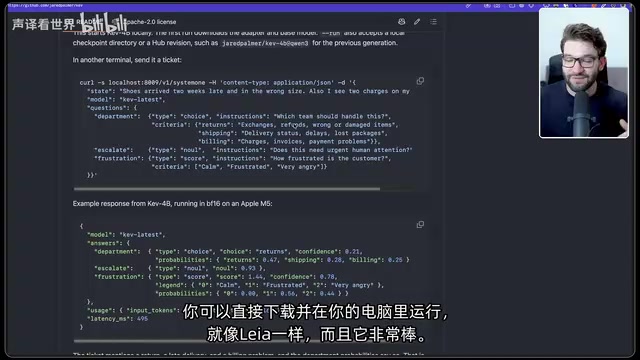
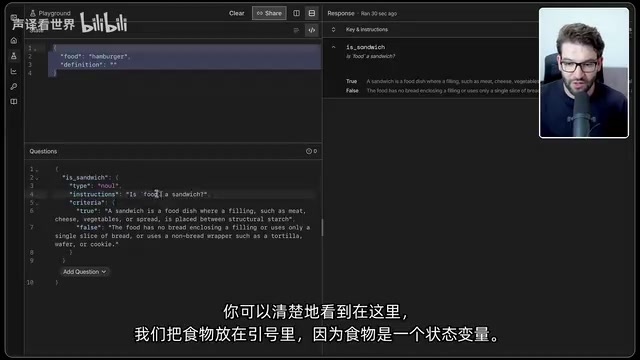
视频还演示了System E模型的API交互方式。模型接受两个输入:状态(state)和你要问的问题(question),都以JSON格式组织。
以"三明治判定"为例,把状态变量(如食物=汉堡)代入问题,再提供判定标准(如"肉类、奶酪、蔬菜或涂抹物夹在结构性面包之间为真"),模型返回结构化结果:三明治判定94%为真、6%为假。把食物换成不符合定义的对象时,结果翻转为94%为假。整个决策仅耗时93毫秒。
在邮件分类的进阶示例中,模型能根据"账单/技术/销售"标准判断邮件所属部门,同时输出紧急程度、流失风险、是否退款请求等字段,并给出置信度(如账单94%、语言英语),全部在39毫秒内完成——据视频称约为Jev实际耗时的三分之一。
置信度(confidence score)在分类模型输出中通常以概率分布的形式呈现,反映模型对各类别归属的"把握程度",但它并不等同于准确率。一个模型可以对错误答案给出95%的高置信度(称为"过度自信"),也可以在正确答案上只给出60%("欠置信")。校准良好的模型(well-calibrated model)要求:当模型说某类别概率为70%时,在大量样本中该类别确实出现约70%的概率。在实际应用中,置信度主要用于设置决策阈值——例如只有超过85%置信度的分类才自动执行,低于阈值的转交人工审核。视频中展示的94%/6%分布说明模型对该输入的判断较为确定,但单次演示无法反映模型在边界案例或对抗性输入上的置信度校准情况,在生产环境部署前需要在代表性数据集上系统评估。
System 1与System 2:模型分类背后的认知理论
视频借用《思考,快与慢》一书解释了这类模型的定位。书中区分了两种思维系统:System 1快速、直觉、情绪化,负责判断物体远近、定位声源、补全常见短语、做简单算术、读广告牌文字等;System 2则缓慢、费力、逻辑化,负责短跑起步准备、在嘈杂环境中聚焦特定人、数文本中某字母的数量等。
作者指出,当前大语言模型偏向System 2式的推理路径,甚至在"数Strawberry中有几个R"这类问题上会出错。而分类模型更接近System 1的快速直觉判断。这种类比虽然不够严谨,但为理解"为什么需要专门的快速决策模型"提供了直观视角。
丹尼尔·卡尼曼在《思考,快与慢》(Thinking, Fast and Slow,2011年)中提出的双系统理论,原本是描述人类认知的心理学框架,并非专为AI设计。System 1对应大脑的自动化、无意识加工过程,依赖模式匹配与启发式规则,几乎不消耗注意力资源;System 2则对应需要主动调用工作记忆的慢速推理,可以处理新颖问题,但容易因认知负荷过高而出错或偷懒(退化为System 1的"捷径")。将这一框架借用到AI领域时需要注意:大语言模型的"慢"来自于自回归Token生成的串行计算结构,而非真正意义上的"深度推理";分类模型的"快"则来自于将决策空间限定在离散类别上,避免了开放式生成的计算开销。两者的本质差异在于输出空间的大小与结构,而非认知深度。这个类比的实际价值在于帮助产品设计者判断:哪些业务场景适合用快速分类处理(如意图识别、实体提取、路由分发),哪些必须保留给生成式推理(如方案撰写、复杂对话)。
展望:本地化快速决策的未来
作者对这一方向表达了强烈乐观:Jev官方称在秘密模式下花了三年打磨引擎,而开源社区在五天到一周内就克隆出了竞品。他预期未来会出现更多本地运行、快速、免费开源的决策模型,应用于计算机操作自动化、语音交互等场景——设想一个用亚毫秒级速度分类"该点击什么"的模型控制你的电脑,配合语音模式实时执行指令。
对开源与开放权重爱好者而言,这确实是值得关注的趋势。不过也应保持理性:Laya仍是极早期版本,精度与稳定性有待验证,本文所述性能数据均来自单一视频演示,实际效果需以官方基准测试为准。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。