Light-Skills开源科研AI:28个技能包覆盖全流程

科研工作者的AI困境
做过科研的人都深有体会:查文献靠Google Scholar效率低下,AI助手动不动就编造引用,关掉聊天窗口上下文就断链,投稿返修时看着20多条审稿意见却无从下手。这些痛点,几乎是科研人使用通用AI工具时必然遭遇的壁障。
通用大模型擅长对话,但科研是一个高度结构化、强调可追溯性的系统工程。科研工作流的高度结构化体现在多个维度:从文献管理(DOI溯源、引用格式规范)、数据记录(实验记录本、版本控制)到同行评审(盲审制度、修回信规范),每个环节都有国际通行标准约束——例如文献引用需遵循APA、MLA或IEEE等格式规范,数据分析需满足统计显著性阈值,图表输出需达到出版机构的分辨率要求。这种多层约束与通用AI擅长的开放式生成任务存在根本冲突,从立项调研到最终成稿投稿,每个环节都有严格规范和硬性要求,而这恰恰是聊天式AI最容易失守的地方——尤其是「幻觉」问题,在学术场景下可能直接导致论文被打假。
什么是AI幻觉? 大语言模型的「幻觉」(Hallucination)是指模型以高置信度生成事实错误或凭空捏造内容的现象。研究表明,主流模型在生成学术引用时虚假引用率可达20%-60%,且虚构文献往往具有高度拟真的作者名、期刊名和年份,难以肉眼辨别。2023年多起论文因引用不存在的文献而遭撤稿的事件,直接推动了学界对AI辅助写作规范的讨论。
幻觉的根源在于语言模型的训练目标是预测下一个token的概率分布,而非检索真实事实——模型通过海量文本学习token间的统计关联,优化目标是最大化序列流畅性而非事实准确性。这意味着模型在「不知道」某个答案时,会倾向于生成听起来合理的内容而非承认无知,本质上是「流畅性优化器」而非「事实数据库」。学术引用场景下幻觉尤为危险,因为伪造文献具有高度拟真性——虚构的作者名、期刊名和年份往往符合领域惯例,人工逐条核查成本极高。
从技术层面看,目前业界应对幻觉的主流方案包括:检索增强生成(RAG,Retrieval-Augmented Generation)——在生成前先从可信语料库中检索相关文档作为上下文依据;以及工具调用(Tool Use)——让模型调用外部知识库或搜索引擎而非依赖参数记忆。Light-Skills选择「不编造」的硬约束,正是在上述技术路线之外增加的规则层保障,从系统设计层面切断幻觉发生的可能性。

一个名为 Light-Skills 的开源项目正是针对这些痛点而设计的。该项目已在GitHub获得342颗星,采用MIT协议,完全开源免费。它的核心思路不是再造一个聊天机器人,而是把科研全流程拆解成28个互相衔接的Skill,装进Claude Code和Codex这类客户端中运行。
关于运行环境 Claude Code是Anthropic推出的命令行AI编程工具,与OpenAI Codex同属「AI编程助手」赛道。这类工具能在本地文件系统和终端环境中直接执行代码、读写文件,区别于纯对话式界面。Light-Skills选择在此类客户端运行的优势在于:可直接操作用户本地数据文件与代码仓库、无需额外部署成本、天然具备文件持久化能力——这正是解决「上下文断链」问题的关键所在。值得注意的是,「上下文断链」本质上是大语言模型「上下文窗口」(Context Window)有限性的体现:模型每次对话只能处理固定长度的token序列(当前主流模型约为8K至128K tokens),会话结束后状态不保留。通过将中间产物写入本地文件系统,Light-Skills绕过了这一硬件约束,实现了跨会话的状态持久化。
从「聊天」到「技能链」:核心设计理念
Light-Skills最关键的设计转变,是放弃「问答式」交互,转而采用技能链模式。它把科研拆成28个Skill,每个Skill不是简单的Prompt,而是包含可执行脚本、可套用模板、真实范例三位一体的完整工具单元。
技能链模式脱胎于软件工程中的「微服务架构」理念:将复杂系统拆解为职责单一、边界清晰的小型服务单元,各单元通过标准接口互相调用。在AI Agent领域,这一思路演化为「工具调用链」——每个工具负责一个明确子任务,串联后完成复杂流程。Light-Skills中的Orchestrator组件采用的正是近年兴起的Orchestrator-Worker架构:编排器负责任务调度与状态管理,多个专用Worker负责实际执行,相比端到端单一大模型对话,这种架构可追溯性更强、单点失败影响更小。
这一架构范式与AutoGPT、LangChain等主流AI Agent框架的设计哲学一脉相承,核心优势体现在三个层面:故障隔离——单个Worker失败不会导致整个流程崩溃;可追溯性——每个节点的输入输出均可记录审计;模块化——不同节点可独立替换升级,甚至由不同底层模型驱动。在科研场景下,这意味着文献调研、实验设计、数据分析等环节可以分别由最适合的专用模型或脚本处理,而非强求一个通用模型包揽所有,同时任何中间环节出现问题都可精确定位而非全盘推倒重来。
具体来看,28个Skill被分为两类:
- 17个首触发Skill:覆盖调研、创新、实验、分析、成稿、图表、投稿、转化8个阶段,构成科研从立项到成果转化的主线;
- 11个常驻Skill:包括文件读取、跨会话记忆、Orchestrator编排等,负责支撑整个流程的底层运转。
这两类Skill形成完整闭环——从想法立项到论文投稿,每一步都有专用工具接管,而不是让用户在通用对话框里反复试探。这种「拆分—衔接」架构,本质上是把科研这一复杂工作流工程化,让AI在每个节点上都有明确的职责边界。
不可逾越的硬底线:不编造
在所有设计中,最值得强调的是Light-Skills划出的一条铁律:不编造文献、不造数据、不臆想出处和数据来源。
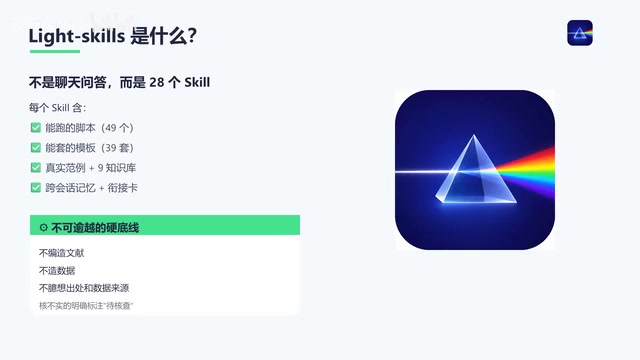
这条底线直击通用AI在科研场景中最大的软肋。学术研究的生命线是可信与可追溯,一旦引用来源虚构、数据凭空生成,轻则返修,重则面临学术不端指控。国际科研诚信领域有一套成熟的调查与惩戒机制:Retraction Watch等平台专门追踪撤稿事件并建立公开数据库,COPE(出版伦理委员会)制定了详细的学术不端处理指南,情节严重者可能面临终身禁止发表的职业处分,涉及资助方的案例还可能触发基金管理机构的独立调查程序。在这一高风险背景下,对AI生成内容的依赖若缺乏硬性约束,科研诚信风险将以指数级放大。正是在这一高风险背景下,Light-Skills把「不编造」作为不可逾越的原则写入系统,从工具层面约束AI行为,而非依赖用户事后核查。
对科研人来说,这意味着它更像一个恪守规范的科研助理,而不是天马行空的内容生成器。这种取舍在学术AI工具中至关重要——宁可少答,不可乱答。
内置知识库与代码资产:扎实的底层储备
Light-Skills能跑通全流程,靠的是背后扎实的知识与代码积累。
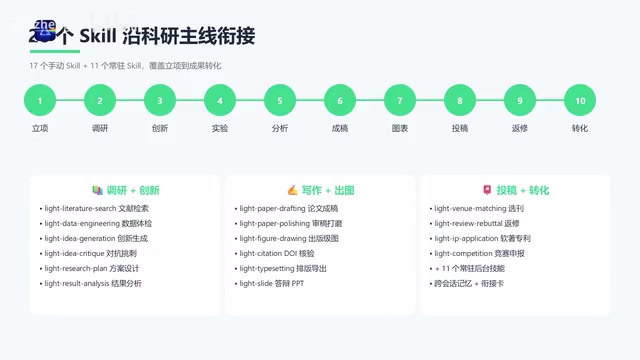
它内置了9个共享知识库、317张知识卡,涵盖期刊会议信息、论文模板、方法论、数据集、设计系统、PPT主题、科研图表等多个维度。这些知识卡相当于把科研中反复用到的规范和参考固化下来,随取随用。
这一设计在架构上近似于RAG(检索增强生成)系统中的「知识库」角色,但有一个关键差异:Light-Skills采用结构化知识卡而非向量化文本块。传统RAG系统将文档切分为固定长度的文本片段并转化为向量表示,通过余弦相似度检索相关段落,存在语义漂移和边界切割失真等问题;而结构化知识卡按领域分类索引,每张卡片对应一个明确的知识单元(如某期刊的投稿格式规范、某统计方法的适用条件),检索精度和可维护性更高。AI调用时可直接获取标准化信息而无需依赖模型参数记忆,从根本上切断了幻觉的发生链路。
在代码资产方面,Light-Skills提供了49个可执行脚本、39套模板,每个脚本均经过SIP/SKlin逐位校验,保证输出可靠性。「知识库+可执行代码+模板」的组合,让AI不只能给建议,还能直接产出符合规格的成果。
出版级科研图表:从数据到成图一键完成
图表生成是Light-Skills展示能力最直观的部分。它内置9种出版级科研图表,可自动按目标期刊规格生成。
出版级图表的标准 IEEE等主流学术出版机构要求图表分辨率不低于300DPI(每英寸点数)用于印刷,矢量图优先。低于此值的图片在纸质出版时会出现明显模糊,是论文退修的常见原因之一。Light-Skills将300DPI PNG作为默认输出规格,正是对这一行业标准的直接响应。
除分辨率外,出版级图表还需满足一系列复合要求:色彩模式方面,屏幕展示使用RGB,印刷输出需转换为CMYK以确保色彩准确还原;字体必须完整嵌入文件,避免跨平台显示时的字体替换问题;图例、坐标轴标签和标题需遵循期刊样式指南的字号和字体规定。部分高影响力期刊(如Nature、Cell系列)甚至对配色方案有无障碍设计要求,需确保色觉障碍用户(约占男性人口8%)同样可辨识图表信息,通常推荐使用ColorBrewer等经过验证的色盲友好配色方案。这些约束叠加在一起,使手动出图成为论文写作中耗时极高的环节,也是Light-Skills自动化管线价值最为集中的体现。
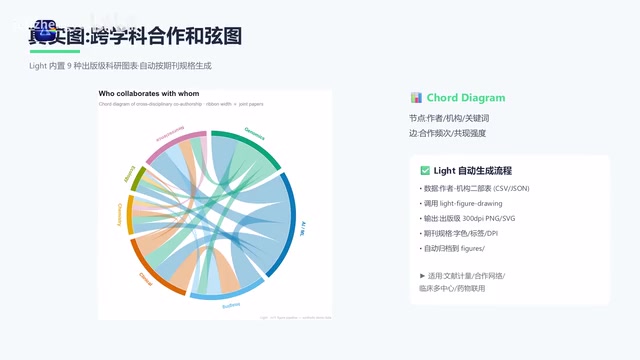
跨学科合作网络图
以作者、机构、关键词为节点,合作频次为边,Light-Skills可从数据表出发,全流程自动生成出版级300DPI的PNG图片,无需手动排版。这类图表在科学计量学(Scientometrics)和知识图谱研究中具有重要地位,通常需要借助VOSviewer、CiteSpace等专业软件手动操作,Light-Skills将其纳入自动化管线,对系统性综述和元分析类研究尤为实用。
单细胞UMAP嵌入图
针对单细胞研究,它提供完整自动化管线:数据工程、UMAP降维、聚类、出图、写图注,整个流程零代码一键完成,对生物信息领域研究者尤其省力。
UMAP与单细胞分析背景 UMAP(Uniform Manifold Approximation and Projection)是2018年由McInnes等人提出的非线性降维算法,理论基础来自黎曼几何与代数拓扑,因在保留全局结构和计算效率上显著优于此前主流的t-SNE算法,已成为单细胞RNA测序(scRNA-seq)数据可视化的事实标准。
单细胞测序技术的核心价值在于打破「平均化」困境——传统bulk RNA测序给出的是细胞群体的平均表达谱,无法区分细胞间的异质性;而scRNA-seq可以解析单个细胞的转录组状态,从而识别稀有细胞亚群、描绘细胞分化轨迹、揭示疾病状态下的细胞组成变化。这一技术在免疫学、肿瘤微环境研究和发育生物学领域已催生大量突破性发现,是近年来生命科学领域发展最迅速的技术方向之一。
标准单细胞分析流程(通常称为Scanpy或Seurat流程)涵盖质控过滤、文库大小标准化、对数变换、高变基因筛选、PCA预降维、UMAP嵌入、Leiden/Louvain图聚类、细胞类型注释及差异表达分析等十余个步骤,通常需要掌握Python(Scanpy库)或R(Seurat包)等专业工具,且每个步骤的参数调优(如UMAP的n_neighbors、min_dist参数,聚类的resolution参数)都需要相当的领域经验。Light-Skills将此流程封装为零代码管线,本质上是把领域专家的方法论固化为可复用的自动化脚本,大幅降低了计算生物学的跨学科技术门槛,使没有深厚编程背景的生物医学研究者也能完成规范化的单细胞分析,将精力集中于生物学问题本身而非技术实现细节。
医学统计图
包括差异表达火山图和Kaplan-Meier生存曲线两类最常见的医学统计图。火山图(Volcano Plot)用于可视化基因差异表达的显著性(-log10 p值)与倍数变化(log2 Fold Change)关系,横轴为表达量变化幅度,纵轴为统计显著性,左右两侧散点分别代表下调和上调基因,因整体形态酷似火山喷发而得名,是基因组学研究的标志性图表;Kaplan-Meier生存曲线(K-M曲线)则是临床研究中描述患者生存概率随时间变化的经典非参数统计工具,通常配合Log-rank检验评估两组间生存差异的显著性,在肿瘤学论文中几乎不可或缺。Light-Skills会自动对照校验规则,保证统计图可信,避免论文发表后被质疑数据造假。
这些图表能力的核心价值在于,将科研中最耗时、最讲规范的「出图」环节标准化,让研究者从繁琐的绘图调参中解放出来。
真实验证:一篇完整的6页IEEE论文
最有说服力的验证,是一篇完全用Light-Skills从头做到底的6页IEEE论文。从调研立项到最终成稿,全流程由这套技能链驱动完成,证明了它不只是概念演示,而是能够端到端交付真实科研产出的工具。
IEEE论文规范说明 IEEE(电气和电子工程师协会)成立于1963年,是全球最大的技术专业组织之一,拥有超过160个国家的40余万会员,旗下期刊和会议论文集在工程技术领域具有极高影响力。IEEE论文格式规范极为严格:双栏排版、Times New Roman 10pt正文字体、图表分辨率不低于300DPI、参考文献格式遵循IEEE Style(作者名缩写置前、期刊名使用标准缩写)等。
IEEE论文通常使用LaTeX配合官方模板(IEEEtran.cls)排版,而非Word——这一选择本身就对工具链提出了技术要求。LaTeX是基于TeX排版引擎的标记语言,因其对数学公式、参考文献管理(配合BibTeX/BibLaTeX)和版面精度控制的天然优势,在计算机科学、电子工程和物理学领域成为事实标准,但学习曲线陡峭,格式调试耗时。
能够生成符合IEEE规范的完整6页论文,意味着Light-Skills不仅处理了内容生成,还完成了格式合规这一通常需要反复人工调整的环节——包括参考文献格式的自动规范化、图表位置与尺寸的版面适配、以及章节结构对IEEE模板的符合性验证。这对投稿节奏紧张、需要快速将实验结果转化为规范文档的研究者而言,具有直接的实用价值。
对于长期被通用AI幻觉和上下文断链困扰的科研人来说,这样一个恪守底线、流程闭环、附带真实产出的开源科研AI工具,提供了一条切实可行的新路径。
总结
Light-Skills代表了AI科研工具的一种新范式:不再追求全能对话,而是把复杂工作流拆解为可衔接、可执行、有底线的技能单元。MIT开源协议与免费属性也大幅降低了上手门槛。感兴趣的研究者可在GitHub搜索「Light-Skills」直接体验。
值得指出的是,作为单一来源的介绍,其实际效果仍需更多用户在真实科研场景中验证。但「工程化拆解+不编造硬底线」的设计方向,已为整个AI科研工具赛道提供了值得借鉴的思路。
核心要点
核心要点
核心要点
相关推荐
B站最细Codex保姆级攻略:从安装到实战全解析
B站最细Codex保姆级攻略:从应用商店安装到日常工作模式配置,用真实咖啡馆项目演示文件整理、数据提取、仪表盘制作等实战任务,教你用计划模式和桌面宠物高效使用Codex。

体渲染中的外观补偿:为何RGB准确无法保证密度正确
体渲染研究揭示:完美复现外部RGB视图的体数据仍可能存在密度错误。外观补偿机制使中心密度翻倍、L2误差超14.52%时外部射线仍不变,密度恢复依赖外观容量、空间分辨率与测量设计。

TMLE与AIPW的样本分割选择:交叉拟合与重复分割的影响
一项TMLE与AIPW模拟研究发现,样本分割方式显著影响区间覆盖率:样本内拟合倾向得分可使覆盖率跌至0.12-0.48,双nuisance交叉拟合则恢复至0.91-1.00;近正性下AIPW优于未加权TMLE,重复划分降低划分依赖但使区间更保守。