GLM-5.2引发媒体恐慌:开源AI的安全争议与治理困境

一场围绕开源AI的舆论博弈
近日,Reddit 社区 r/LocalLLaMA 上一篇标题为《GLM-5.2 fearmongering in the press》的帖子引发广泛讨论。r/LocalLLaMA 是 Reddit 上专注于本地运行大型语言模型的核心社区,拥有超过10万活跃成员,聚集了大量AI研究人员、独立开发者和技术爱好者,是开源AI领域舆论最为活跃的讨论场所之一——社区名称本身源自 Meta 于2023年发布的同名开源模型,其权重泄露事件被视为开源AI运动的重要转折点,彻底打破了"前沿AI只属于大厂"的格局。发帖用户 ttkciar 转发了科技媒体 Futurism 的一篇报道,并对当前媒体渲染开源AI"威胁论"的趋势表达了明确担忧。这场讨论表面上是某个具体模型的争议,实则触及开源AI领域一个长期存在的核心矛盾:开放性与安全性之间的根本张力。
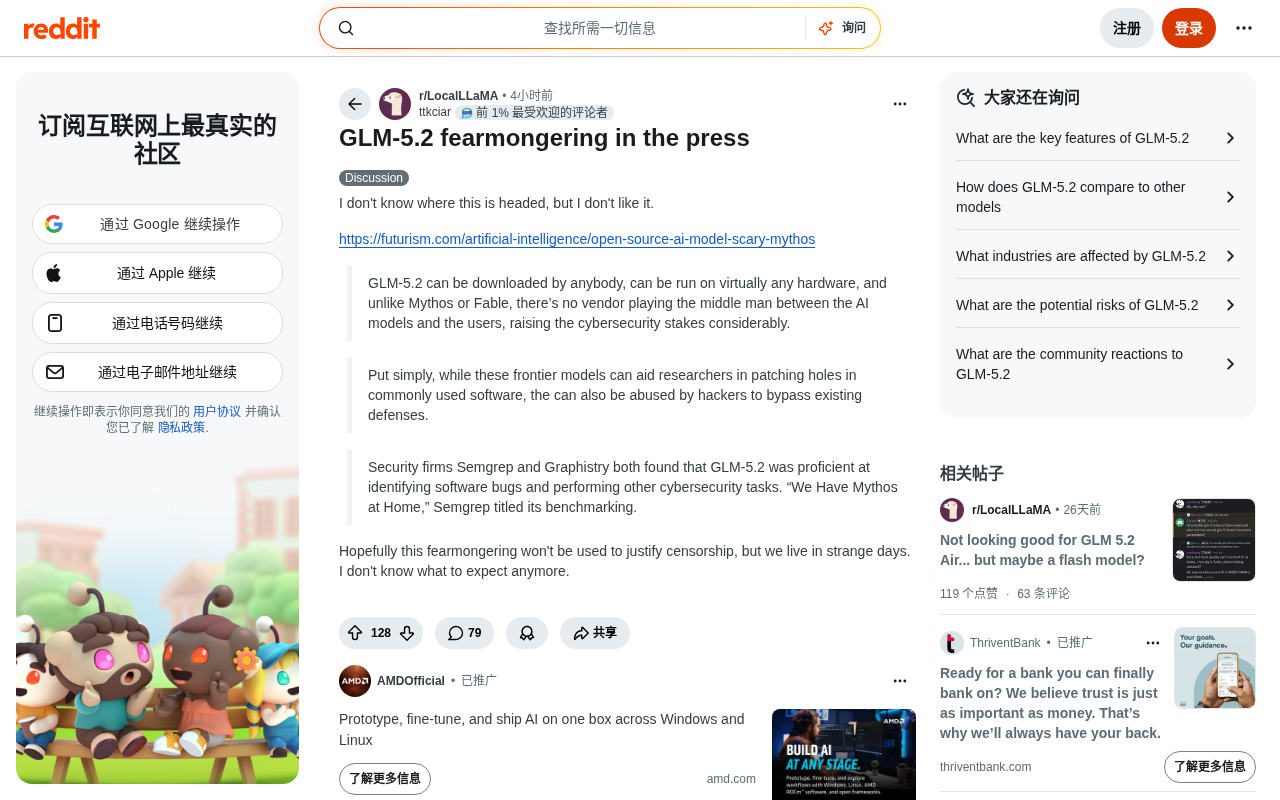
发帖者的态度颇具代表性——"我不知道这会走向何方,但我不喜欢这样。"这句话背后,是开源社区对潜在监管收紧和内容审查的深层焦虑。在AI能力快速跃升的当下,每一次"安全恐慌"都可能成为限制开源模型自由流通的现实理由。
GLM-5.2 究竟被指控了什么
GLM(General Language Model)是由清华大学与智谱AI联合研发的开源大语言模型系列,以双语(中英文)能力和开放权重著称。随着版本迭代,GLM系列在代码生成、数学推理和指令跟随等基准测试上持续提升,逐渐被视为能够与国际顶级闭源模型竞争的开源替代方案之一。根据 Futurism 的报道,媒体对 GLM-5.2 的核心担忧集中在以下几个层面。首先是极低的使用门槛:任何人都可以下载该模型,并在几乎任何消费级硬件上本地运行。这与那些需要通过厂商 API 付费访问的闭源前沿模型(报道中以 Mythos、Fable 等代号指代)形成了鲜明对比。
没有"中间人"的双刃剑
报道特别强调,开源模型的使用者与模型之间"没有厂商充当中间人"。在闭源模式下,厂商可以通过 API 层实时监控、过滤、限制潜在的恶意请求;而完全开源的模型一旦被下载至本地,便脱离了任何形式的外部管控。
从网络安全角度看,这一特性确实是把双刃剑:
- 正面价值:前沿开源模型能帮助安全研究人员高效发现并修补常用软件中的漏洞,整体提升防御能力。
- 潜在风险:同样的能力也可能被恶意行为者用于绕过现有防御机制、寻找可利用的攻击面。
安全公司的基准测试结论
这一担忧并非纯粹的媒体臆测,而有实测数据支撑。报道援引了安全公司 Semgrep 和 Graphistry 的测试结果——两者均发现 GLM-5.2 在识别软件缺陷和执行网络安全任务方面表现突出。值得一提的是,Semgrep 是业界广泛使用的开源静态代码分析工具,支持30余种编程语言,被 Dropbox、Snowflake 等主流科技公司用于安全代码审查流程——当这样一家专注安全工具的公司将 AI 模型引入测试框架,其结论具有相当的专业可信度。Semgrep 甚至将其测试报告戏称为《We Have Mythos at Home》(我们家里就有 Mythos),暗示这款开源模型的实际能力已经逼近顶级闭源模型。
这个带有调侃意味的标题,恰恰点出了问题的核心:当开源大模型的能力真正追平闭源前沿模型时,过去用于论证"闭源更安全"的诸多理由,都将面临根本性的重新审视。
恐慌叙事背后的真正问题
围绕 GLM-5.2 的讨论,本质上是 AI 治理领域一个反复出现议题的最新呈现。每当一款强大的开源模型发布,类似的"双重用途"(dual-use)争议便会随之浮现。
双重用途概念源自核技术和生物技术领域的监管实践,指同一项技术或知识既可用于民用/防御目的,也可被用于破坏性用途。AI领域的双重用途争议并非新鲜议题:早在2018年,OpenAI 在发布 GPT-2 时就以"能力过强可能被滥用"为由分阶段限制模型权重公开,此举引发了延续至今的争议——批评者认为,这种"安全剧场"(Security Theater)既无法真正阻止有能力的攻击者,又人为制造了能力壁垒,本质上服务于商业利益。
能力平权与风险平权
开源 AI 最核心的价值在于能力平权——让研究者、独立开发者和小型团队都能使用与大厂同等水平的工具,而不必受制于 API 定价、访问配额或商业审查。然而硬币的另一面是,同样的能力也会同等"平权"给潜在的恶意行为者。
但需要冷静看待的是:网络安全领域本就是一个"进攻与防御"长期并存的生态。安全研究人员使用的漏洞挖掘工具,本身也可能被攻击者掌握——这并不是 AI 时代才出现的新问题。真正的关键在于,防御方能否同等受益于这些工具的赋能。如果 GLM-5.2 既能帮助攻击者找漏洞,也能帮助防御者更快修补漏洞,其净影响未必是负面的。
对监管收紧的深层担忧
发帖者最大的隐忧是:"希望这种恐慌叙事不会被用来为审查制度背书。"这种担忧并非多余。近年来围绕开源AI权重公开发布的政策争议持续升温:2023年欧盟《AI法案》谈判中,是否对开源模型施加与闭源模型相同的监管义务曾引发激烈讨论,最终立法者给予开源模型一定豁免;美国拜登政府的AI行政令要求超过特定算力阈值的模型训练向政府报备;RAND等智库报告更直接探讨了"是否应限制前沿开源模型发布"的问题。一旦"开源模型等于不可控安全威胁"的认知在公众层面固化,便可能催生要求限制模型权重公开发布的政策压力。
对开源社区而言,这是存在性威胁:如果开源前沿模型的发布本身被视为需要许可乃至禁止的行为,整个开源 AI 生态的基础都将随之动摇。
如何理性看待这场争议
在相关信息尚不完整的情况下(你可能没注意到,原始讨论中 GLM-5.2 的部分细节可能与实际情况存在出入,读者应以官方来源为准),我们至少可以得出几点稳妥的判断。
第一,能力强大本身不等于危险。 一款能识别软件漏洞的模型,其价值取决于谁在使用、如何使用。将模型能力与滥用风险简单画等号,是恐慌叙事最常见的逻辑陷阱。
第二,闭源并不天然更安全。 厂商中间层确实提供了一定的管控能力,但也带来了不透明、单点故障和商业审查等代价。开源的透明性反而让安全社区能够更充分地审计和研究模型行为。
第三,监管应基于行为而非工具。 真正需要警惕的是恶意使用行为本身,而非工具的存在。若因工具可能被滥用就限制其开放,几乎所有强大的技术都将面临同样的命运。
这场围绕 GLM-5.2 的舆论博弈,或许只是开源 AI 浪潮中一个小小的插曲,但它折射出的核心问题——如何在开放创新与安全治理之间找到可持续的平衡——将在未来很长一段时间内持续困扰整个行业。正如发帖者所言,"我们生活在奇怪的时代",而这种奇怪,恰恰源于技术进步的速度已经超越了社会共识形成的速度。
核心要点
相关推荐
Vibe Coding是什么?程序员必须掌握的AI编程能力
Vibe Coding(AI编程)到底是什么?本文解析AI编程如何重塑研发流程、为何传统程序员面临淘汰、Cursor与Claude Code两大工具,以及程序员、PM、运营等岗位为何都该掌握这项能力。
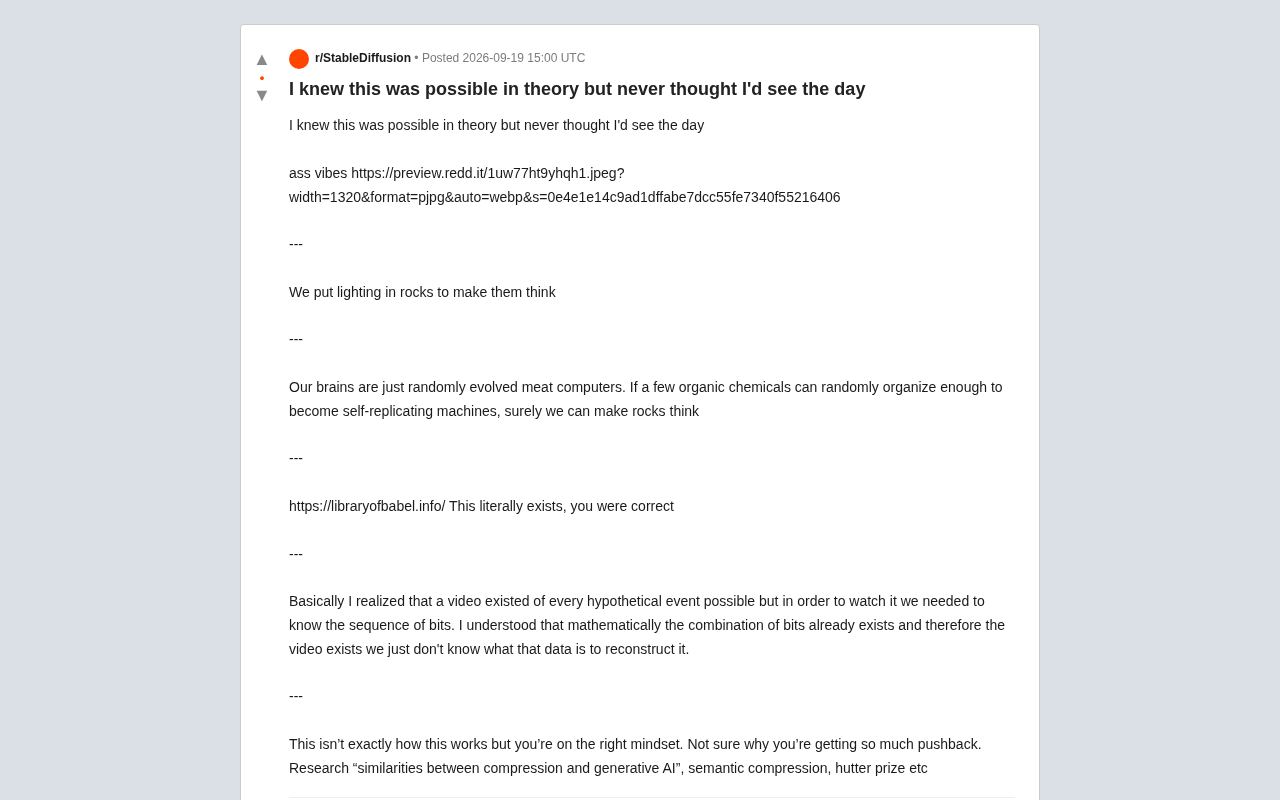
让石头思考:生成式AI与信息压缩的哲学思考
从Reddit热帖「让石头思考」出发,探讨生成式AI的信息论本质:为何压缩等价于理解,巴别图书馆式的可能性空间思辨,以及语义压缩、Hutter Prize与AI原理的深层联系。
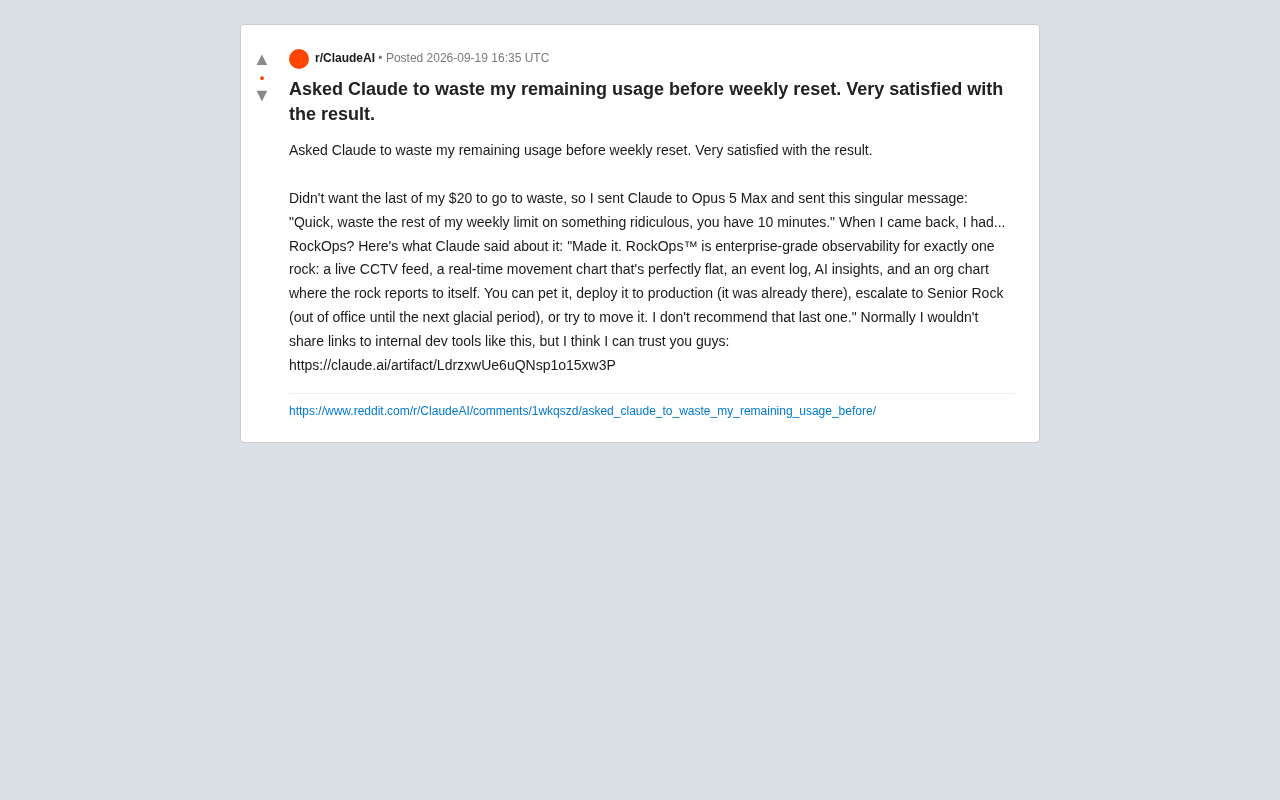
让Claude"浪费"额度:一场AI创造力的意外实验
一位Reddit用户让Claude用剩余额度"做件荒唐的事",结果AI生成了监控一块石头的企业级平台RockOps。本文分析这一趣味案例背后的AI创造力与产品设计能力。